2026年9月12日 星期六
121 个 API 端点,一个 AI Agent:为什么 1:1 工具映射在生产环境行不通

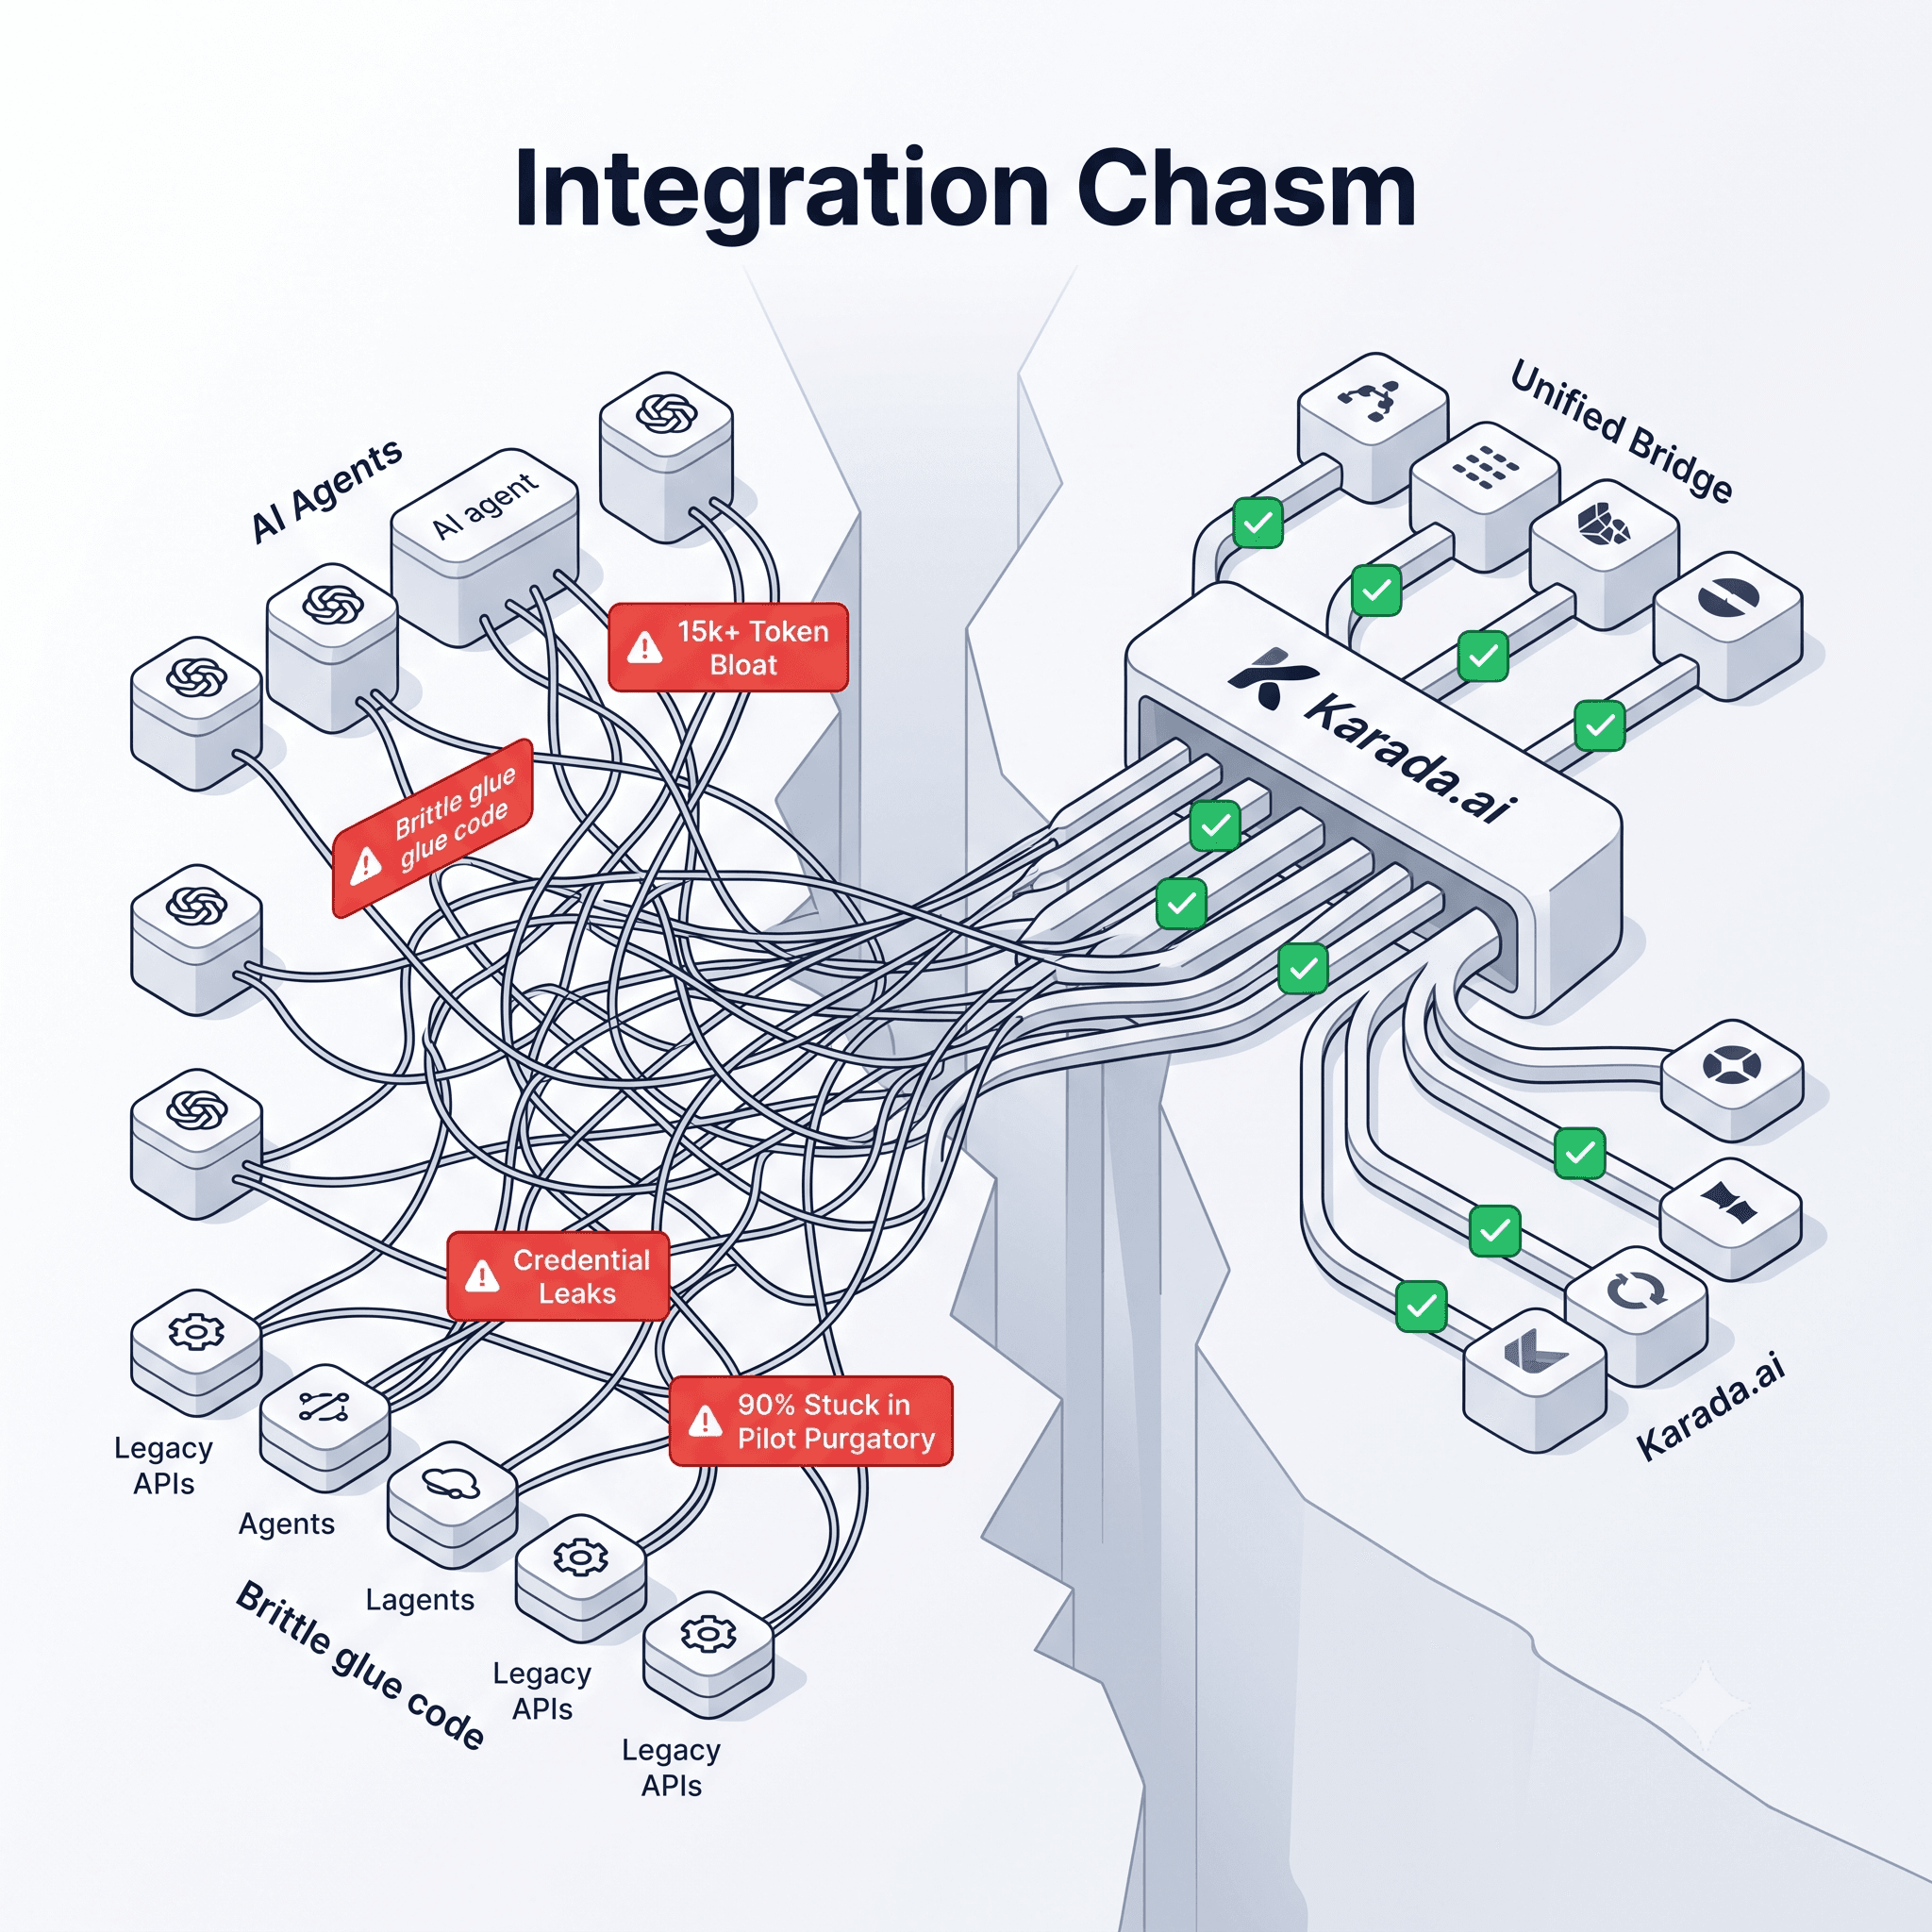
121 个 API 端点,一个 AI Agent,彻底乱套。
最近我和 James Lewis(Faculty 首席云工程师)聊了一次,他讲到一个残酷的架构难题:任何企业想把软件改造成「AI 就绪」,都会撞上同样的坑。
他们有一个企业平台,对外暴露了 121 个独立的 HTTP 端点。最初的想法很直接:把这 121 个端点一对一地全变成 AI Agent 的工具。
1:1 映射为何一上生产就崩
把原始 CRUD REST 端点直接暴露给大语言模型(LLM),会在三个维度上留下难以收拾的故障面:
-
每次提示浪费 15000+ Token:光是描述 121 个工具的结构定义(schema)、查询参数和类型,就吃掉超过 15000 个 token,模型还没开始推理,延迟就已经飙上去了,上下文预算也被掏空。
-
严重的参数幻觉:面对几十个功能重叠的端点(比如 search、filter、list),模型经常在不同但相似的路由之间胡乱编造查询参数。
-
脆弱的维护面(O(N) 漂移):上游 API 只要来个小版本升级,或者改个参数名,Agent 就会在 121 个工具接口上悄无声息地崩掉。
7 个动词的「防爆盾」架构
与其维护 121 个脆弱的适配器,James 干脆砍掉所有独立工具,全部收敛成 7 个高层的复合「动词」。
「这套东西之所以能扛住,是因为这 7 个动词是唯一接触 API 的代码,所以漂移只会落在 7 个调用点上,而不是 121 个。」
团队把复合工具当成防爆盾,把 API 漂移的风险敞口砍掉了 94% 以上。LLM 不再去应付底层的 CRUD 语义,而是直接操作高层的业务能力。
用契约测试代替提示词比对
很多团队想靠大语言模型(LLM)审查 git diff 和更新日志来发现 API 漂移。但只对比代码差异,只能发现文档里写明的语法变化,抓不到运行时的语义变动,比如意料之外的 4xx 状态码,或者请求头要求被悄悄改了。
生产环境里更可靠的做法是:针对每个操作(verb)跑自动化契约测试,打到一次性的临时沙箱实例上,确保 schema 校验和传输载荷跟真实 API 行为一致。
动作级权限范围与最小权限
把 120 个接口压缩成组合操作后,最大的架构难题是落实最小权限,让「读 + 写」打包在一起时不留下安全盲区。在传输层做编译期 schema 校验和动作级权限范围(action-level scopes),才能让 AI 代理(agent)的执行既可预测又安全。
生产环境 AI 代理工具的实施要点
-
别再一对一映射:大语言模型不需要细颗粒度的增删改查接口,它要的是高层、按能力划分的操作。
-
爆炸半径防护架构:把成百上千个微服务接口收敛成 5 到 7 个核心操作,把漂移暴露面降低 90% 以上。
-
契约测试优先于提示词审查:针对每个操作,对沙箱实例跑自动化契约测试,而不是靠人工审查提示词。