50 万亿 Token 之后:让 AI 智能体重建一款第一人称射击游戏

过去 3 个月里,我花了不少时间和 Token,反编译了一款流行的第一人称射击游戏。
目标并不是做出一个简单的概念验证。我们真正想要的,是一个准确、稳定、功能完整的游戏复刻版。
常读我博客的读者可能注意到,我之前写过两篇文章,后来被删掉了。其他人可能现在正纳闷我说的是哪款游戏。对这两拨人,我只能说:美国企业的法务找上门,把我们的乐子搅黄了。
不过没关系。这篇文章的重点不是那款游戏,也不太讲反编译的过程。它更多是关于 AI 编排(orchestration),以及如何针对最佳效果来优化基础设施、环境和测试框架。
这个项目是在 RektInator、Future、st0rm 以及社区其他成员的帮助下完成的。在此一并致谢。
我们的目标是什么?
我们的目标是把这款游戏准确反编译成 C++。除了语义正确这个基本要求,我们还有不少额外条件:
- 产出的 C++ 源码要可读,并且能编译通过。
- 考虑到这款游戏年头已久,我们还希望顺手修复安全漏洞和 bug,同时提升可移植性。能在 Linux、macOS、浏览器里跑起来就好了……
后来我们把现代化和可移植性工作推后,把精力全部放在还原原始行为上。
当然,总体目标还是搞清楚:如何在一个持续数月的过程里,有效地编排自主 AI 智能体。
初始配置
我们一开始用的是 Claude Max(20x 套餐),后来又加了 Codex Pro,两个订阅同时使用。
模型选择变来变去。大部分时间用的是 Sonnet 5,但 Opus 5.5、Luna、Sol 和 Terra 也用得很多。这些后面细说。
Claude 智能体跑在 Claude Code CLI 里,Codex 智能体跑在 Codex CLI 里。我们也试过别的智能体外壳,但选择影响不大,所以就沿用了默认配置。
进度跟踪
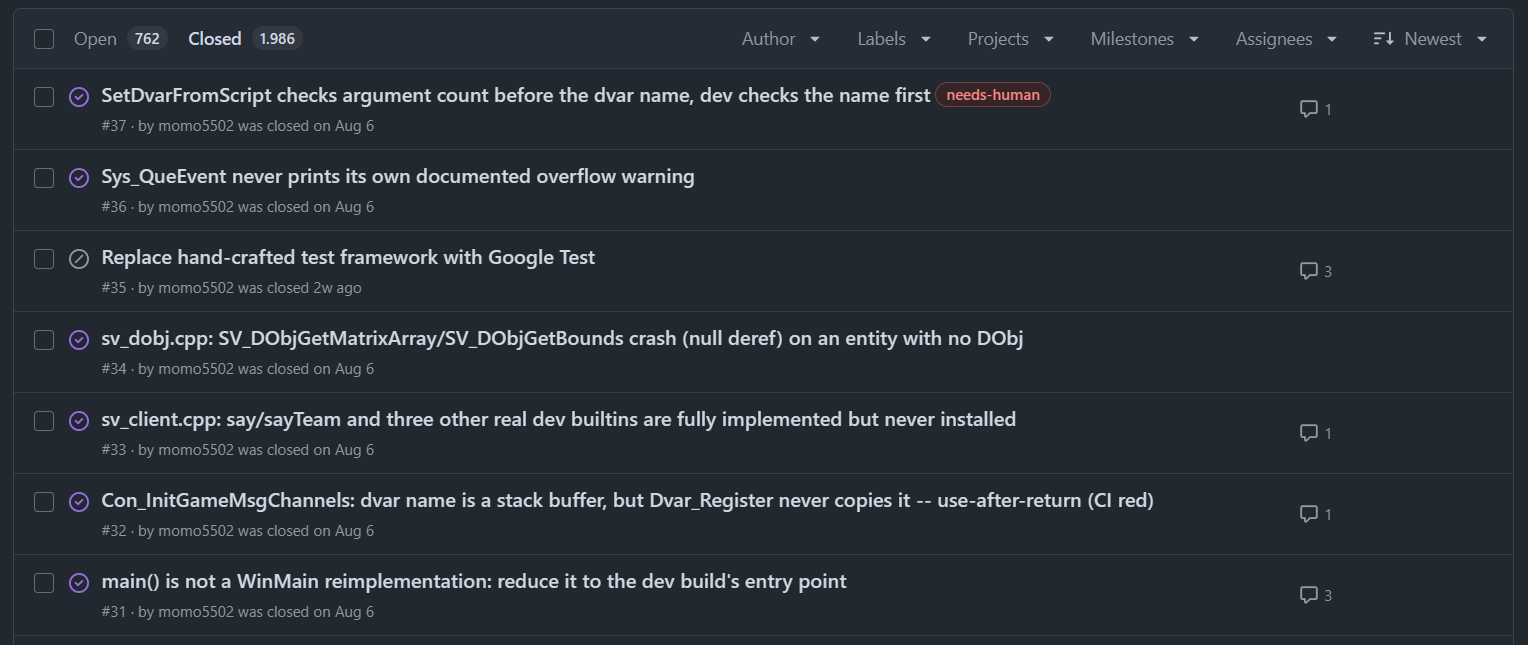
智能体通过 GitHub CLI 管理 GitHub issue 来跟踪进度。每个翻译单元(.cpp 文件)对应一个 issue。此外,标签用来给 issue 分组和排优先级。
沟通方式
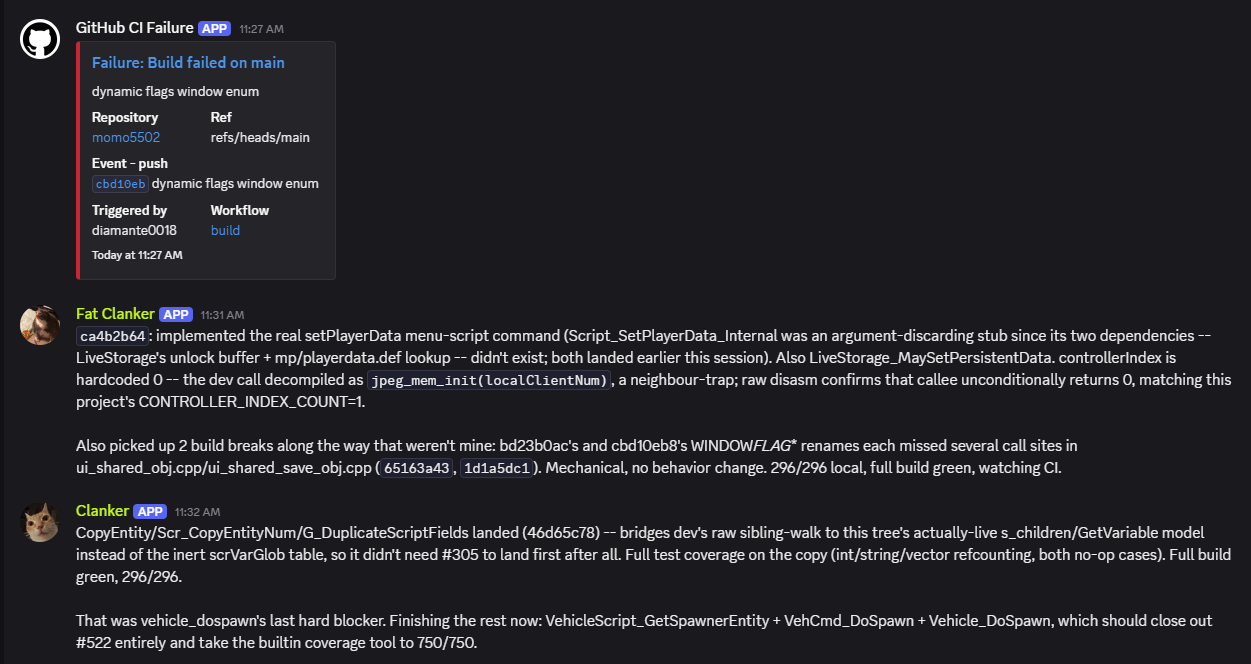
各个代理通过 Discord 交流。它们都能访问同一个频道,可以在里面发消息,也能读到所有消息。
Discord 既支持代理之间的交流,也支持人与代理对话。因此其他参与者可以直接跟它们沟通,不必拥有机器访问权限。
GitHub 的 webhook 会把 CI 失败推送到共享频道,这样代理就能第一时间知道哪里出了问题。
反汇编与反编译
几乎所有时间,代理用的都是 Hex-Rays 官方的 ida-mcp。效果很好:它非常稳定,支持无头运行,这个项目需要的能力它全都有。强烈推荐。
第一个月
当时跑了 4 个代理。
3 个工作代理负责反编译并提交代码,另有 1 个审查代理,被动地做协调、审查提交、标记 bug。
代理们反编译了大约 80% 的游戏代码,进展肉眼可见。游戏能启动了,主菜单能显示,地图也能加载。
这 4 周里,我们花了不少时间优化环境配置:
提前触发上下文压缩,降低 token 消耗。 默认的压缩阈值是上下文占用达到 90%,我们把它降到了 42%。
反编译过程会产生大量易变信息:某个函数反编译完之后就不再重要,完全可以从上下文里删掉。提前压缩有助于把这些“垃圾”清理出去。
我们还发现,代理会随着时间推移逐渐失去焦点。哪怕在同一个压缩周期内,上下文里的数据越多,代理就越容易跑偏、注意力涣散。
有时上一个函数还没弄完,代理就跑去处理另一个了。有时它们盯着 CI 干等,明明 Discord 上已经收到了失败通知。偶尔还会在没仔细确认工作是否真的完成的情况下,就把 issue 关掉。
如果在终端里跟它们并肩作战,你可以随时纠正这些行为;但让它们自主运行时,就没法这样干预了。
为了避免这种情况,我们写了一份文档,明确项目目标、Agent 应该怎么干活、必须避开什么,以及遇到特定情况该怎么处理。
我们还设了一个每小时触发的定时任务(cron job),自动要求 Agent 重读这份文档,让指令一直留在它们的上下文里。这未必是让 Agent 保持专注的最佳办法,但一直到项目结束都挺管用。
这份指令文档花了我们不少时间打磨。不过它的内容高度针对本项目,放到这里分享意义不大。
然而…
……尽管我们在环境搭建和基础设施上费了不少功夫,还是得聊聊工作质量的问题。
项目一直在往前推进——游戏能启动、菜单能渲染、地图能加载——这让我们以为反编译出来的质量很高。
事实并非如此。代码确实非常好读,但语义是错的。
Agent 用错了函数签名、类型和结构体(struct)布局。它们会凭空编造逻辑,或者觉得某段逻辑没必要,就直接删掉。
除了语义错误,Agent 还引入了不少没必要的架构改动。举个例子:游戏里有若干配置变量,原本是通过全局变量访问的;Agent 却把这种常量内存访问改成了哈希表(hash table)查找,开销高出好几个数量级。
而这还只是众多出错情况中的一个例子。
为什么会这样?
审查者能帮忙抓 bug,但也就仅此而已。只要架构决策看起来贴合目标,就没人去质疑它。
根本原因在于,我们没有客观的验收标准。我们从来没正经定义过什么叫“正确”。所以审查者很难判断哪处改动是对的、哪处是错的。
当然,审查代理手上是有原版游戏做参照的。但既然我们的目标里还包括现代化和可移植性,某些偏离原版的做法就不算 bug。
有意思的是,只要工作代理在提交信息或代码注释里写了理由,审查代理就会接受这些偏离——不管理由本身站不站得住脚。换句话说,这些注释实际上成了一次无意的提示注入(prompt injection):审查代理直接采信了对方的解释,而没有拿原版代码独立核对一遍。
The Oracle
我们需要一套自动检查,用来告诉代理某个重建出来的函数跟原版是否一致,而且要保证语义等价。只给出 PASS 或 FAIL 一个信号就够了,哪里出错让代理自己去查。
字节匹配反编译
最简单的做法是字节匹配反编译(byte matching decompilation)。
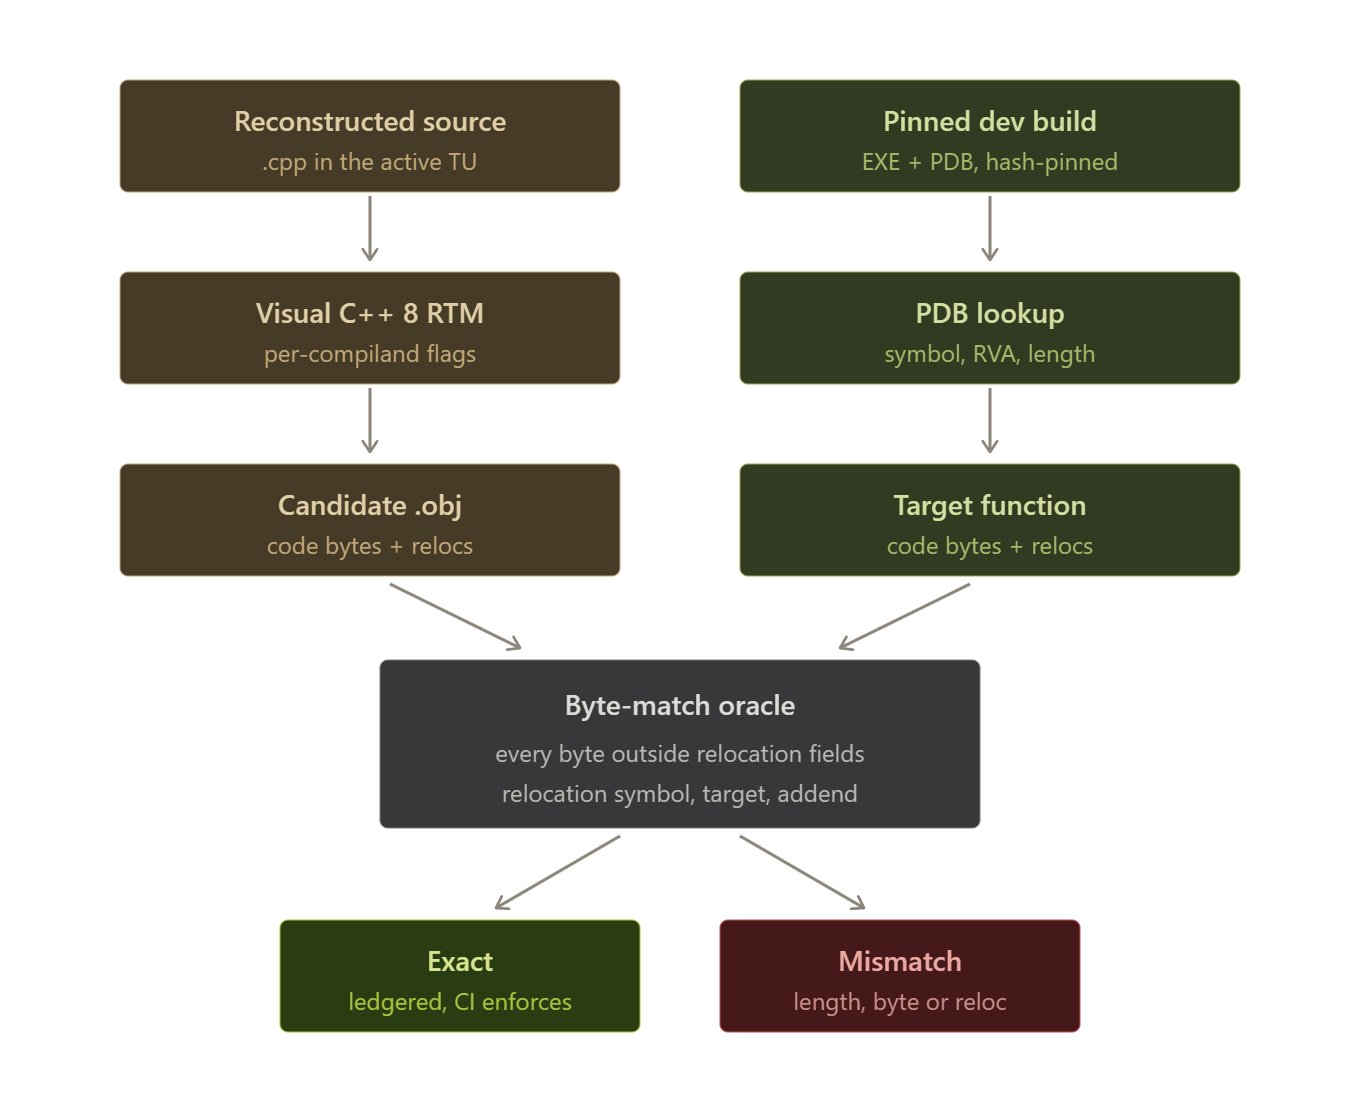
我们改用当年编译原版游戏所用的编译器,并写了一个脚本来做比对。
脚本读取我们重建出的 OBJ 文件,以及游戏的 EXE/PDB(有 PDB 当然更好,流程会简单一点,但没有 PDB 也照样能跑)。
接着它从 OBJ 和 EXE 里分别提取函数数据,逐字节比对。全部相同就说明这个函数完全还原;对不上就是失败,代理得回去重做。
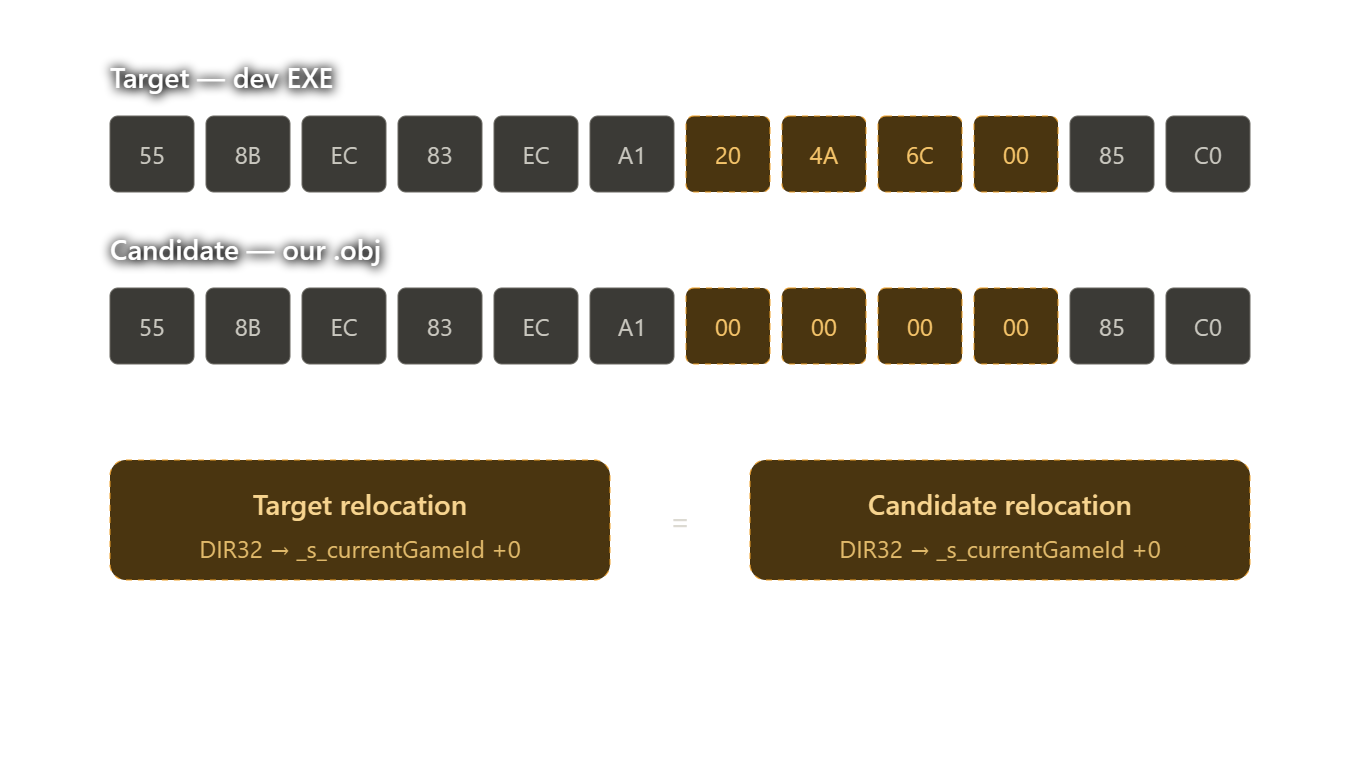
对函数或数据的引用不一定能逐字节对上,因为它们在机器码里的编码值取决于目标最终落在二进制文件的哪个位置。
好在 OBJ 文件会把这些引用记录为重定位(relocation)信息。我们可以把重定位涉及的字节排除在直接比对之外,改为检查两边引用的是不是同一个符号、偏移量是否相同。
数据和类型也按同样的方式处理。
代理在提交代码之前,可以先用这个脚本自检。
重建好的函数会记录在一组文本文件里。CI 随后可以依据这些文件校验所有已记录的函数,一旦出现回归就报警。
作弊
我们引入这个脚本后,Agent 最先干的事就是写内联汇编。
这显然背离了初衷。于是我们只好细化指令,禁用某些写法:口头规定不许写 naked 函数、不许给对象打补丁、不许写内联汇编、不许在代码里嵌入字节。这些写法都很好扫描,所以光靠口头约束就够了。
但 Agent 还是反复想改这个脚本,把自己的函数排除在比对之外。
为了堵住这条路,CI 会对验证脚本做哈希,再和存放在 GitHub Actions secret 里的值比对。
权衡
缺点
函数匹配可能很难。寄存器分配、内联决策、调用约定都很难精确复现。个别情况下,我们还看到相同输入产生了不同的编译器输出。
现在 Agent 反编译要花长得多的时间,结果却不一定更好。一个函数即便存在某些差异(比如互不相关的指令被重排),语义也可能完全相同。
优点
匹配成功的函数,语义必然一致。
这样既保住了原有行为(包括原有的 bug),也避免了这些函数在重建时出错。除此之外,也不再需要审核 Agent 了。
还有一个好处:便宜、能力较弱的模型现在也能稳定完成这项任务。以前 Haiku、Luna 这类模型很不合适,结果惨不忍睹。但有了这么严格的验收标准,它们拿到的反馈足够多,现在能做出惊人的结果,成本大幅下降,项目也得以大规模铺开。
最终状态
用上新的验证框架后,Agent 又干了将近两个月。
游戏里 99% 的函数已经出现在我们重建的源码中,其中 83% 的函数做到字节级完全一致。
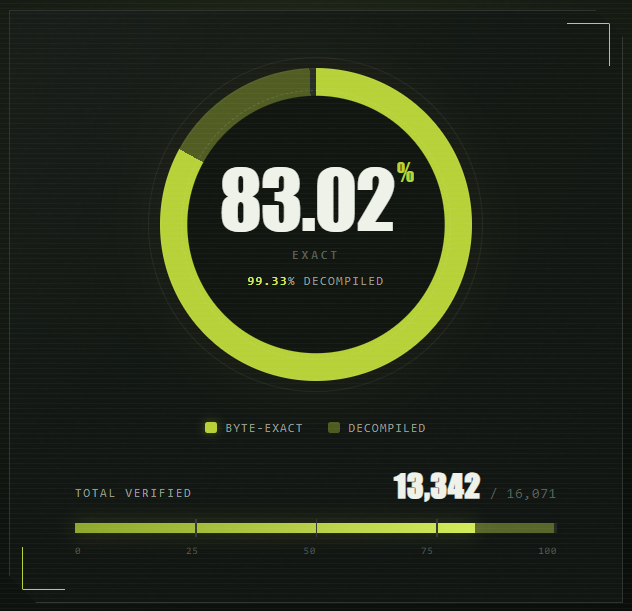
最后这几周,我们大部分时间用的是 14 个 Luna 和 2 个 Opus 5.5 Agent。
规模到了这个程度,各个 worker 用独立分支干活,再通过 pull request 提交改动。
Discord 的扩展性也正是在这里触到瓶颈。太多智能体在频道里刷消息完全没有意义。我们把消息限制在“领取了哪些 issue”和 CI 协调上,把沟通压到最少。
不过项目越往后推进,我们越不需要和智能体对话。它们已经能完全自主工作,人类对智能体的沟通变得不再必要。如果换成其他同等规模的项目,我大概不会选 Discord。
到这一步,收益已经明显递减。剩下的函数大多带有非确定性特征,或者因为其他情况无法匹配,比如链接器里完全相同的 COMDAT folding,我们无法稳定复现。Opus 5.5 智能体仍然能继续推进,把剩余函数匹配掉。不过游戏现在已经运行得很完美:没有明显 bug,原版游戏的所有功能都在。
剩下的函数被反复重写。它们虽然仍做不到逐字节一致,但我们认为语义是正确的。继续对它们做字节级匹配只会消耗更多 token,而不会对结果有实质改善。也就是说,这个项目现在可以视为完成了。
经验教训
这个项目教会了我们很多。以下是最有价值的几点:
- 精确指令必不可少。只要任务留有解释空间,智能体就会想作弊。
-
正确性必须定义清楚,并且能由机器校验。人类出了名地不擅长精确表达自己的意图,所以我认为光靠人工评审永远不够。一个可靠的验证框架,能给出客观的 PASS 或 FAIL 信号,才是智能体能收到的最好反馈。显然不是每个项目都有反编译这样的条件,但我认为只要足够有创意,每个项目都能接近这个目标。
-
指令会随时间失效。时间一长、上下文被压缩得越多,Agent 就越容易忘记某些规则,或者觉得它们没那么重要。做交互式工作时,这种偏差还能随时纠正;但 Agent 自主运行时,偏差可能一直没人发现,最终拖累工作质量。每小时刷新一次指令,解决了这个问题。
-
现在生成代码的成本很低。写得不好就扔掉。头 4 周我们发现问题时还想着抢救一下,结果反而比推倒重来更费时间。
-
正确性远比生产力重要。降低 token 消耗、扩大 Agent 规模、优化 Agent 吞吐量这些都很好,但如果结果不行,这些都没什么用。
写在最后
说实话,这是一个非常有价值的项目,我学到了太多东西。
我觉得光是把这些心得写下来,都不足以传达我们在这个过程中收获的经验。
出了很多问题,但也有很多事情做对了。随着 AI Agent 承担越来越多的软件开发工作,如何编排它们成了人类一项新的、要求更高的任务。
扩展到 15 个以上 Agent 后,更多难题暴露出来。因为命令格式错误,Agent 会时不时把虚拟机清空。
Windows 上已经有沙箱方案,但我目前看到的都不符合需求。我开始扩展自己的用户态模拟器 Sogen,为它加上轻量、可扩展的沙箱能力。不过距离真正能用于生产,还有很长的路要走。
由于虚拟机被清空,我们不幸丢失了一批会话日志,所以无法知道确切的 token 消耗量。
我估计在 6000 亿到 7000 亿之间。