从 12,000 次智能体代码审查中学到的 6 条经验
背景
Gymwasp 是 Swamp 的一家客户,目前还在隐身运营阶段。我帮他们把「软件工厂」搭了起来——也就是那条从代码规划一路打通到代码发布的流水线,全程由智能体驱动,用 Swamp 作为运行框架。整条流程里没有任何人去读代码。他们很慷慨地分享了 Swamp 采集到的工厂运行数据,覆盖 6 个月内的 372 个 issue,这篇文章就建立在这些数据之上。
数据给出了这些结论:
-
65% 的 issue 只需一轮智能体审查就可以合并。 大部分价值在第一步就兑现了。
-
第 4 轮之后,多出来的审查轮次带来的不确定性,和它试图消除的不确定性一样多。 条件通过率在第 2 轮之后直接砍半,累计通过率则在 87% 左右走平。这个循环不是在收敛,而是在震荡。(我们自己的内部工厂里,看到的也是同样的现象)
-
29% 的 issue 从未拿到干净通过。 它们带着警告就发布了。这就是他们对风险的容忍度标准。
-
直接用平均数,会把成本低估 44%。 如果只统计干净通过的 issue,平均是 3.31 轮。但如果算上带着警告发布的 issue,真实的数字是 5.99 轮。
-
单个 issue 的审查成本不随规模增长。 有一个月发布量翻了三倍,但中位数仍然稳在 4 轮——这是使用确定性运行框架带来的结果。
-
1,801 轮对抗式审查中,1,463 轮审的是代码,338 轮审的是方案。 智能体把代码写错的可能性,远高于把方案写错。
工厂
他们把自己的工厂叫作 The Mandible(下颌),和我们为 Swamp 自己内部运营的那座工厂结构基本对得上:
- Plan(规划):收集数据,然后判定范围。
- Build(构建):产出代码。
- Review(审查):找出不符合规格或质量标准的部分。
- Ship(发布):闭环。
- Rework(返工):把失败的部分重新送回流程。
在 Plan 和 Review 两个环节会有人参与,但他们不读代码。他们要确认的是:智能体对问题的理解是否正确,以及替智能体做那些它们自己拍不了板的产品决策。
The Mandible 如何运作
在“计划与审查”阶段,7 个审查器会并行处理计划或已写好的代码。每个审查器都是一个独立的代理进程,跑在各自的模型实例上,互相看不到对方发现的问题。每个审查器会给出一个裁决结果:
-
pass:该检查项没有发现问题。
-
warn:需要跟进,但不阻塞合并。
-
fail:修复前不允许发布。
本轮的整体裁决取七项中最差的那个。
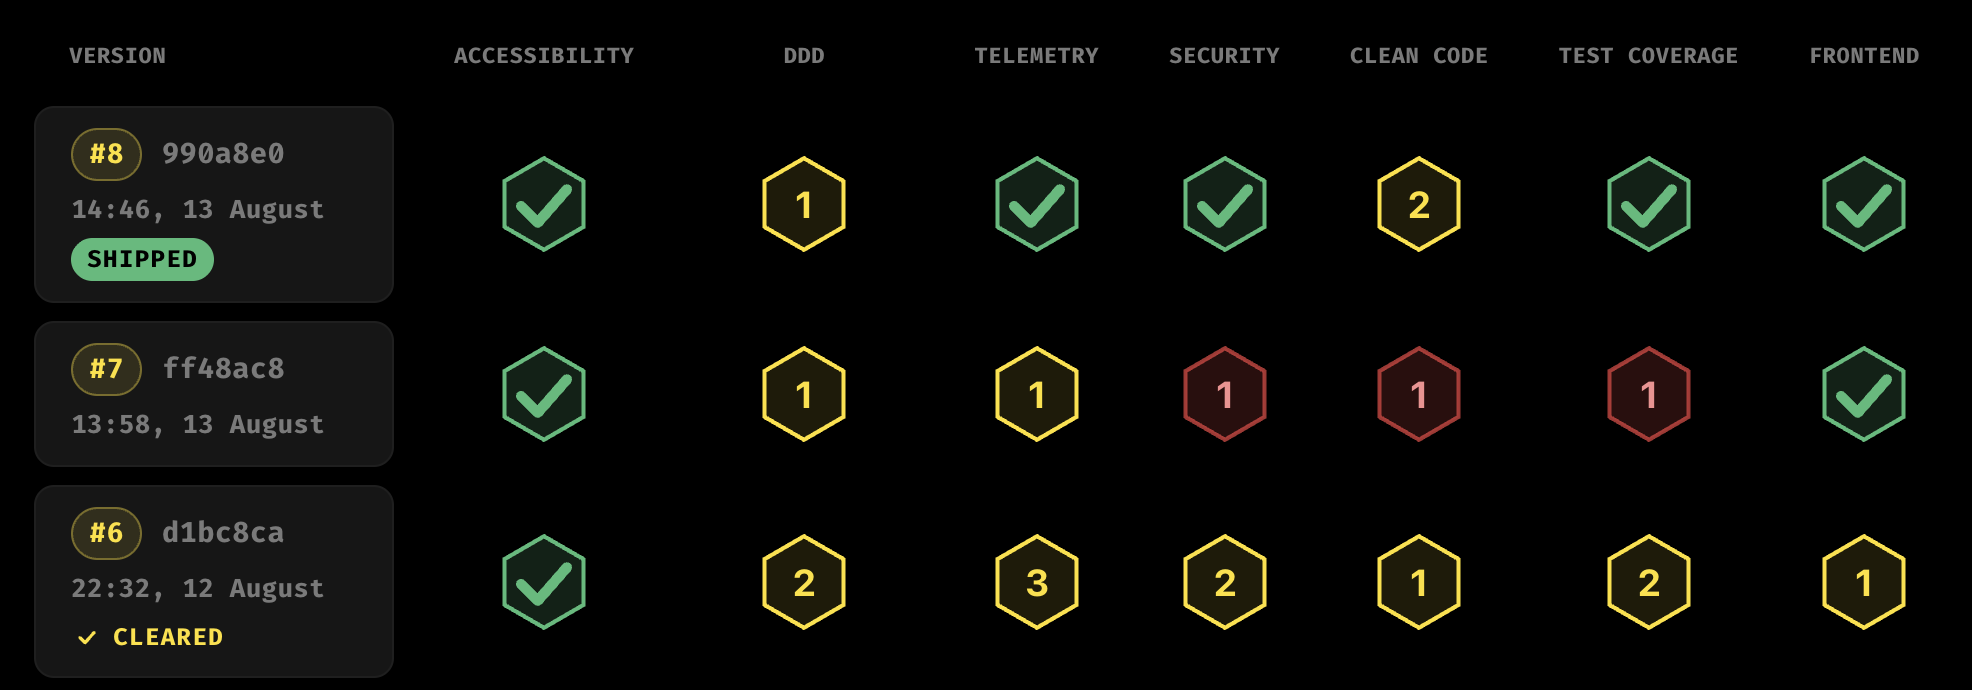
七个检查项分别是:
-
测试覆盖。默认代码有问题,除非有真实 fixture 的集成测试能证明它没问题。这是设计上最严格的一项。
-
整洁代码。范围蔓延、上线即废的代码、过早抽象、注册表之外的硬编码值。
-
前端。组件结构、设计 token、响应式。
-
DDD。限界上下文、聚合边界、分层隔离。
-
安全。认证、授权、注入、越权访问、认证竞态。没有技能文件,纯对抗性检查。
-
无障碍。键盘操作、ARIA、对比度、点击区域。遵循 WCAG 2.1 AA。
-
可观测性。Span、Web 事件、错误传播。
每个审查器拿到一份很窄的任务说明,以及一份明确的“越界排除清单”。没有排除清单的话,同一个问题你会收到七遍。
数据
大多数团队根本没有在度量代理审查。少数在度量的,多半也是在看变更上线要多久,或者一段时间内能处理多少问题。想优化流程的话,这两个指标都没什么用。
下面是对数据的追踪,以及它能告诉你什么。下图展示了某个问题在第 N 轮审查后获得干净通过(7 项全部 ✅)的概率。
两条曲线之间的差距就是问题的关键。
可合并就绪度几乎立刻到来。65% 的问题在单轮审查后就没有失败通道,到第 4 轮达到 98.9%。由于警告不会阻止合并,第 4 轮之后的几乎所有审查量都花在追求一个复杂 PR 的干净通过上,而考虑到基于大语言模型的审查本身的非确定性,这几乎不可能实现。
65% 的问题一轮后已经可以合并,三轮后达到 94.5%。
第 4 轮之后,额外轮次引入的不确定性,和它们试图修复的一样多。再加上 218 个出现在原本干净通道中的失败,这个循环引入的问题和它消除的差不多。每次修复都会触及相邻的关注点,从而在原本安静的通道中触发新的发现。
第 1-2 轮的转化率约为 25%。从第 3 轮开始:审查循环开始震荡,而非收敛。
灰色柱代表带着警告就发布的问题。这正是为什么简单的平均值会出错。如果只统计那些干净通过的,成本会被低估近一半。29% 从未达到干净通过。这就是他们的风险容忍度。
200 次通过中有 120 次落在前两轮,然后是一条一直延伸到第 32 轮的长尾。
单个问题的审查成本没有随数量增长。流水线承受了 3 倍的增长,而审查循环并没有变得更贵。这就是确定性自动化的意义:即使吞吐量增长,流水线依然保持原有形态。
没有明显相关性:皮尔逊相关系数 r = 0.08。7 月交付量翻了三倍,中位数仍保持在 4 轮。
1,463 轮审查代码,338 轮审查方案。智能体写错代码的概率远高于写错方案。方案关卡在任何代码存在之前就拦截了架构错误。
81% 的轮次审查代码,19% 审查方案。
i. 全程使用 Anthropic Claude Opus,在测量窗口期内随着版本发布从 4.6 升级到 5。
ii. 这里的平均值依赖于一个假设:在 6 个月内 372 个问题的数据集上,“平均” PR 能代表整个时间段。
iii. 每个软件工厂都是针对自身组织和需求定制的。结果和发现会因实施方式而异。
感谢 James Owens 慷慨分享数据(他还是我婚礼上的伴郎,人特别靠谱)。
失效了怎么调
数据不只能告诉你这套流程现在管不管用,还能告诉你它什么时候开始跑偏。
-
通过率逐轮不再提升,意味着审查者们在原地打转,而不是在收敛。解决办法不是加轮数,而是改简报(brief)。收紧排除清单,把失败词表磨得更利。让每条通道对"失败"的定义更具体,这样阈值就不会在轮次之间来回晃。
-
某条通道包揽了大部分失败,要么是它确实抓到了更多问题(好事),要么是它的简报调得太激进了(坏事)。测试覆盖率那条通道是 19.1%,这是有意为之——它的简报规定,只要缺少集成测试就必须判失败。如果你那条可观测性通道突然开始以 15% 的比例拦截,说明有什么东西变了,而且大概率不是代码质量的问题。
-
基础设施抖动正在侵蚀信任,这是不动声色的杀手。The Mandible 有 3.7% 的判定结果因为审查代理崩溃而丢失,8.1% 的轮次里至少有一条通道没给出评估,111 次迭代在写下判定之前就死掉了。去查查你的 CI runner 里有多少测试抖动,是因为 CPU 绑定或内存溢出(OOM)造成的。同一个概念,只是换了领域。在传统 CI 里,一旦抖动率上升,人们就想把测试注释掉,反正它们也没提供什么价值。在这里也一样,如果你的代码整洁度审查者频繁判失败,人们就想把它删掉。同样的直觉,同样的错误。去改简报,别把这条通道干掉。
-
"可合并"标准需要的轮次变多,说明你的循环在变差。这份数据里,第 4 轮是那个拐点,再往上加轮次就买不到质量了。如果下个月拐点变成了第 6 轮,那就说明简报跑偏了、排除清单过期了,或者代码库变化太大,锚点已经指向了错误的文件。同样的问题,同样的解法:埋点、测量、重新调优。
-
完美是伪命题。29% 的问题在没有通过干净检查的情况下就发布了。流水线在前三轮抓出了结构性问题,其余的都记进了警告日志。考虑到基于大模型的评审本身就有不确定性,为追求复杂 PR 的 100% 完美而耗费算力并不划算。合并就绪即可发布,后续问题批量处理。
同一套方法,新的战场
我在数百个生产环境里编写和管理过成千上万条 CI/CD 流水线。现在做的事,本质上是把 CI/CD 优化用到了新目标上。思维方式可以直接搬过来,因为形状是一样的:一条确定性流水线,分成可度量的若干阶段,每个阶段都能被观测、分析、改进。
-
给流水线装上探针。跟踪轮次、判定结果、各通道的细分情况。
-
老老实实度量。用生存分析,别用简陋的平均值。那些尚未结束的观察值也是数据,不是噪声。
-
找到拐点。做到第几轮,继续投入就不再划算?哪个通道卡得最狠?哪里在反复折腾?
-
重新调参。把指令写紧、把排除清单磨细、调整警告和失败之间的阈值。
-
再测一次。风险率降了吗?拐点左移了吗?不稳定率掉下来了吗?
老一套的方法,是把构建做快、把测试做稳。新一套的方法,是把评审做准、把评审循环做短。技术是可以迁移的。工具则必须换一套。