属于智能体时代、也为智能体时代而生的设计系统
Mate 没有设计师。整个前端只有我一个工程师,后端团队倒很强,功能需要界面时他们自己上手把 UI 做出来,产品经理也被寄予厚望,要靠编码智能体(coding agent)独立拿出高质量的方案和设计。而且很长一段时间以来,我们仓库里大部分前端代码都是编码智能体写的。Claude Code、Cursor,谁的终端开着就用谁。
从这样的处境里做产品,挺奇怪的。每一个界面都会碰到一个脑子里没有设计的人或东西。后端工程师需要指引,Agent 需要规则。而且规则必须足够严格,才能让一个对我们产品毫无审美的模型,做出来的东西依然看起来像我们的产品。
这篇文章讲的就是我怎么解决这个问题的。不靠 Figma 文件,也不靠没人看的样式指南,而是靠一个把机器当作第一读者的设计系统。
代码已经解决了,设计还没有
用 Agent 写代码已经不是难题。给它类型、测试、linter,再给一个可以模仿的代码库,它交付可用软件的速度比你审阅的速度还快。但用 Agent 做设计还没解决。像 Claude Design 这类工具进步很快,也确实给流程带来了实打实的价值。我也期待 AI 真正成为一位有天赋的设计师的那一天。但对我们做的这款产品来说,光有更好的模型是到不了那一步的。
原因在训练数据。模型是从公开的东西里学设计的:落地页、Dribbble 上的作品、模板市场,还有十年来各种「dashboard UI kit」的帖子。这些素材大多是装饰。它是为一张截图而优化的,不是为一位要盯着告警队列看八个钟头的分析师优化的。如果你让模型「设计一个设置页面」,不给任何约束,你得到的就是这些素材的平均值:一块渐变 hero 区、一张带投影的卡片、三种 40% 透明度的灰色文字、一个毫无意义的图标,再加一个紫色按钮。
那种输出现在有了名字——AI 垃圾(AI slop)。在设计领域,这是一个真实的问题,而不是段子,因为它读起来很顺畅,看起来像是做完了。一个后端工程师第一次做界面,分辨不出它和真东西的区别;下一个智能体把这个文件当作「我们做事方式」的范例来读时,同样也分辨不出来。垃圾堆垃圾。
一个无法为你的产品做设计的模型,照样能把它建出来——只要设计系统没有给它留下任何需要自己决定的东西。
所以答案不是写更好的提示词。答案是设计系统要够全面——每个重要决策都有规则可循;还要够严格——规则就是规则,不是建议。下面的一切都由此展开。
模型从未见过的领域
在品味差距之上,还有第二道鸿沟。我们做的是安全运营平台。安全产品有三十年的历史积累,我们的用户已经用过其中好几款。他们早就知道严重性标签长什么样、筛选栏放在哪里、告警队列是什么形态。这些模式没有任何公开文档记录,它们藏在登录页后面,存在于分析师的肌肉记忆里。
模型从没见过 SIEM(安全信息和事件管理系统)的内部,它只看过营销页面。所以当它「发明」一个「威胁仪表盘」时,是按营销页面来发明的,分析师一眼就能看出不对劲。
为了给自己和智能体一个参照,我做了一个副项目叫 soux:一个真实网络安全产品 UI 的图库,素材来自各家厂商发布的文档、博客和产品页。目前收录了 160 多家厂商的约两千张截图。它同时也是一个 MCP 服务器,所以在我们的代码仓库里干活的智能体可以问一句「别的产品是怎么布局检测规则编辑器的」,在写第一行代码之前先看六个真实答案。
先说一个提醒,这点很重要。某种程度上,soux 和我在前面吐槽过的训练数据有一样的毛病。它收录的只是厂商愿意公开的东西——他们最好的界面和营销素材,所以难免沾上同样的水分。看别人怎么做,是让你思考的理由,不是照抄的理由。我只用它来看那些经得起营销包装的部分:约定俗成的做法。筛选栏放在哪,告警表有哪些列,规则编辑器怎么分区,分析师第一眼想看到什么。碰上一种我没做过、旁边又没有现成参照的页面类型时,它最好用。但配色、间距、细节打磨它帮不上忙,我也从不让它掺和这些。真正做出来的东西,由设计系统说了算。
先立法
整个体系的核心是一个 Markdown 文件:DESIGN.md。它采用的结构,智能体(agent)从其他设计系统提示词里早就见惯了。每条规则都标注章节号,本文后面所有内容都会指回这些编号。
真正让它起作用的不是结构,而是语气。这个文件不是在描述我们的设计,而是在定规矩。下面是其中几条,原样照抄自文件:
Data is never muted. A timestamp in a table cell is data → text-foreground.
The "Created" header above it is a label → text-foreground-500.

Solid tokens, never opacity. text-foreground/60, /50, /40, /30 are banned
for text. The blends render far lighter than the tokens they pretend to
equal (/60 = 4.5:1, /50 = 3.3:1, /40 = 2.5:1, /30 = 1.9:1 on white).

Delete triggers stay neutral. Trash icons and delete menu items stay
neutral; danger color is reserved for the confirmation step.
Decided 2026-09-23.

In doubt? → STRUCTURAL. Pastels are punctuation. They lose impact when
overused.
这些规则里有三点是有意为之。规则是绝对的:给的是禁用清单,不是偏好建议。理由直接写在规则里,对比度数字就摆在旁边——智能体一旦知道为什么,就很少再跟你抬杠。每条决定都带日期。两条规则看起来冲突时,日期新的那条优先,文件里就是这么写的。
文件对落地情况也如实记录。好几条规则旁边都标注了目前有多少门户页面还在遵循:有多少表单还在用原生字段拼装,有多少列表条还带着图标。这一点对 agent 尤其重要。模型会从周围的代码里学习,如果周围的代码违反了规则,它就会把那些代码当成正确写法。我的审查工具里专门有一句应对这种情况:当周围的代码和 DESIGN.md 冲突时,那些代码是历史欠债,不是该模仿的榜样。
有一条规则能说明这种严格从何而来。七月我测了整个门户的文字对比度,发现最常用的弱化文字样式出现了一千多次,而且只是勉强达到对比度下限。每一处都是 agent 抄周围代码写出来的。我把分级透明度换成了四种实色文字 token,取名 Project Unmute,写进了规定。整个模式就是这样:量出偏移,一次定夺,写成禁令,让禁令可以被检查。
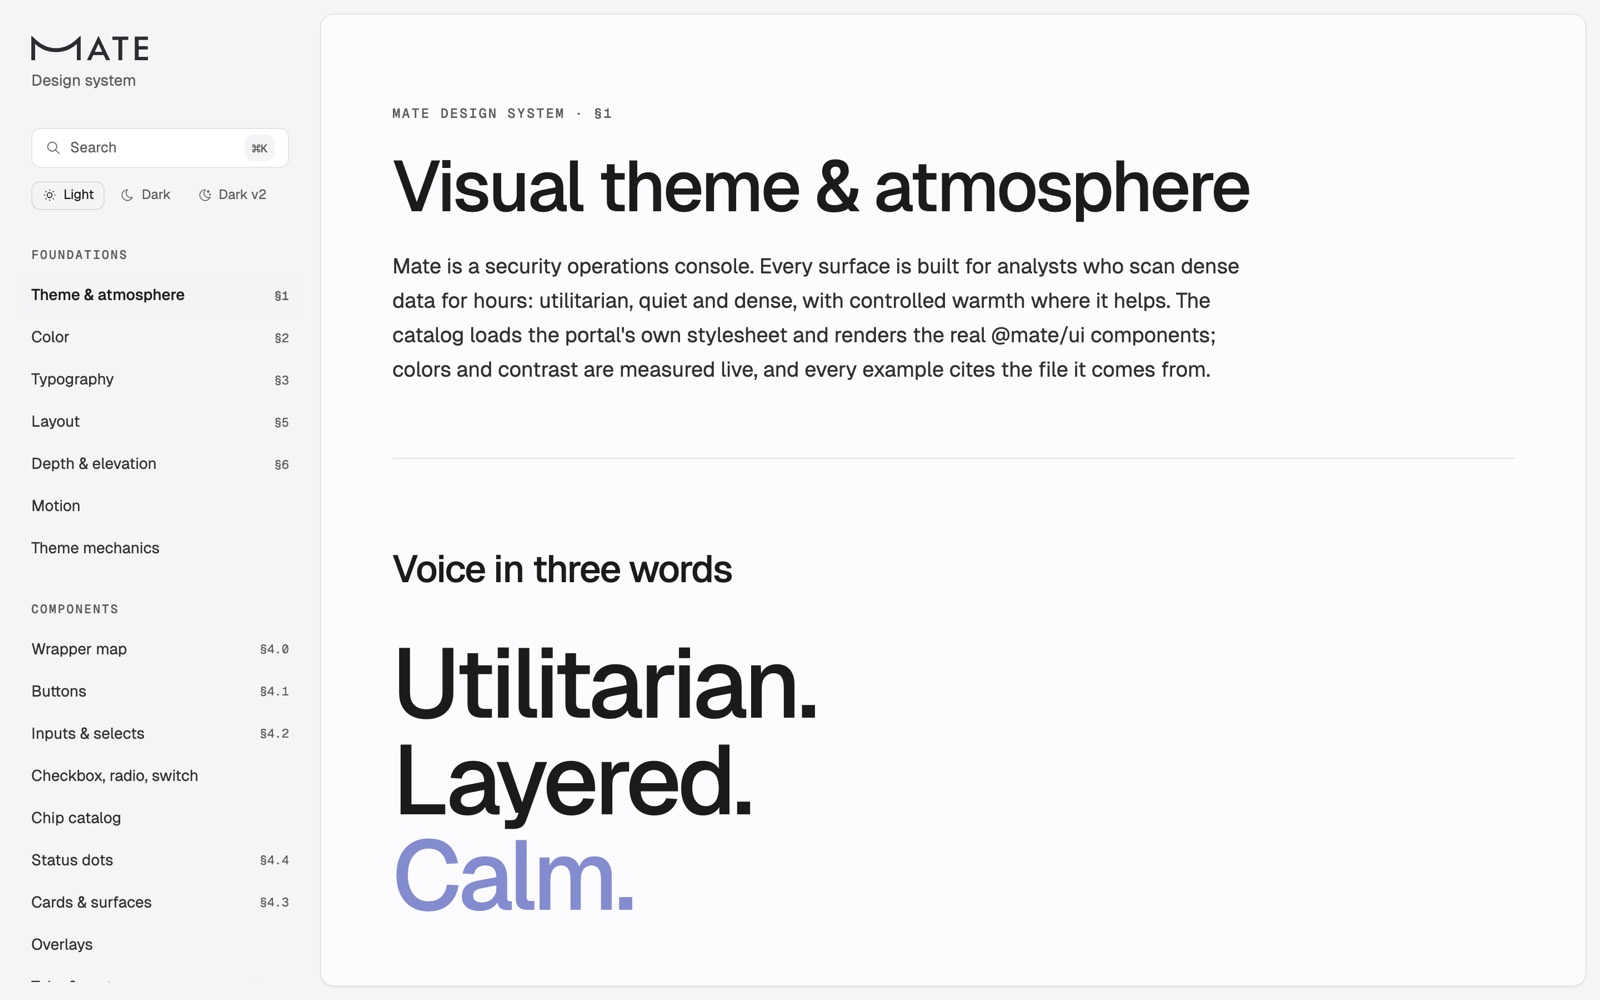
同一个文件面向人的一面。目录里的每个页面都标注了它渲染的 DESIGN.md 章节。
词汇本身就是约束手段
一条 agent 会不小心违反的规则,算不上什么规则。所以第二层就是词汇本身。我们的前端基于 HeroUI v3 构建,但应用代码从不直接引入 HeroUI 的原子组件,而是引入 @mate/ui——一个包含约一百个 Mate 包装组件的包。每个包装组件把 Mate 的视觉规范固定在一处,只暴露 Mate 的词汇。
// The allowed button vocabulary (DESIGN.md §4.1).
// Every entry maps onto a HeroUI v3 variant, so a v3 change is fixed here once.
const VARIANT = {
  primary: 'primary',
  bordered: 'outline',
  flat: 'tertiary',
  ghost: 'ghost',
  danger: 'danger',
  'danger-soft': 'danger-soft',
} as const
这一步有两个作用。一是让库自身的变体名(outline、tertiary)在产品代码里失效,这样智能体即便从文档里学会了 HeroUI,也没法把那套词汇悄悄带进来。二是让映射只有一个改动点。这个月我从 HeroUI v2 迁到 v3,第一次尝试卡住了,因为我想逐个迁移页面。第二次改成先迁令牌和包装器,页面自然就跟上了。迁移能成,靠的就是包装器。
颜色也是同样的道理。产品画出来的每一种颜色,都归 Mate 自己的变量管,HeroUI 自带的变量则映射到我们的变量上,于是这个库用我们的调色板给自己上色。应用代码里不出现任何十六进制色值。智能体想要一种颜色,必须点名一个令牌,而所有令牌都写在「法律」里。
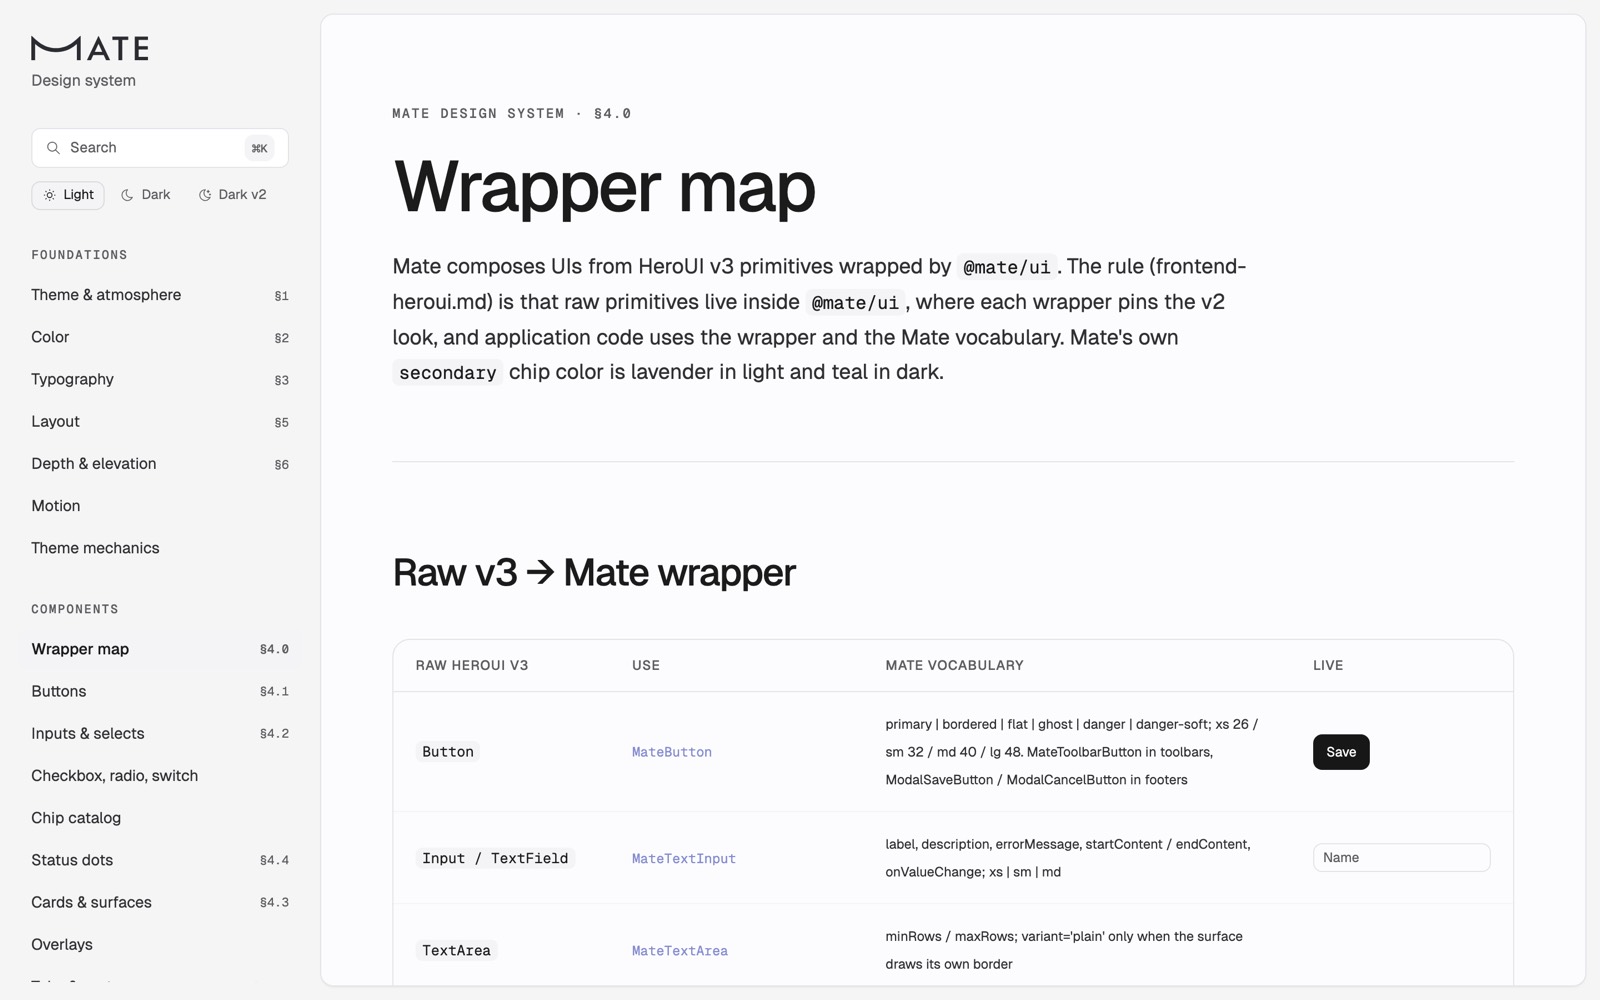
包装器映射。原始基础值、Mate 包装器、应用代码允许使用的词汇,以及在门户自身样式表上的实时渲染。
用范式代替组件
光有组件不够,这是我在另一个项目里学到的。当初我把生成式 UI 做进聊天功能时,第一版目录给了模型 27 个基础组件——网格、堆叠、文本、标签,让它随意组合。结果它拼出来的东西,看着就像一个从没见过这个产品的人做的。我把这些基础组件换成了十来个完整的小组件,它们本身就是产品的一部分,问题随之消失。
写代码的智能体也有同样的毛病。给它一个按钮、一个列表、一个抽屉,它就会在每一屏都发明一套新布局。所以 DESIGN.md 里最新、也最重要的一节,是「常见模式表」。我们门户里的大多数页面都落在这十一种形态里:向导抽屉、分区抽屉、内容抽屉、集合列表、批量操作、设置列表页、设置详情页、确认操作、筛选头部、仪表盘小组件、查看筛选。每个范式都写明:何时该用、何时不该用、由哪些组件拼成、遵守哪些规则,以及在门户里可以照抄的三个真实文件。
给智能体的指令不再是「做个设置页」,而是「先选形状,再照着配方把它搭出来」。选形状是我唯一还要求人工明确拍板的设计决策,它决定了这个界面看起来像不像我们家的东西。
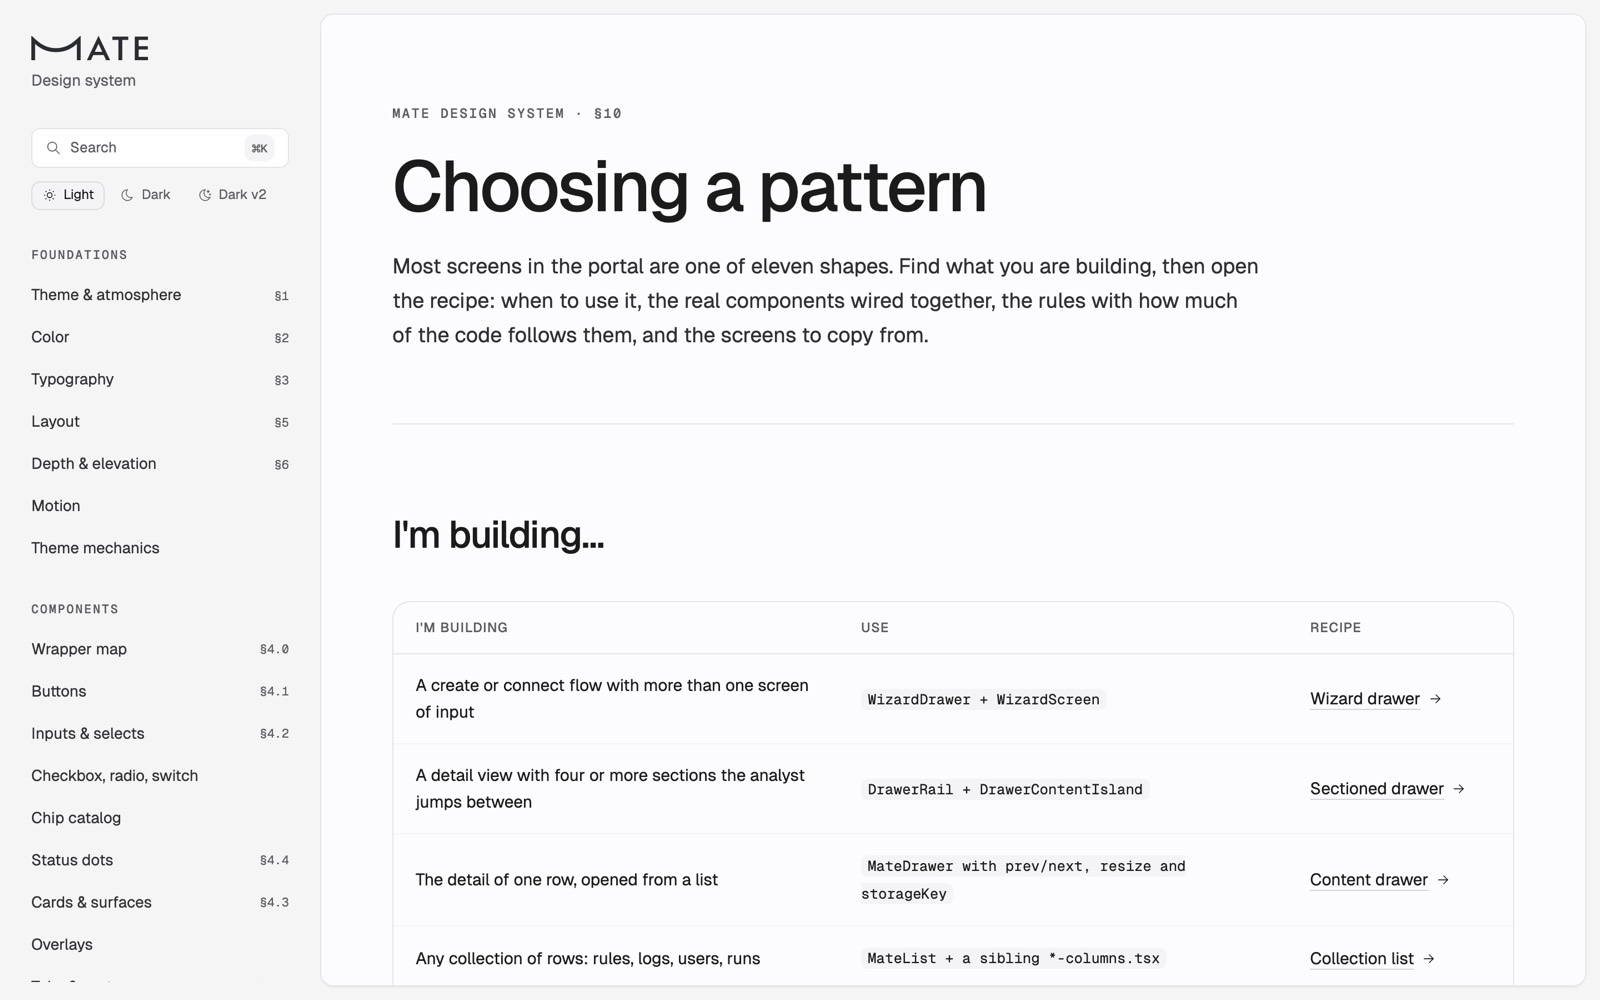
第 10 节。智能体最先读的那张表,也是 plan_ui 用来排序的同一张表。
智能体优先:MCP 服务器
没人读的法律只是装饰。智能体不会去逛网站,也不会每接一个任务就把长长的 Markdown 文档从头读一遍。它们调用工具。所以设计系统就是一个 MCP 服务器(Model Context Protocol,模型上下文协议服务器,把能力以工具形式暴露给智能体),而服务器的说明会明确告诉智能体按什么顺序干活:
-
plan_ui。用一句话描述要做的界面。它返回匹配的配方、这个界面由哪些组件组成、该读 DESIGN.md 的哪几节、该复制哪些门户文件。
-
get_recipe、get_component。组件的解剖结构、使用规则、props、真实示例代码,以及提到该组件的「该做/不该做」对照。
-
写代码,只用封装组件和设计令牌(token)。
-
对每个改动的文件跑 check_ui_code。把所有错误改完,才能说活儿干完了。
每个结果都会链回目录里能实时渲染该组件的页面,这样人工审查智能体的产出时,看到的和智能体看到的是同一个东西。
如果让我重做一遍,我会最先做检查器。Lint 能禁止某个 import,但它说不出「这个取消按钮应该是 ghost 样式」,也说不出「这段弱化文字在深色模式下对比度不达标」,更说不出「删除操作用中性色,红色留给确认那一步」。check_ui_code 会把二十来条这类规则跑在一段代码或整个文件上,每条违规都会指出它违反了哪一节、以及怎么改。下面这个卡片,如果你是从网上公开教程里学的 React,会觉得它完全合理:
check_ui_code · a reasonable-looking card, as an agent would write it

6 errors, 1 warning in example-settings-card.tsx.

L1  error    raw-heroui-primitive (§4.0): Button → MateButton.
             Import the wrapper from @mate/ui instead.
L1  error    raw-heroui-primitive (§4.0): Card → MateCard.
L2  error    lucide-icons (§4.10): icons come from @tabler/icons-react.
L6  warning  drop-shadow (§6): shadow-lg. Hairline borders instead of
             drop shadows on cards and panels.
L6  error    no-dark-variant (§7): bg-white without a dark: variant.
             Use a surface token (bg-island-bg dark:bg-content1).
L7  error    em-dash (§7): no em dashes in user-facing copy.
L7  error    text-opacity-or-palette-gray (§2.2): text-gray-500.
             Use the solid ladder: text-foreground-700 (body),
             text-foreground-500 (muted).
每条规则都对应一个真实发生过的拉取请求(pull request)。检查器本身并不聪明,也不需要聪明。它也会说明自己做不到什么:它无法判断布局或模式选择,所以它会提示智能体把结果和配方对照一下。
让检查器保持诚实的是,目录就是它的测试套件。目录里的每个示例都必须零错误通过,每个“不要这样写”面板都必须被标记出来,每条规则都必须引用某个章节。只要测试不变红,文档和检查器就不会脱节。
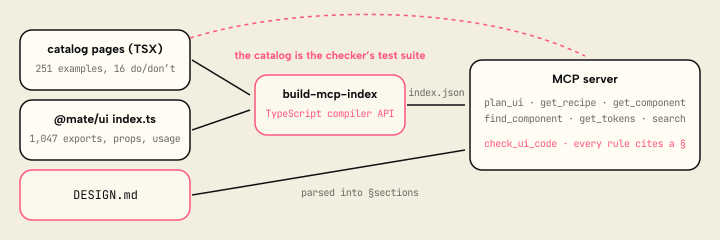
服务器读取两样东西:规则本身,以及生成的索引。索引里的内容全部自动生成,没有任何一项靠手工维护。
同一套规则,三处落地
智能体读的东西比工具多。它们会读编辑器注入的规则文件,也会运行技能(skill)。这些内容我只写一次,然后按各编辑器的要求生成对应副本,因为能产生偏差的副本迟早会偏差,最后两个编辑器执行的就是两套不同的规则。
前端规则很短,主要管用词:用包装组件,别直接用底层原语。更重的判断交给三个技能:
-
设计审查。对差异(diff)做严格的规则检查。每条发现都必须引用它违反了哪一节。这个技能自己的说法是:这不是品味审查。如果
DESIGN.md没有规定,那就不算发现。 -
前端审查。负责逻辑和 bug 审查。它会特意把设计规则检查转交给设计审查,免得设计规则挤占了找 bug 的精力。
-
设计拷问。面向新界面的安静设计搭档。它会调研现有 token 和组件,提出两三个带代码的方案,并在我看到之前先标出那些“AI 味”的地方。
这一层的重点不是把同一件事说三遍,而是让每个读者拿到规则时,都是它当下能用的形态。规则文件在敲下第一键之前读,工具在任务进行中调用,审查技能在之后运行。章节编号全程一致,所以审查里的一条发现,指向的就是智能体一开始应该读的那一段。
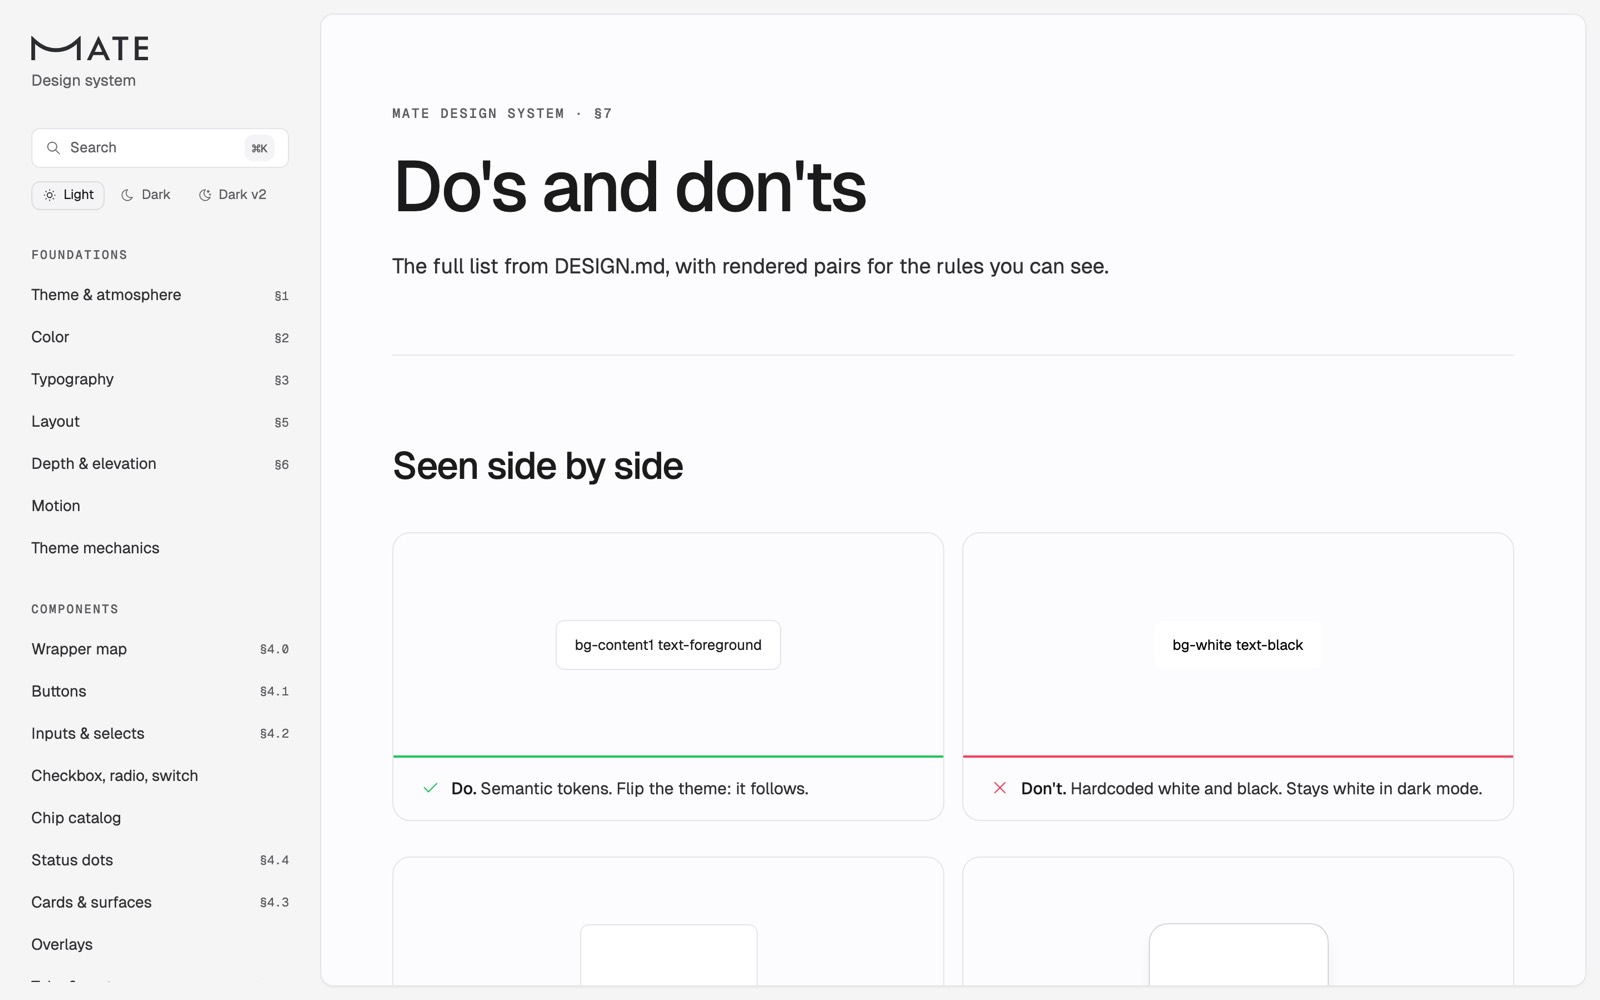
第 7 节渲染出来的样子。这个页面上每一条可校验的「不要」,同时也是检查器的一个失败测试。
人类看到的是同一份数据
这并不意味着人类是被忽略的一方。后端工程师需要一个地方,在向智能体索要界面之前先自己看看。产品人员也一样,因为他们也会用智能体搭建原型。而我自己也需要一个地方,能看清刚写下的规则在深色模式下到底对不对。所以我们做了一个完整的设计系统 Web 应用,规则很简单:它必须渲染真正的产品,而不是产品的副本。
每个页面都在门户真实的样式表上渲染真实组件,目录里看到的就是实际上线的效果。每个示例都标注了它来自哪个文件,很多示例旁边还有一条「当前代码中的应用情况」说明,附上采用数量,这样目录就不会夸大产品里究竟有多少地方遵守了这条规则。
MCP 服务器读取的就是这份数据。智能体索引直接由目录自身的页面构建:每个示例、每组「要/不要」对照、每个规则列表、每份配方。你为人类写一个页面,下一次构建时智能体工具就学会了。诀窍就在这里:一个编写入口,两类读者,没有第二份会腐化的副本。
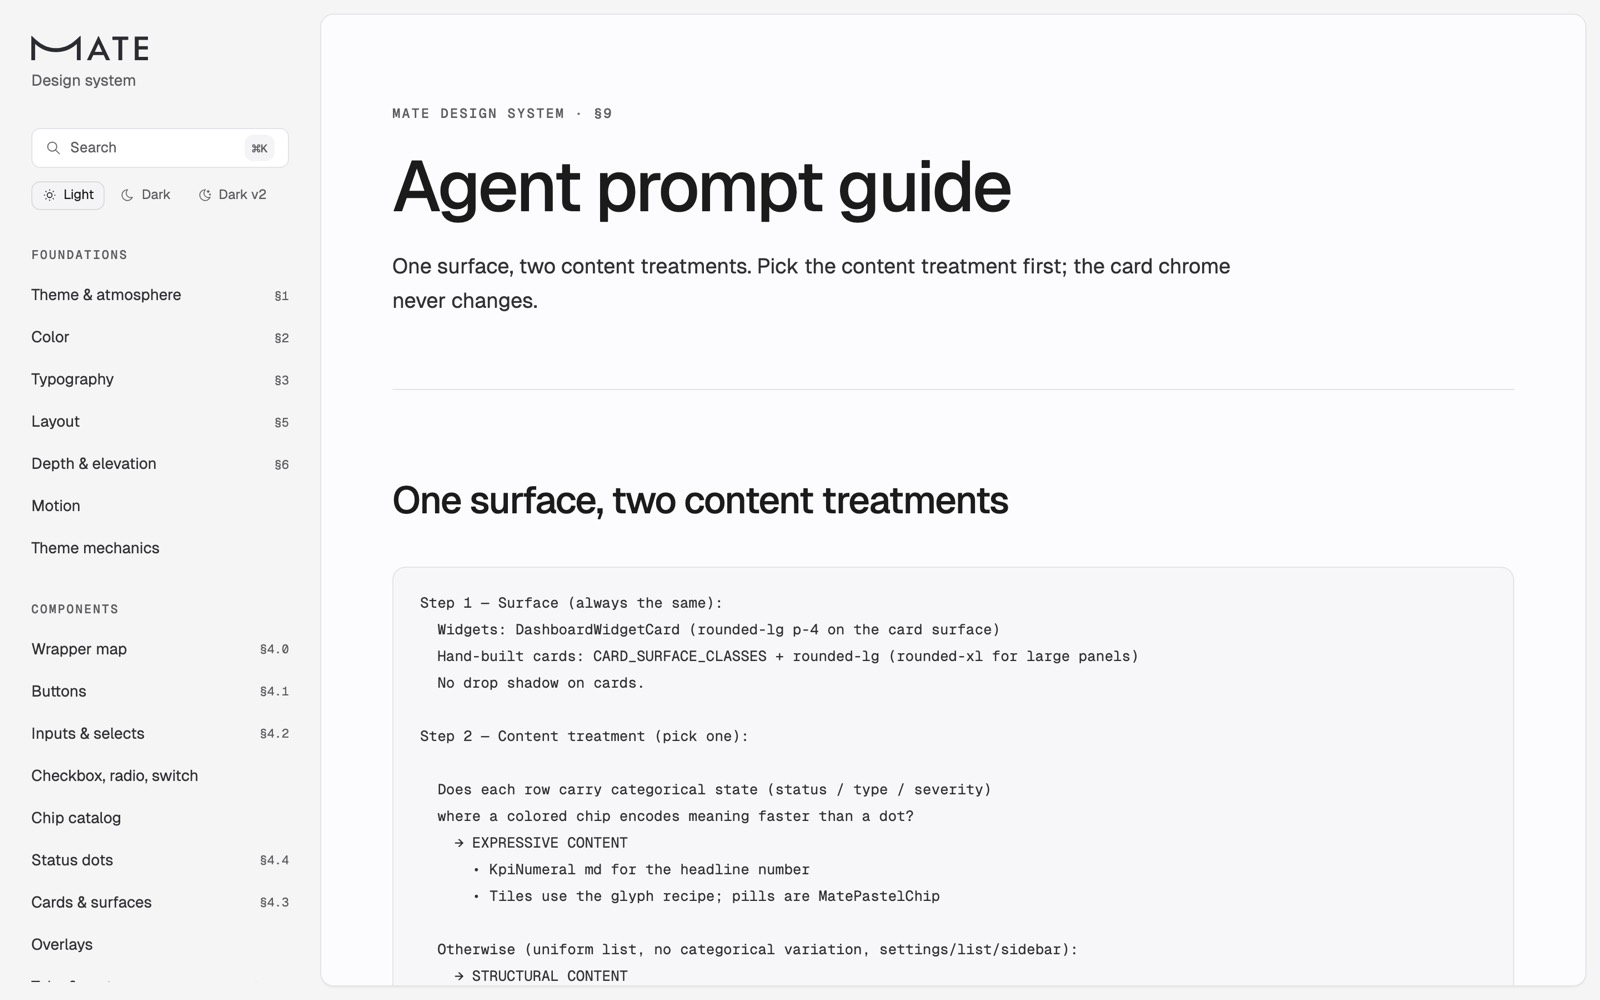
第 9 节是写给模型看的,但它和人类读者在同一个站点上。工程师会把它粘贴到提示词里。
我会给你的建议
如果你在带着智能体做产品,又没有设计团队,下面是我希望当初有人能直接交给我的那套做法。
-
写规则,别写描述。 禁令要带数字和日期。「优先使用实色文本 token」会被无视。「文本禁止使用透明度;/40 的对比度只有 2.5:1」会被遵守。
-
让词汇表本身成为约束。 把你的组件库包一层,让产品代码里能用的词只有你的词。这层包装也是下一次迁移发生的地方。
-
交付配方,而不只是组件。 决定一个界面像不像你的产品,靠的是形状。把形状列出来,让选形状成为第一步。
-
先让它能被调用,再考虑让人翻阅。 开头放一个计划工具,结尾放一个检查器,对 agent 输出的影响比任何规则文件都大。检查器每报出一个问题,都必须指出它依据的是哪一节。
-
生成,而不是复制。 只有一份来源:索引从真实代码里构建,目录(catalog)直接当成检查器的测试集。会漂移的文档,迟早会漂移。
-
把领域知识明确喂进去。 模型从没见过你用户用的其他工具。给它参考资料,并注明这些资料从哪来。
-
如实对待采用情况。 把欠账和规则并排打印出来。否则 agent 会照抄旁边的写法。
有两件事还没做完。CI 里还没有任何东西会在 pull request 上跑检查器。而且这套「法律」在行文上仍会自相矛盾:有一段还在描述我已经禁掉的透明度层级。测试能抓到「有条规则却没有对应章节」,却抓不到「一个章节和另一个章节互相矛盾」。
靠喂更多互联网数据,模型也不会对安全控制台产生品味。可如果系统不给它留任何需要猜的东西,它也不需要品味。严格、全面、可检查,并且写给真正动手写代码的那个读者看——这就是如今设计系统的意义所在。