用更少的 LLM 上下文,更聪明地执行代码迁移
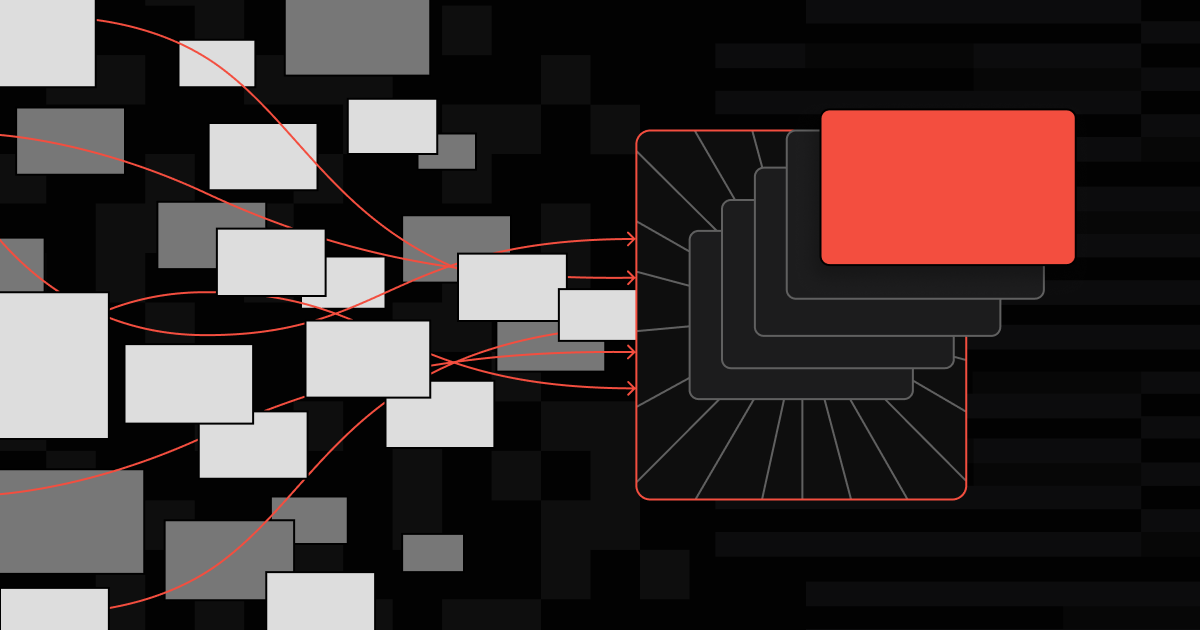
Deep Search 会在 Sourcegraph 搜索 API 外围的沙箱里运行脚本,因此一次迁移审计最后返回的是一份 CSV 清单,而不是几千个文件堆出来的 token。
随着企业不断扩大 AI 的使用规模,token 成本正受到严格审视。企业很想借 AI 来改造代码库,但 token 用量一旦失控,大规模项目很快就会贵到做不下去。迁移和代码库审计这类任务风险尤其高:它们往往要扫描成千上万个文件,把这些中间数据一股脑塞进 LLM 的上下文窗口,结果就是成本飙升、模型表现变差。
朴素 agent 工作流的问题
常见的 AI agent 工作流,往往把 LLM 当成任务每一步的唯一处理器。它们把海量数据直接拉进上下文窗口,指望模型自己从噪音里筛出信号。但上下文多,并不等于上下文好。做迁移或审计时,你要的通常是一份结构化、干净的结果,而不是每个被扫描文件的原始杂乱细节。
为此,Deep Search 可以在沙箱环境中运行脚本,围绕 Sourcegraph 的搜索 API 来执行。它不会把每一条中间搜索结果都喂给 LLM,而是自己把重活干了:跑多次搜索、交叉比对数据、过滤结果、计算总量,甚至生成 CSV、JSON、SVG 报告这类结构化产物。LLM 最后只拿到汇总后的发现和最终产物,上下文窗口因此保持聚焦、高效。
Deep Search 扫描
kubernetes/kubernetes,找出pkg/下 TODO 注释最多的文件,最后返回一份 CSV 和一张 SVG 图表,而不是它读过的那些文件内容。
为什么这会改变成本结构
把处理工作交给沙箱,可以带来三个关键好处:
- 只为高层结论付费,不用为每个文件的中间处理买单。
- 模型不会被成千上万行无关文件内容干扰。
- 拿到的是可靠的结构化数据,团队可以直接拿来行动。
主要用例:代码迁移
设想一个常见的迁移场景:把服务从 old/package 搬到 new/package。用 Deep Search,你可以要求它完整审计所有仍在引用旧包的仓库。Deep Search 会扫描代码库、找出相关文件,生成一份干净的 CSV 清单。团队打开这份文件就能开始迁移,而且可以确信报告既全面又准确。
次要价值:更好的上下文质量
好处不只是省钱。因为 Deep Search 只把相关数据传给大语言模型(LLM),模型可以专心归纳结论,而不是充当数据处理员。这样得到有用、准确输出的概率更高。
更广泛的应用
凡是「搜索驱动、产出结果文件」的场景,Deep Search 都能派上用场:
- 资产盘点: 追踪共享服务在整个组织内的使用情况。
- 代码健康度: 找出仍在使用过时或存在漏洞的依赖的仓库(例如 Log4j 版本低于 2.17)。
- 交叉比对: 对比不同模式下的实现,找出不一致之处。
结语
随着 AI 应用的成熟,token 效率正成为工程负责人采购时的重要考量。Deep Search 的评估器(evaluator)给出了一套具体的架构方案,既能降低成本,又能提升 AI 辅助开发的质量。如果你打算做大规模迁移或代码审计,那就该跳出标准的 agent 工作流,让 Deep Search 来应对这种规模。
特别感谢 Justin Dorfman 和 Stephanie Jarmak 对本文的贡献。