AI 成本每年下降约 10 倍
2026 年 10 月 23 日
使用同等智能水平的 AI,成本每 12 个月下降约 10 倍。——Sam Altman,2025 年 2 月
如今已是 2026 年 10 月,20 个月过去,我想验证这个说法是否仍然成立,或者降价速度是加快了还是放缓了。¹
身处指数增长之中,很难凭直觉把握它。把视角拉远、画成图表会更容易理解。
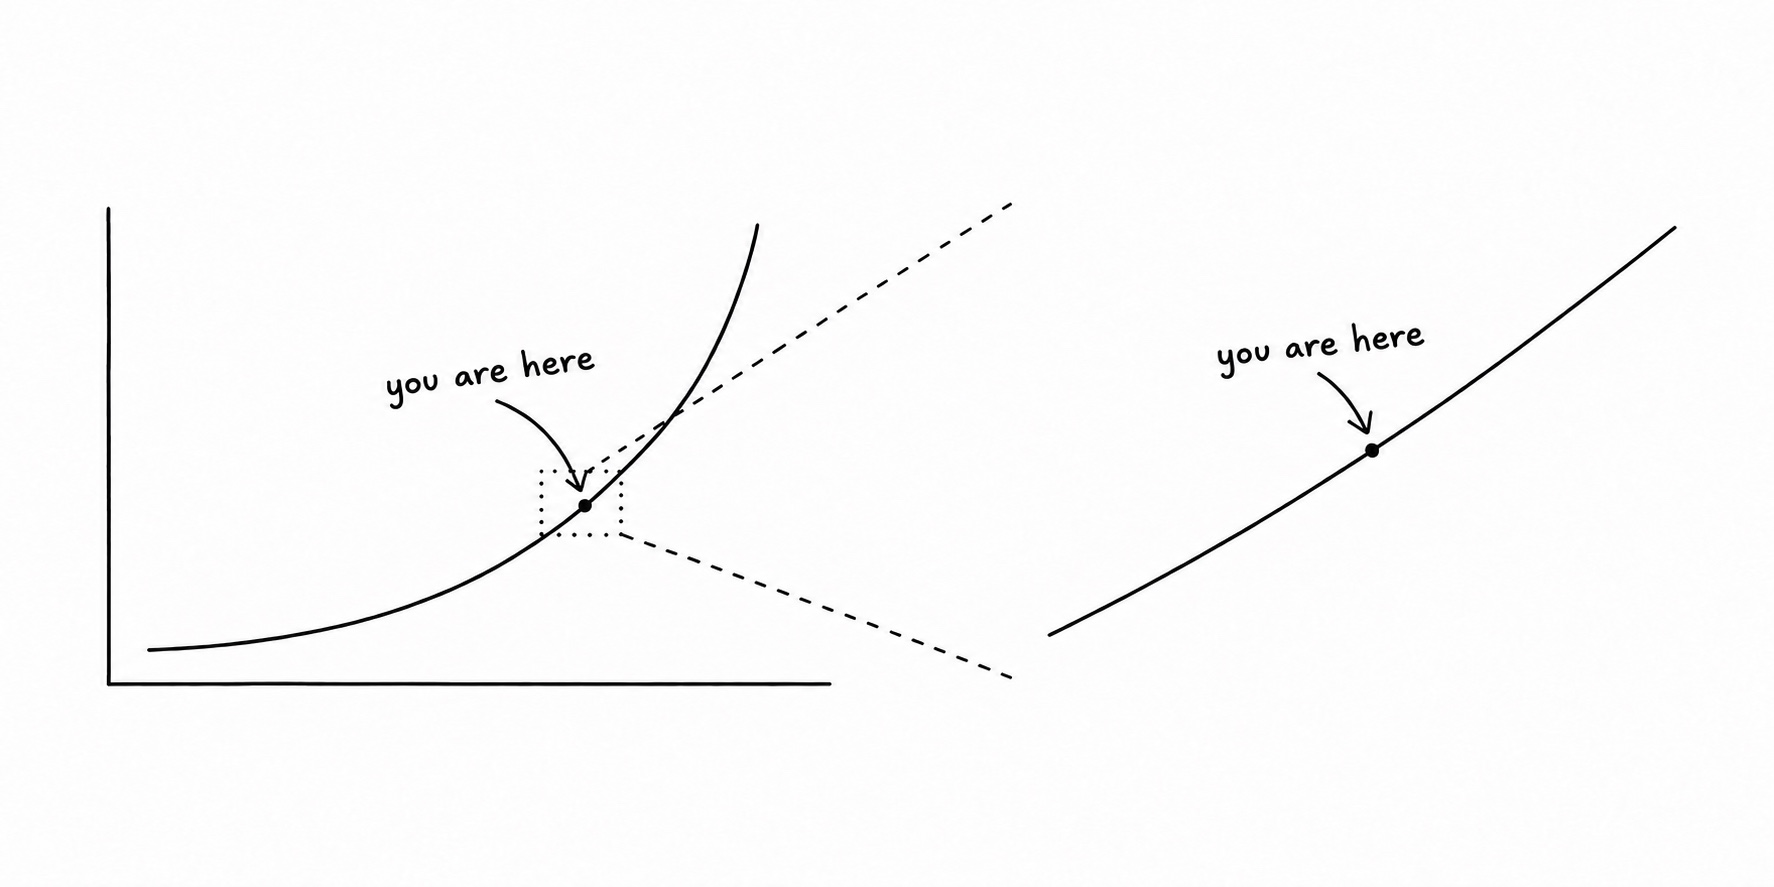
我用四个不同的基准测试绘制了价格下降曲线:
| 基准测试 | 价格下降 10 倍所需时间 |
|---|---|
| Humanity's Last Exam | 0.8 年 |
| Arena Elo | 1.3 年 |
| GPQA Diamond | 1.2 年 |
| Terminal-Bench | 0.8 年 |
| 平均 | 1.0 年 |
Sam 的说法得到了验证:AI 的成本仍在以每年约 10 倍的速度下降。
Humanity's Last Exam
Humanity's Last Exam(HLE)用专家编写的横跨多学科的难题来测试 AI 模型。
在这张图里,每条彩色线代表 HLE 上的一个智能水平。沿着每条线往后看,你能找到后续出现的模型——它们能达到相同或更高的智能水平,但价格更低。
举个例子,从 2025 年 1 月发布的 o3-mini 开始。它在 HLE 上得分 12%,发布时价格为每百万 token 1.93 美元。²
仅仅一年多之后,DeepSeek V4 Flash 就以每百万 token 约 18 美分的价格提供了同等智能水平。便宜了 11 倍。
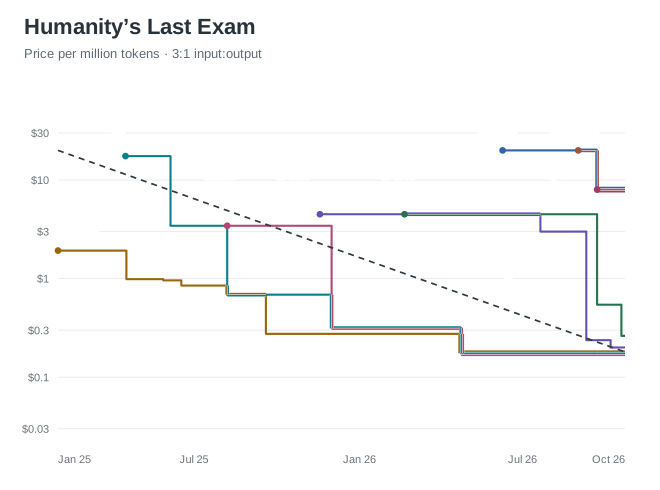
但把时间线拉得更长,情况就没那么清晰了。到 2026 年 9 月,MiMo V2.6 Flash 的价格仍然在每百万 token 约 18 美分。也就是说,大约 1.7 年只便宜了 11 倍,而不是按规律预测的约 50 倍。我猜测,当价格便宜到几乎不用计量时,这种 flattening 就会出现——人们不再关心把那些随意设定的旧智能水平变得更便宜。³
对五个智能水平取平均,结果是每 0.8 年便宜 10 倍。
Arena Elo
Elo 衡量的是在成对比较中人们更偏好哪个模型的回答。这个指标能让我们把时间线拉得更早,一直追溯到 2023 年 3 月。
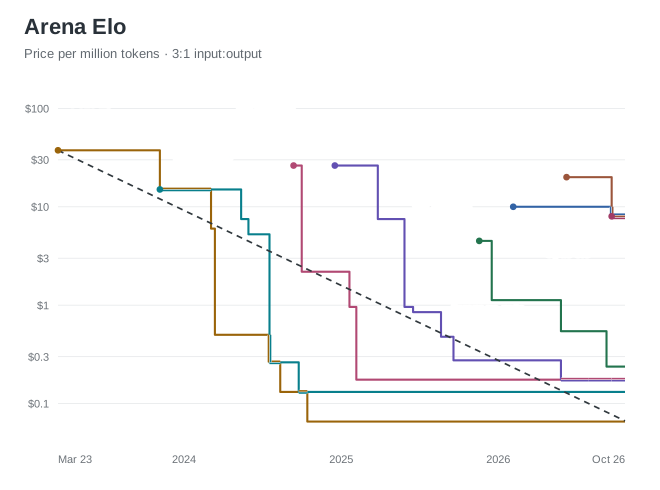
这里拟合出的速度是每 1.3 年便宜 10 倍,这个数字可能偏慢,因为最老的那几档智能水平并没有持续变便宜。³
GPQA Diamond
GPQA Diamond 是一套研究生级别的科学题目测试。这里要问的问题是一样的:想要得到一个得分至少 30%、40%、50% 乃至更高的模型,需要花多少钱?
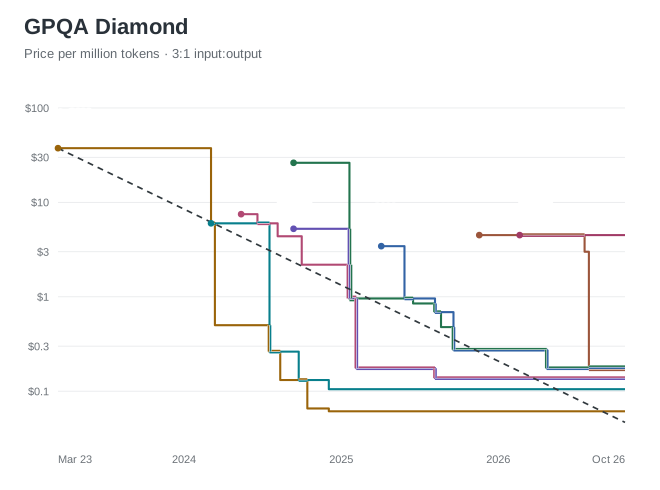
每 1.2 年便宜 10 倍。
Terminal-Bench
Terminal-Bench 衡量的是模型在终端里完成任务的能力。
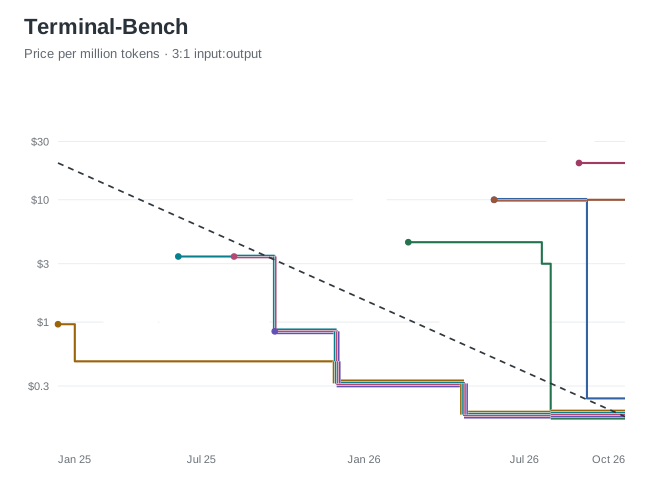
每 0.8 年便宜 10 倍。
李定律
我很钦佩摩尔定律,也觉得我们应该再有另一条定律,让人们可以拿它来衡量 AI 变得“便宜到无需计量”的速度有多快。
我想提议叫它“李定律”。我能找到的最早预测来自李开复,他在 2024 年 5 月预测推理成本每年会便宜 10 倍。⁴ 不过也有充分理由把它叫作“奥特曼定律”,因为正是他帮助推广了这个概念,以及“智能便宜到无需计量”这个说法。
补充一下背景:摩尔定律说的是芯片上的晶体管数量每两年翻一番。这样的改进速度彻底改变了我们的行业和世界。
李定律比它快 7 倍。这实在太夸张了。李定律让摩尔定律看起来就像一条平线。
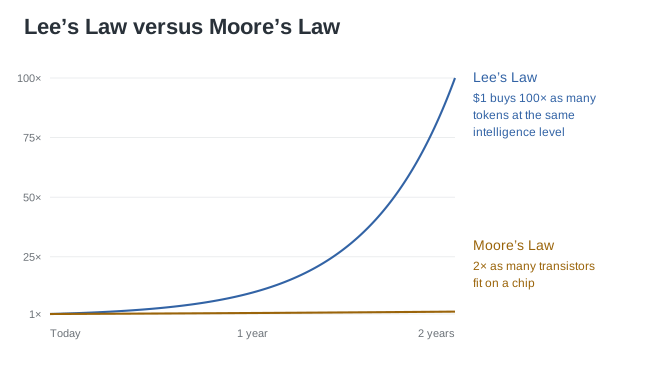
接下来我们会经历一段相当刺激的旅程。
感谢 Charlie、Tom 和 Jackson 对本文的反馈。
脚注
-
我一直很好奇这些趋势是否会持续下去。我的朋友 Swyx 做了这张图表,我经常参考它。但我不能一直依赖他保持更新,而且我想按自己的方式探索和切分这些数据。可谁有时间呢?有了 GPT-6 Astra Ultrafast,我就能做到。相比一个月前,这已经是巨大的进步——那时每次修改图表要花 5 分钟,反馈循环太慢,一个项目要花一整天,或者我干脆放弃。现在一次修改只要 10 秒,我可以在几分钟内迭代出想要的非粗糙版本,整个项目几个小时就能完成,而且大多是在会议间隙完成的。图表数据、标注日期的价格和来源、计算过程。
-
价格按输入与输出 token 3:1 的比例计算,不含缓存。
-
如果有人只想达到 o3-mini 在 HLE 上 12% 的水平,我敢打赌他们能做出比 MiMo2.6F(35% HLE)更便宜的模型,而 MiMo2.6F 已经便宜到几乎无法按量计费了。再说,我认识的每个人都会多花 6 美分去用 GLM 5.3 Flash(40% HLE)。我猜如果市场在意,这些老一代模型的价格还能再降 10 倍。
-
Guido Appenzeller 后来把这一趋势画成图表,称之为 LLMflation。2025 年 2 月就有人叫它 Altman 定律。更早的图表包括 ARK 2024 年 1 月的报告和 Charles Frye 2024 年 5 月的图表。Swyx 2025 年 1 月的图表用的是 chat Elo。Epoch 2026 年 9 月的研究还考虑了模型使用多少 token,发现了类似的速度。