Qwen3.8 27B 量化基准测试:4-bit 依然稳健,1-bit 彻底崩了
想跑 Qwen3.8 27B 又不牺牲效果,到底需要多少显存?
完整 BF16 模型有 55 GB,大多数消费级硬件根本装不下。但 17 GB 的 Q4_K_M 在热门智能体编码基准 Terminal-Bench 2.1 上能追平完整模型,还能塞进 RTX 4090 这类 24 GB 显卡,同时留出大约 64k token 的上下文空间。
不过压缩终有崩盘的时候。压到 1 bit,模型在 GPQA Diamond 上的表现跟瞎蒙差不多,推理越长反而越糟。
背景
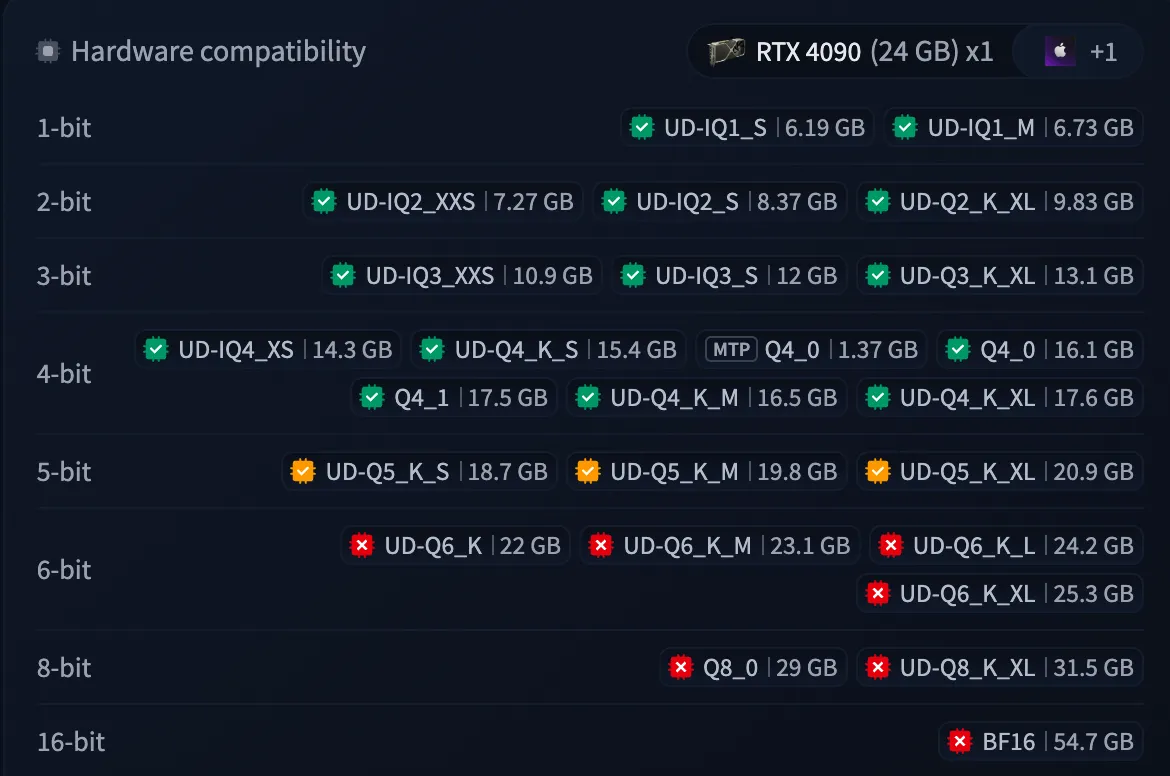
Unsloth 在 Hugging Face 上提供的 Qwen3.8 27B GGUF 量化版本,选择是真多。这次我会检查 8-bit 的 Q8_0(29 GB)、4-bit 的 Q4_K_M(17 GB)、2-bit 的 UD-Q2_K_XL(10.7 GB),以及最小的 1-bit 版本 UD-IQ1_S(6.2 GB)。
之前我测过 Qwen3.6 27B——那款模型在 12 GB 显存下就能画出不错的 SVG 鹈鹕,到 16 GB 时还能保住大部分知识。但 Reddit 上不少人抱怨所有量化版本(连 8-bit 都算上)效果都变差,还有人问「为什么本地 LLM 感觉比它本该有的水平更笨」。这些抱怨站得住脚吗?
衡量 token 预测的差异(KL 散度、top-1 预测)很简单,但说明不了模型解题能力是否下降。有些噪声对解题可能无关紧要——比如量化模型给出的答案质量其实一模一样,只是换了种说法。而另一些情况下,一个不同的 token 就可能是逻辑错误,甚至让输出戛然而止。
所以我选择直接在热门基准上测结果——GPQA Diamond、指令遵循 IFBench、编程 Terminal-Bench 2.1。先复现完整 BF16 模型的官方成绩,再看量化对结果的影响。
我用 llama.cpp(2026 年 8 月 16 日的构建版本,更早的版本跑不了这个模型)在 Modal GPU 上跑这些测试,花了大约 3000 美元。理论上我也可以在自己笔记本上跑,但这些基准很耗时——跟画鹈鹕可不一样。
注意,无论模型采用何种量化,我都使用 F16 KV 缓存,每 32k 个 token 约占 2.3 GB。
我用的量化版本来自 Unsloth:2 位、4 位和 8 位模型用 v2,1 位模型用 v3。Unsloth 在 2026 年 8 月 19 日替换了 v2 文件,所以大多数测试所用的确切文件已经找不到了。
简单说,如果你用 4 位量化的 Q4_K_M(17GB),在这些基准测试上不会察觉到差别。但推理努力程度的设置影响很大(注意默认是 xhigh),而且这个选择很棘手,因为模型可能会过度思考。
单次测试
最简单的就是单次测试,这里用的是研究生水平的科学基准 GPQA Diamond 和指令遵循基准 IFBench。每个测试我都跑三种推理强度:low、medium 和默认的 xhigh。
GPQA Diamond
首先,我很高兴复现了官方结果。跑基准测试不容易,很多隐藏设置或假设都可能大幅改变结果。这次第一次跑,结果就和 Qwen 报告的一致。
其次,除了噪声(柱状图是 Wilson 95% 置信区间,对多次运行的噪声来说非常保守),一直到 4 位都没有明显差异,只有 2 位的分数略低一点。
同时,思考级别会大幅改变分数。xhigh 的最佳结果需要大约 8k 推理 token。
IFBench
这里让我很惊讶,模型之间没有变化,一直到不错的 2 位量化版本,重量不到 11 GB。不过上下文也更低,大约 4k token。
智能体编程与 Terminal-Bench 2.1
编程表现如何?Terminal-Bench 2.1 是一个标准的智能体基准,包含 89 个任务。这里我设置了 3 小时超时,xhigh 努力程度,预留 98k 上下文。
我对 BF16 的测量不仅复现了官方给出的结果,出乎意料的是,Q4_K_M 也同样复现了。
我意外跳过了 Q8_0 的运行;不过在这个案例里,我完全可以在 4-bit 和完整模型的值之间安全插值。运行它既费钱又没必要(而且会超出非正式博客的预算)。
只有在 2-bit 的 UD-Q2_K_XL 上才出现了一点问题。性能有明显下降,但仍处于 Opus 4.7 或 Gemini 3.1 Pro 的水平。再次强调,远不及前沿,但也远非无用。
结果是一回事,但过程呢?更小的模型是否需要更多的轮次、token 或时间才能得到结果?
在同样解决的任务上,UD-Q2_K_XL 所需的轮次与 BF16 相当,但写入的 token 多了约四分之一。轮次数量基本保持不变。
1-bit 断崖
质量在 1-bit 时断崖式下跌。与知识一样,量化的损害是非线性的:起初没有可测量的变化,然后是小幅下降,最后是崩溃。
虽然 2-bit 量化在某种程度上有效,但即便是最好的 1-bit 模型对这些基准测试也毫无用处:
如你所见,分数大约在随机猜测水平附近,而最小的模型甚至低于该阈值。更长的推理会让情况更糟:在 xhigh 设置下,分数比 low 还低,因为模型更频繁地推理到 token 预算耗尽,然后返回空答案。
当然,Unsloth 宣称:
我们还制作了一些更小的 UD-1bit 量化版本,其中 UD-IQ1_S 为 6.2GB(不含 MTP),保留了约 72% 的 top-1% 准确率,同时体积小了 89%。
但在这种情况下,剩下的 28% 影响重大。这与另一位用户在 r/LocalLLaMA 上发布的 Qwen3.8 27b 1bit 脑损伤量化版本的体验相符。
成本
运行这些基准测试并不便宜。通过 API 运行基准测试成本很高,这一点我从之前的基准测试中就知道。在租用的 GPU 上运行则要贵得多。
我使用了 Modal,因为它很容易从 CLI 运行,包括从代理运行。其他配置可能有不同的定价。显然,如果你有自己的设备,这个计算就会改变。
要找到跑模型的最优方式,得先做些测试。通常我不会用多 Token 预测(MTP,它适合单条会话流),而是同时开几条并行会话流。关键限制在于:GPU 的显存要同时装得下模型和所需的 KV 缓存。
我用的是 NVIDIA L40S(和 RTX 4090 同为 Ada Lovelace 芯片,但显存翻倍,有 48 GB)、H100(80 GB)和 H200(141 GB)。我想把成本也一并分享出来,方便你想自己跑基准测试时有个大致估算。
作为对比,DeepSeek V4 Flash 0731 是一个 284B 的模型,在 OpenRouter 上最便宜的供应商输出价格约为 $0.1/百万 Token。我不确定这个差距里有多少来自大规模运行模型的效率、多少来自定价策略,又有多少来自模型的热度。
结论
如果你在本地做实验,通常挑显存装得下的最好模型,再留足所需上下文就行。
大多数任务用 Unsloth 的 Q4_K_M 应该就够了,几乎感觉不到差别;一些更简单的任务,UD-Q2_K_XL 也完全够用。
由于有人反馈 KV 缓存对量化更敏感,我之后可能也会测一下。
但总的来说,我认为量化应该被拥抱,而不是被畏惧。
你的经验如何?欢迎到 r/LocalLLaMA、Hacker News 或 LinkedIn 参与讨论。