当 AI 写代码时,代码质量还重要吗?
我可以让 Claude Code 或 Codex 去调查 DocSpring 里的某些部分,而这些部分我自己的脑子一时半会儿装不下。它们往往比我还快找到问题。这件事改变了我对一个已经写了九年多的代码库的看法。
我在 X 上看到过这类争论的各种版本:如果智能体能够理解并修改复杂的代码,那么技术债务也许就没那么重要了。既然模型已经能啃下这些代码,为什么还要花时间重构?
我想拿我们自己的经验来检验这个说法。作为一个很小的团队,我们一直在努力写清晰的代码、写有用的测试,同时还得让 DocSpring 继续往前跑。AI 扩大了我们能调查和改进的范围,同时也甩给我们一长串可能的改进点,而每一个都仍然需要审查和测试。
于是,我让一个智能体去调查:哪些类型的代码质量工作,才真正能帮我们交付正确的改动。我们筛选了过去三个月里可用的编程智能体对话记录和 pull request 讨论,翻看了部分改动,并在代码上做了一些小实验。这是一次回顾性的案例研究,选取的是有代表性的例子,而不是对整体生产力的受控测量。
最明显的失败,出在行为分散在多个地方的情况,以及那些没有表达出我们真实意图的检查上。把这种行为统一成一份实现,或者让缺失的需求触发检查失败,本来就能抓到我们复现出来的那些错误。至于把每个文件都改短,我们找到的证据就少得多。
一个正确的修复,仍然可能漏掉另一条路径
DocSpring 里有一类表单字段的条件规则:当另一个字段取某个值时显示这个字段,或者当某个条件成立时把它设为必填。这套行为必须在服务端校验、浏览器表单,以及我们为其他调用方生成的 JSON Schema 之间保持一致。
这就意味着,写代码的智能体要在好几个地方保持同步;同样也意味着,人类开发者有好几个地方会忘。
其中一处改动跟含斜杠的字段名有关。在 JSON Pointer 里,路径片段中的斜杠要转义成 ~1。对一个叫 source/field 的合成字段名来说,这一段就变成了 source~1field。查找这个字段的代码,必须正确解析编码后的路径。
有一处修正改到了「控制字段是否可见」的逻辑,却漏掉了另一条分支——那条分支处理的是「只把字段设为必填」的规则。它仍然直接用编码后的名字,结果可能挂不上条件校验器。
我们用构造的输入把当时的实现重放了一遍。在后续修复之前,校验器根本没有装上;修复之后它被装上,并在条件要求填值时拒绝了空的目标字段。这个疏漏在功能合并之前就被发现并修掉了。
第一处修复在它改的地方是对的。但评审的人还得知道:还有第二条路径存在,也需要同样的修正。
更好的做法是让路径解析只有一份实现,再针对各个调用方真正重要的组合分别测试。对条件字段来说,这些组合包括动作、字段路径、输入值,以及最终消费结果的表单或校验器。测过「让字段显示出来」,并不能说明「把字段设为必填」也没问题。
公式这块我们已经采用了类似思路。公式求值器现在是一份共享的 TypeScript 代码,浏览器和后端都在用。序列化、错误处理以及各个运行时的行为仍然要测,但计算本身只有一份实现。
我打算把同样的做法用到字段依赖上。
严格类型必须能表达契约
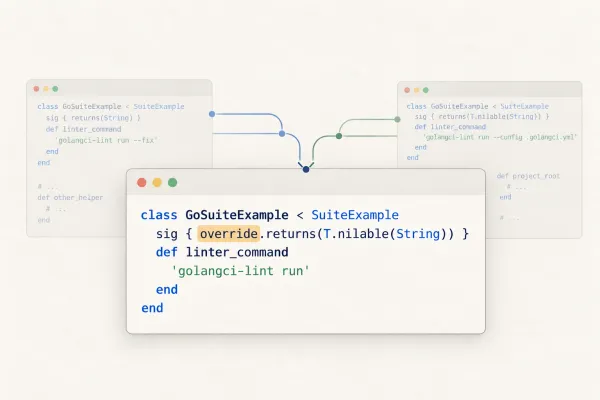
另一个例子出在我们 SDK 的测试工具里。某个子类定义的是 lint_command,而基类期望的是 linter_command。由于这个钩子是可选的,基类实现返回的是 nil。所以调用基类期望的那个方法,什么也不会发生。
这种拼写错误很容易犯,而且出问题的文件本来就开着 Sorbet 检查。那么,强制要求严格类型能发现它吗?
我们写了个小例子来验证:
# typed: strict

class SuiteExample
  extend T::Sig

sig { returns(T.nilable(String)) }
  def linter_command
    nil
  end

class GoSuiteExample < SuiteExample
  sig { returns(T.nilable(String)) }
  def lint_command
    'golangci-lint run'
  end
Sorbet 接受了这段代码。两个方法都有合法的签名,新增一个叫 lint_command 的方法完全合法。
随后我们改动了子类的签名:
sig { override.returns(T.nilable(String)) }
这次 Sorbet 拒绝了那个拼错的方法,因为它没有覆盖任何东西。把名字改成 linter_command 之后,就满足了这份契约。Sorbet 的 override 检查文档描述了这个行为。
这改变了我让 agent 补充 Sorbet 覆盖时的做法。第一版代码已经是 strict,注解也齐全。缺的信息其实是:这个方法本来就该覆盖基类方法。
同样的逻辑也适用于方法周边的工具。如果某项质量检查是必须的,就该用测试确保命令真的执行了,且一旦失败整个 job 就失败。让一个返回空的可选钩子来藏这条要求,显然不合适。
大文件更难追责
我原本以为能找到更强证据,证明超长文件确实有问题。早期的编码工具读或重写大文件时可能吃力,而拆分文件也是交给 agent 的常见任务。
我们检索了对话记录,没有在 Claude 的文件读取结果中发现明确的文件过大或截断错误。这个结论很窄,它不能说明相关上下文是否被省略、shell 输出是否被截断,也不能说明 agent 是否读对了段落却理解错了。
它只说明,这次调查没能得出一个有用的阈值,比如「文件超过 1000 行,agent 就无法可靠工作」。
有些大文件包含大量内联测试或成片的声明。另一些则包含多个职责,彼此很难独立改动。我更在意后一种情况,尤其是在我们频繁改动的代码里。
一次 CI 重构很好地说明了这种区别。主生成器文件缩短了不少,但生成器加上新模块之后,总行数反而更多。按职责命名、用可执行检查来验证,这样的结构才有用。总行数根本无法准确描述这次改动。
我仍然希望模块小一些,前提是能让智能体专注处理一段行为,不必重新摸清整个应用。清晰的输入、输出和测试,比行数限制更适合作为划分模块边界的依据。
重复代码和 lint 规则同样需要审视
我们还用 jscpd 查了复制粘贴的代码,找到了一些值得关注的候选,比如浏览器端和服务端各自实现的共享转换逻辑。如果两份代码本该遵循相同规则,这类重复就值得深入排查。
但文本相同只是重复的一种。两个实现可能用不同语言编写、看起来毫不相似,却在编码同一条业务规则。字段依赖那个例子更能说明为什么要共享行为,比一个全仓库范围的重复率百分比有说服力得多。
共享辅助函数也有代价:它可能需要不断增加标志位,才能保住彼此无关的行为。提取之前,我会先写清楚调用方真正该共享的到底是什么。
对禁用的 RuboCop 规则,我们也做了类似的审视。大小和复杂度警告是很好的起点,但它们不能证明每个被标记的方法都需要重构。有些规则能暴露被悄悄吞掉的工具故障,这类规则和我们修正循环的关系更直接。
对于一条新规则,我希望看到具体说明:它能防止哪一种错误。然后在我们启用它的范围内修掉真正的问题,让这条检查持续有用。生成一大堆警告是最容易的部分。
代码更整洁能省 token,却不能提升正确率
SonarSource 的 Priyansh Trivedi 和 Olivier Schmitt 做过一项对照研究,比较了六个 Java 和 Python 仓库的「整洁版」与「凌乱版」。用 Sonnet 4.6 跑了 660 次 Claude Code 试验,结果整洁版少了约 7% 的输入 token、9% 的输出 token;但隐藏测试的平均通过率并没有提高。
这两组仓库和任务都是研究者自己搭建的,结论只针对这个模型和这套设置。尽管如此,它仍然是有用的反证——「代码看起来更干净,agent 就更容易把活干对」这个假设并不成立。
我们自己的案例倒是给出了一些值得尝试的改进方向,但它们没法告诉我们:做一次普遍的代码清理,究竟能省多少时间。
对 DocSpring 来说,我自己的注意力往往才是瓶颈。我得挑选任务、澄清需求、审阅改动、做 QA。CI 和部署队列也会影响改动什么时候才真正到用户手里。agent 读得 token 更少确实有好处,但我没法直接把它换算成省下多少小时、多交付多少软件。
接下来我想测的东西
下一步计划做一个小规模、有明确时间盒(time-box,限定时间范围)的试点。挑一个经常改动、且已知存在返工的模块,改进它共享的行为约定或可执行的契约,然后观察接下来同类的改动会发生什么变化。
我关心的指标有:
-
花在提示、审阅和 QA 上的真人时间。
-
需要再返工一轮的修正,以及这些返工是什么造成的。
-
CI 重跑和等待发布的时间,单独记录,不计入真人工作时间。
-
发布后发现的问题。
还得记下任务类型、用的模型和运行框架(harness)。拿一个简单的 bug 修复和一个跨多个系统的功能去比,几乎说明不了什么。
如果你也在琢磨同样的问题,可以先从一个曾经反复返工的改动入手。agent 一直漏掉的是什么?把那次失败复现出来,再问一句:如果当时有共享代码、明确的类型契约或一个测试,是不是就能更早暴露问题?然后你就可以在同一个区域接下来的改动上,验证这项改进到底有没有用。
AI 让我更愿意重新翻看 DocSpring 的一些旧代码。以前因为没时间、也没信心去碰,很多改进只能一直躺在待办清单上;现在我可以去研究这些改动了。下一轮,我想把这样的机会花在那些能减少每次发布时记忆负担的改动上。