标题:GPT-6 Astra 在 Artificial Analysis 编程智能体指数中大幅跃升
2026年9月3日
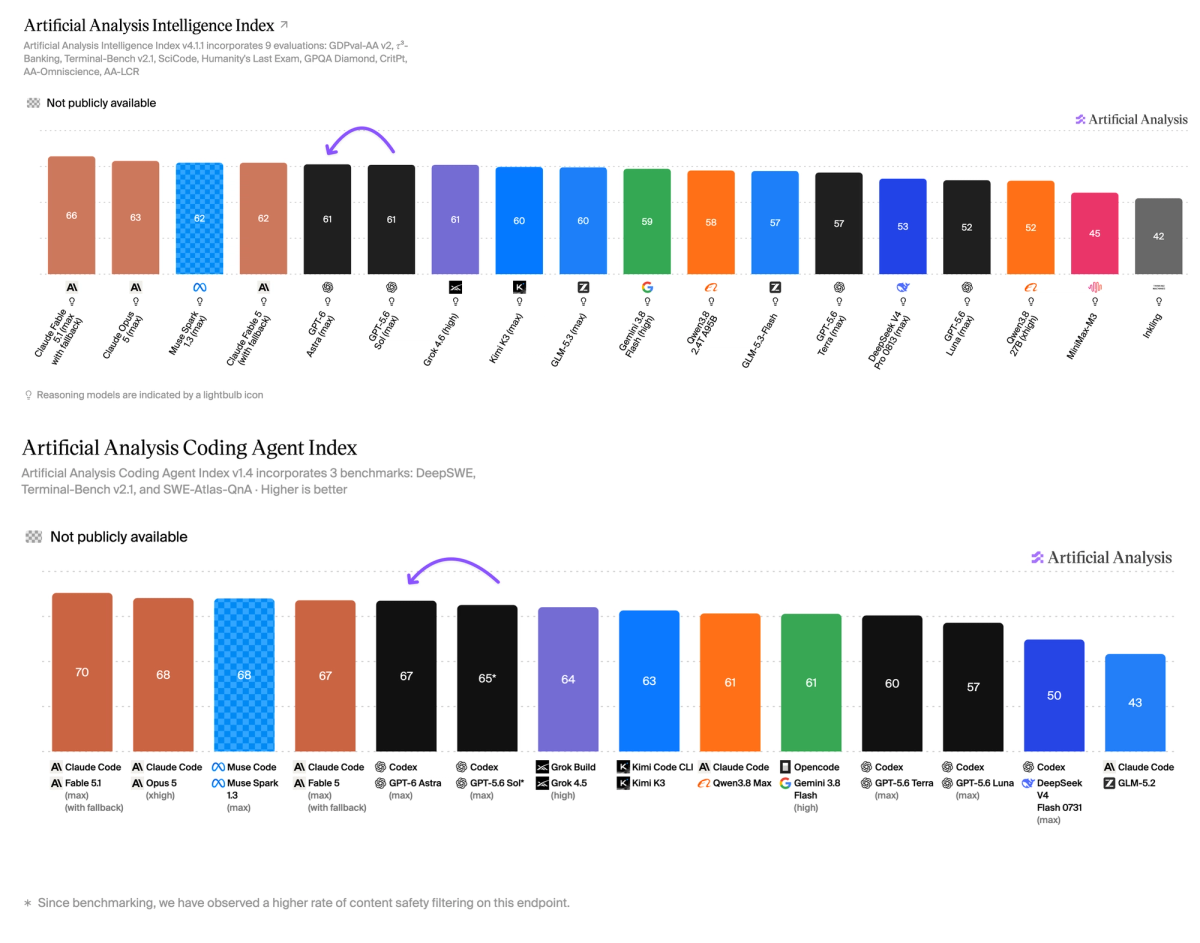
GPT-6 Astra 在 Artificial Analysis 编程智能体指数(Coding Agent Index)中进步显著,得分与 Fable 5 持平,但成本更低。在智能指数(Intelligence Index)中,它完成类似任务所用的 token 比 GPT-5.6 Sol 更少,不过这一优势被更高的定价抵消。
GPT-6 Astra 的定价全面达到 GPT-5.6 Sol 当前价格的 2.5 倍:每百万输入/输出 token 的价格从 $4/$20 提高到 $10/$50;缓存读取仍保留 90% 折扣,缓存写入则需要额外支付 25% 溢价。
在我们两大旗舰指数中,情况截然不同。在 Artificial Analysis 编程智能体指数中,GPT-6 Astra 凭借显著的 token 效率提升,以不到一半的成本追平 Fable 5。而在 Artificial Analysis 智能指数中,GPT-6 Astra 在相近性能下比上一代更省 token,但这一优势被涨价抵消。
Artificial Analysis 编程智能体指数——要点:
➤ 比肩顶级模型:在 Codex 环境中,GPT-6 Astra 的指数得分为 67,与 Claude Code 中的 Claude Opus 5、Fable 5,以及 Muse Code 中的 Muse Spark 1.3 基本持平。Claude Code 环境下的 Fable 5.1 以 70 分领先指数。
➤ token 效率比 GPT-5.6 Sol 高 70%:GPT-6 Astra 的 token 效率明显提升。在 Codex 测试环境中,它所用 token 仅为 GPT-5.6 Sol(max 模式)的三分之一;也只有 Claude Opus 5(xhigh 模式)的五分之一。该模型不同的推理强度档位都处在 token 效率的帕累托前沿上。
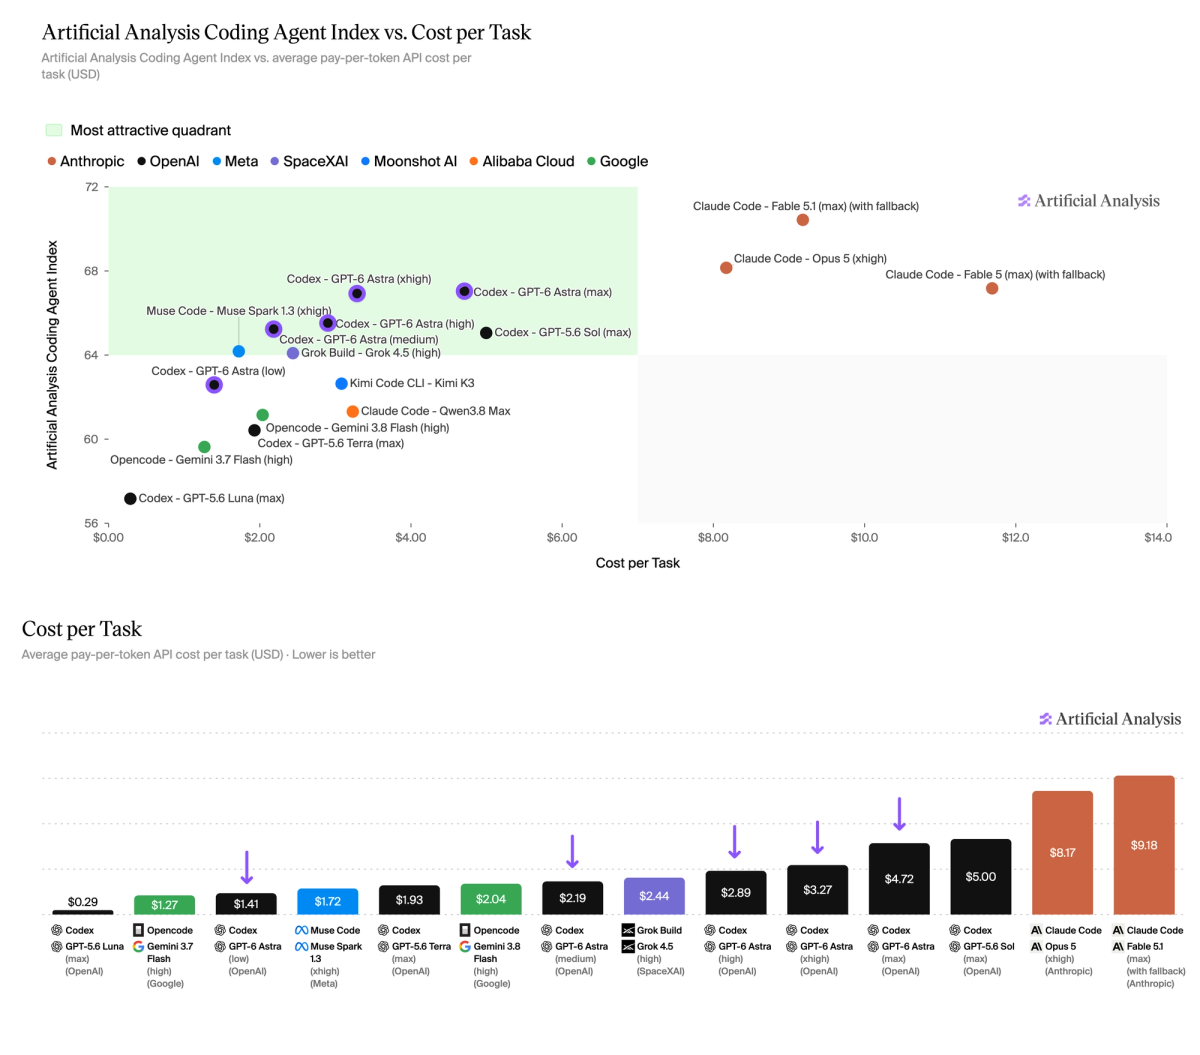
➤ 领跑编程智能体指数的性价比前沿:在 max 推理强度下,GPT-6 Astra 的单任务成本和 GPT-5.6 Sol(max)差不多,但指数得分高出 2 分。与 Claude Fable 5 相比,它拿下同样分数时,单任务成本不到后者的一半。
Artificial Analysis 智能指数——要点:
➤ 智能水平与 GPT-5.6 Sol 相当:GPT-6 Astra 在该指数中得分 61,与 GPT-5.6 Sol 持平,比 Claude Fable 5.1(max + fallback 模式)低 5 分,也低于 Meta 新发布的 Muse Spark 1.3(max 模式)。
➤ 输出Token减少约10%,但涨价抵消了优势:GPT-6 Astra在「智能指数 vs 每任务输出Token」上定义了新的帕累托前沿——最高强度下,相比GPT-5.6 Sol,Token用量减少了约10%。但由于价格涨了2.5倍,最高强度下每任务成本反而比上一代贵了75%。
➤ 幻觉率只有GPT-5.6 Sol的一半:GPT-6 Astra在我们用于衡量知识与幻觉的AA-Omniscience基准上大幅跃升。这主要得益于最高强度下幻觉率从92%降到51%。而且和某些模型不同,这次提升没有牺牲准确性——Astra的准确率还同步提高了4个百分点。
➤ AA-Briefcase Elo提升约80分:GPT-6 Astra在AA-Briefcase(我们的前沿长周期知识工作评测)上提升了约80分。该评测模拟长达数周的项目,包含大量相互关联的任务和数千个源文件。与上一代相比,Astra在评分标准和Analytical Quality Elo上都有显著提升;但在另一个方向上,Presentation Quality Elo出现了下降——这一项上GPT-5.6 Sol(max)依然领先所有模型。
➤ 其他评测结果好坏参半:模型在Humanity‘s Last Exam上提升了6分(这是一项侧重于数学、科学和人文学科的长期评测),但在GDPval-AA v2上却跌了约80 Elo——该基准改编自OpenAI的数据集,用于衡量44种职业中的经济价值任务。此外,我们还在多个能力维度上观察到了2-3分的退步,包括τ³-Banking(客服支持)、SciCode(科学领域的Python问题)以及AA-LCR(大文档长上下文推理)。
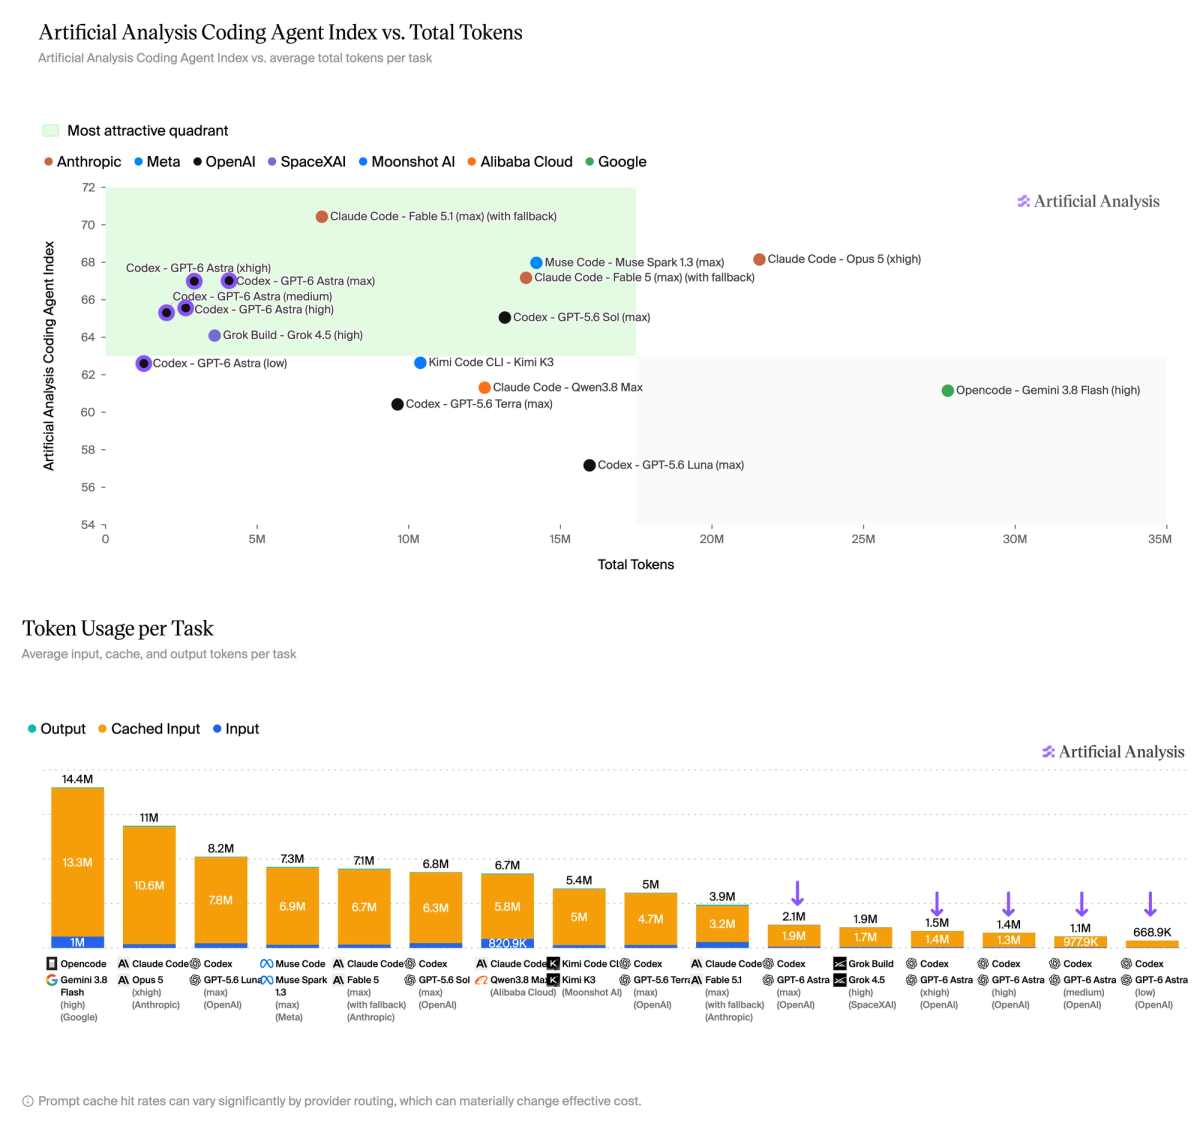
编码代理指数成本下降主要来自Token效率的提升——最高强度下Token用量相比GPT-5.6 Sol(max)减少了约3倍。
GPT-6 Astra in Coding Agent Index:刷新编程智能体榜单
GPT-6 Astra 已站上编程智能体指数(Coding Agent Index)与单任务成本权衡曲线的帕累托前沿(即性价比最优边界)。在最高推理强度(max effort)下,它的单任务成本与 GPT-5.6 Sol (max) 基本持平,但指数得分高出 2 分。
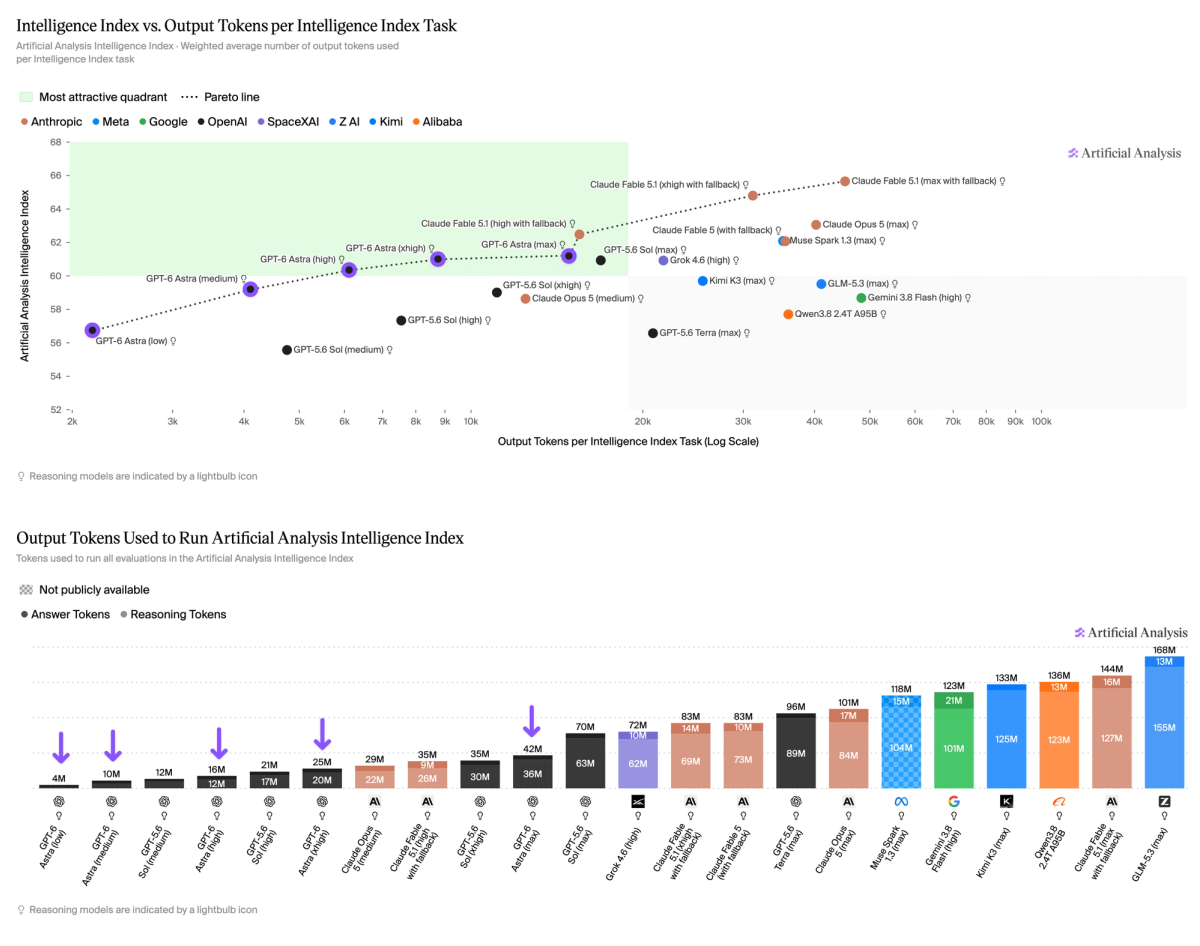
在智能指数(Intelligence Index)与单任务输出 Token 数的权衡上,GPT-6 Astra 同样定义了新的帕累托前沿——在最高推理强度下,输出 Token 数比 GPT-5.6 Sol 减少了约 10%。
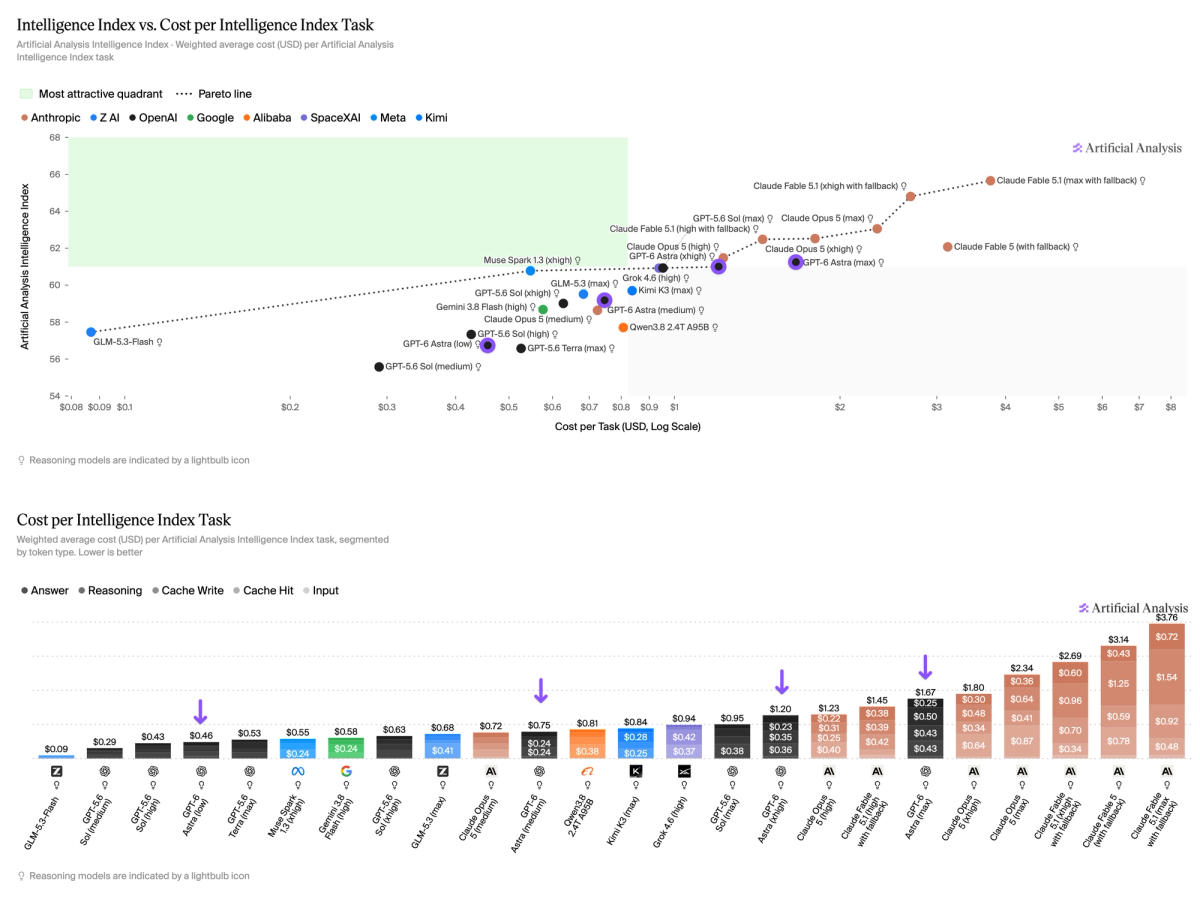
不过,在最高推理强度下,GPT-6 Astra 的调用成本比 GPT-5.6 Sol 贵 75%,因此在智能指数与单任务成本的权衡曲线上,它大体仍落在前代产品之后。这主要是由于价格涨了 2.5 倍,虽然 Token 用量下降带来部分抵消,但整体性价比仍未反超。
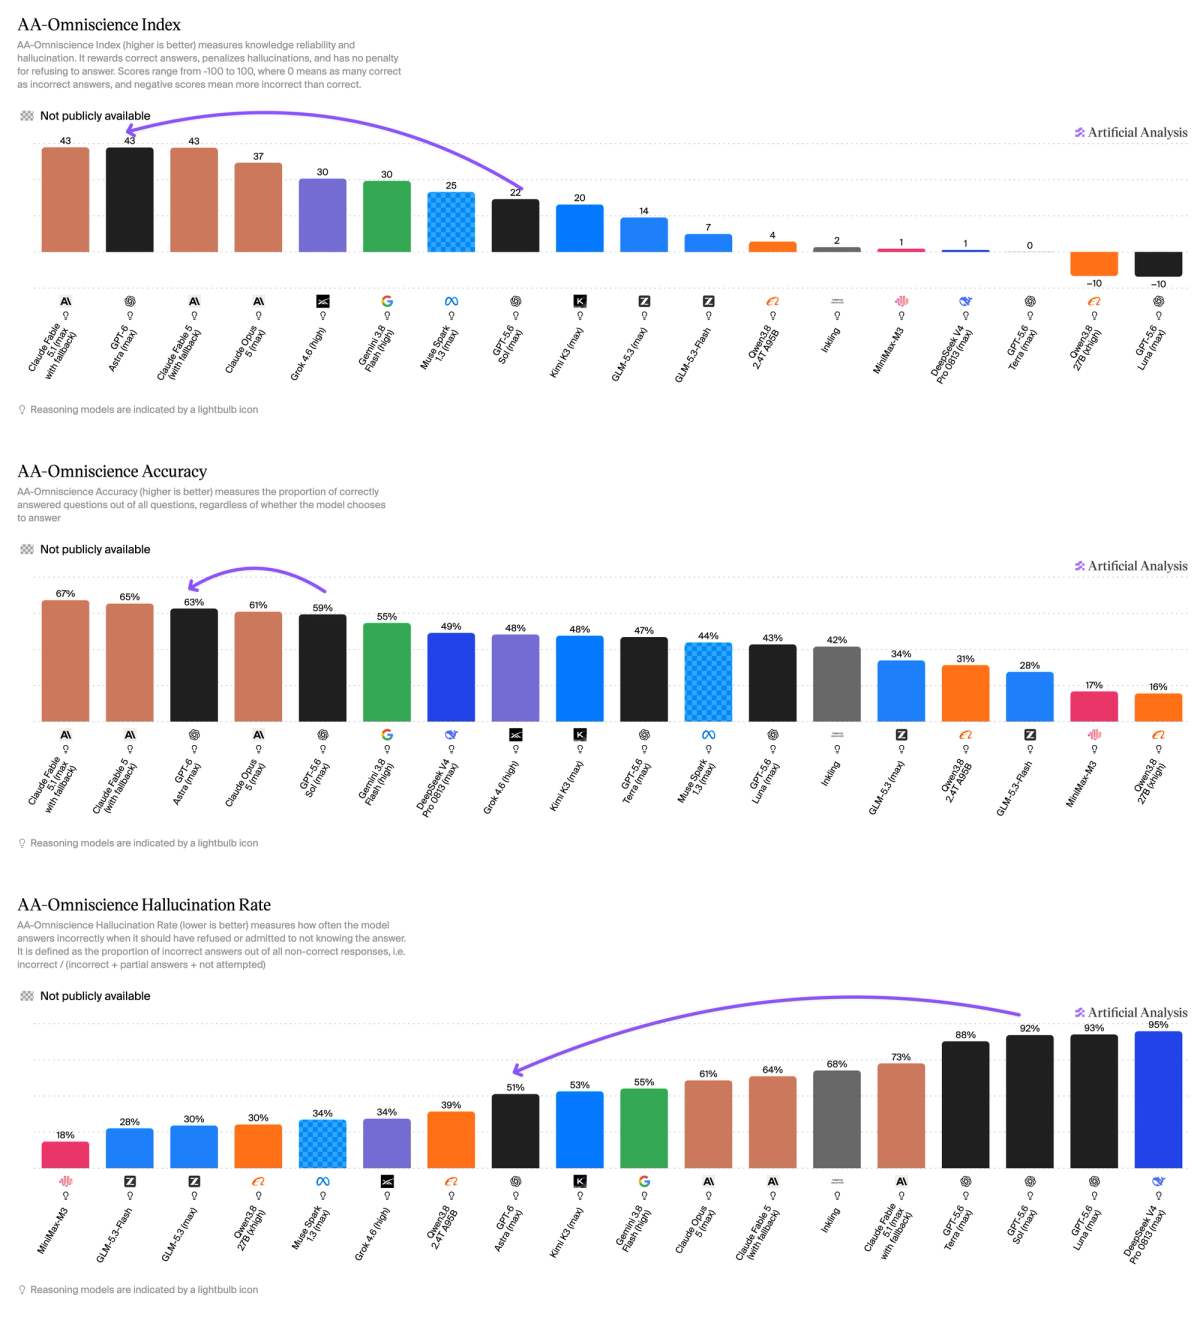
GPT-6 Astra 在 AA-Omniscience(综合知识评测)上实现了大幅跃升,主要归功于幻觉率的显著下降:在最高推理强度下,幻觉率从 92% 降至 51%,同时准确率也有小幅提升。
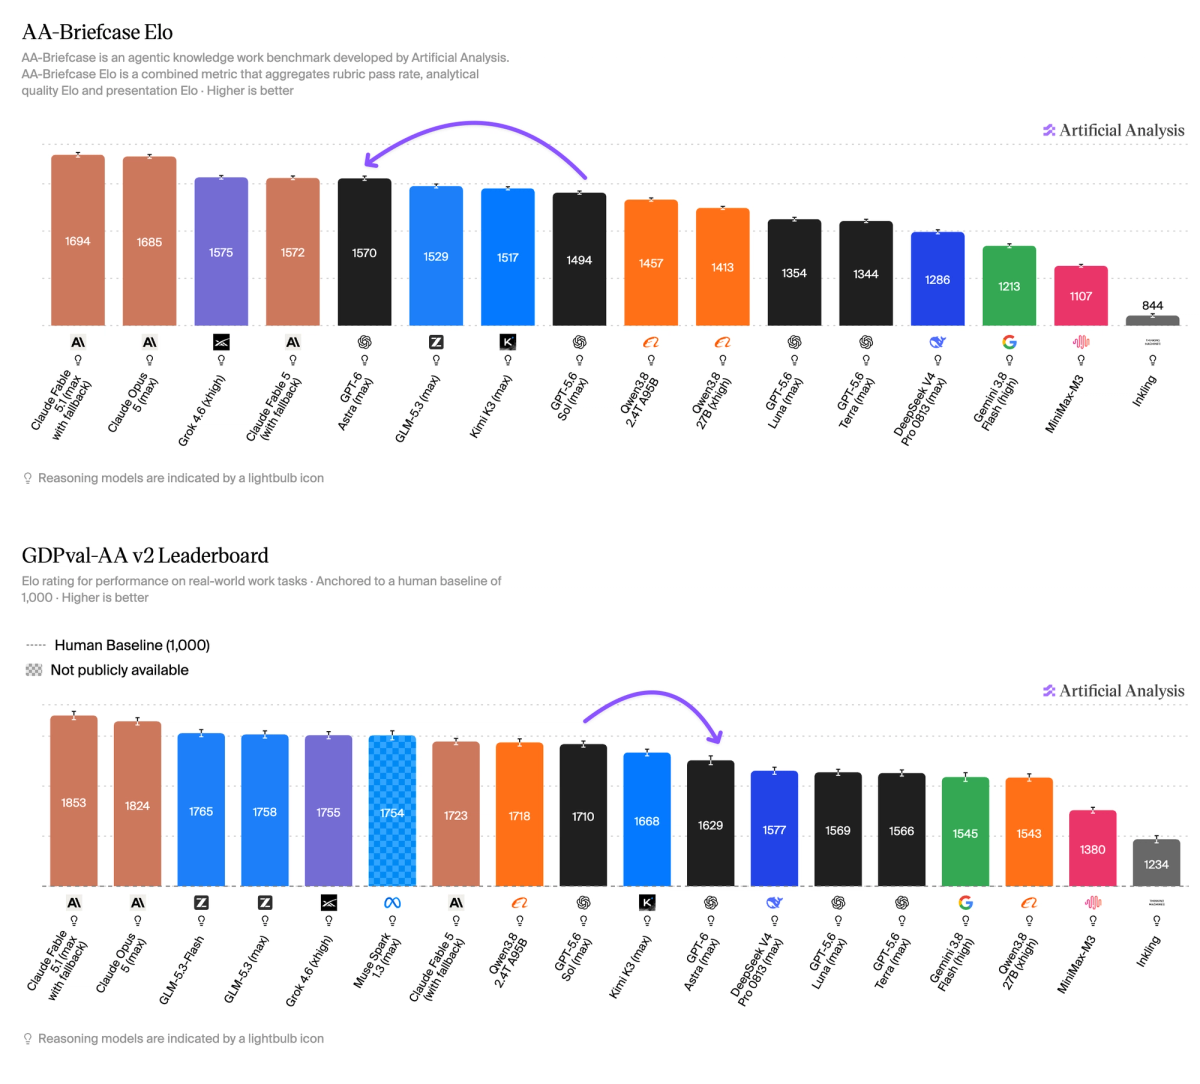
在智能体知识工作方面,该模型的表现则喜忧参半——AA-Briefcase(简报类工作任务评测)提升了约 80 分,但在 GDPval-AA v2 上却退步了相近的幅度。具体到 AA-Briefcase,Astra 的评分标准和分析质量 Elo(Analytical Quality Elo)均有明显提升,但演示质量 Elo(Presentation Quality Elo)有所下降。
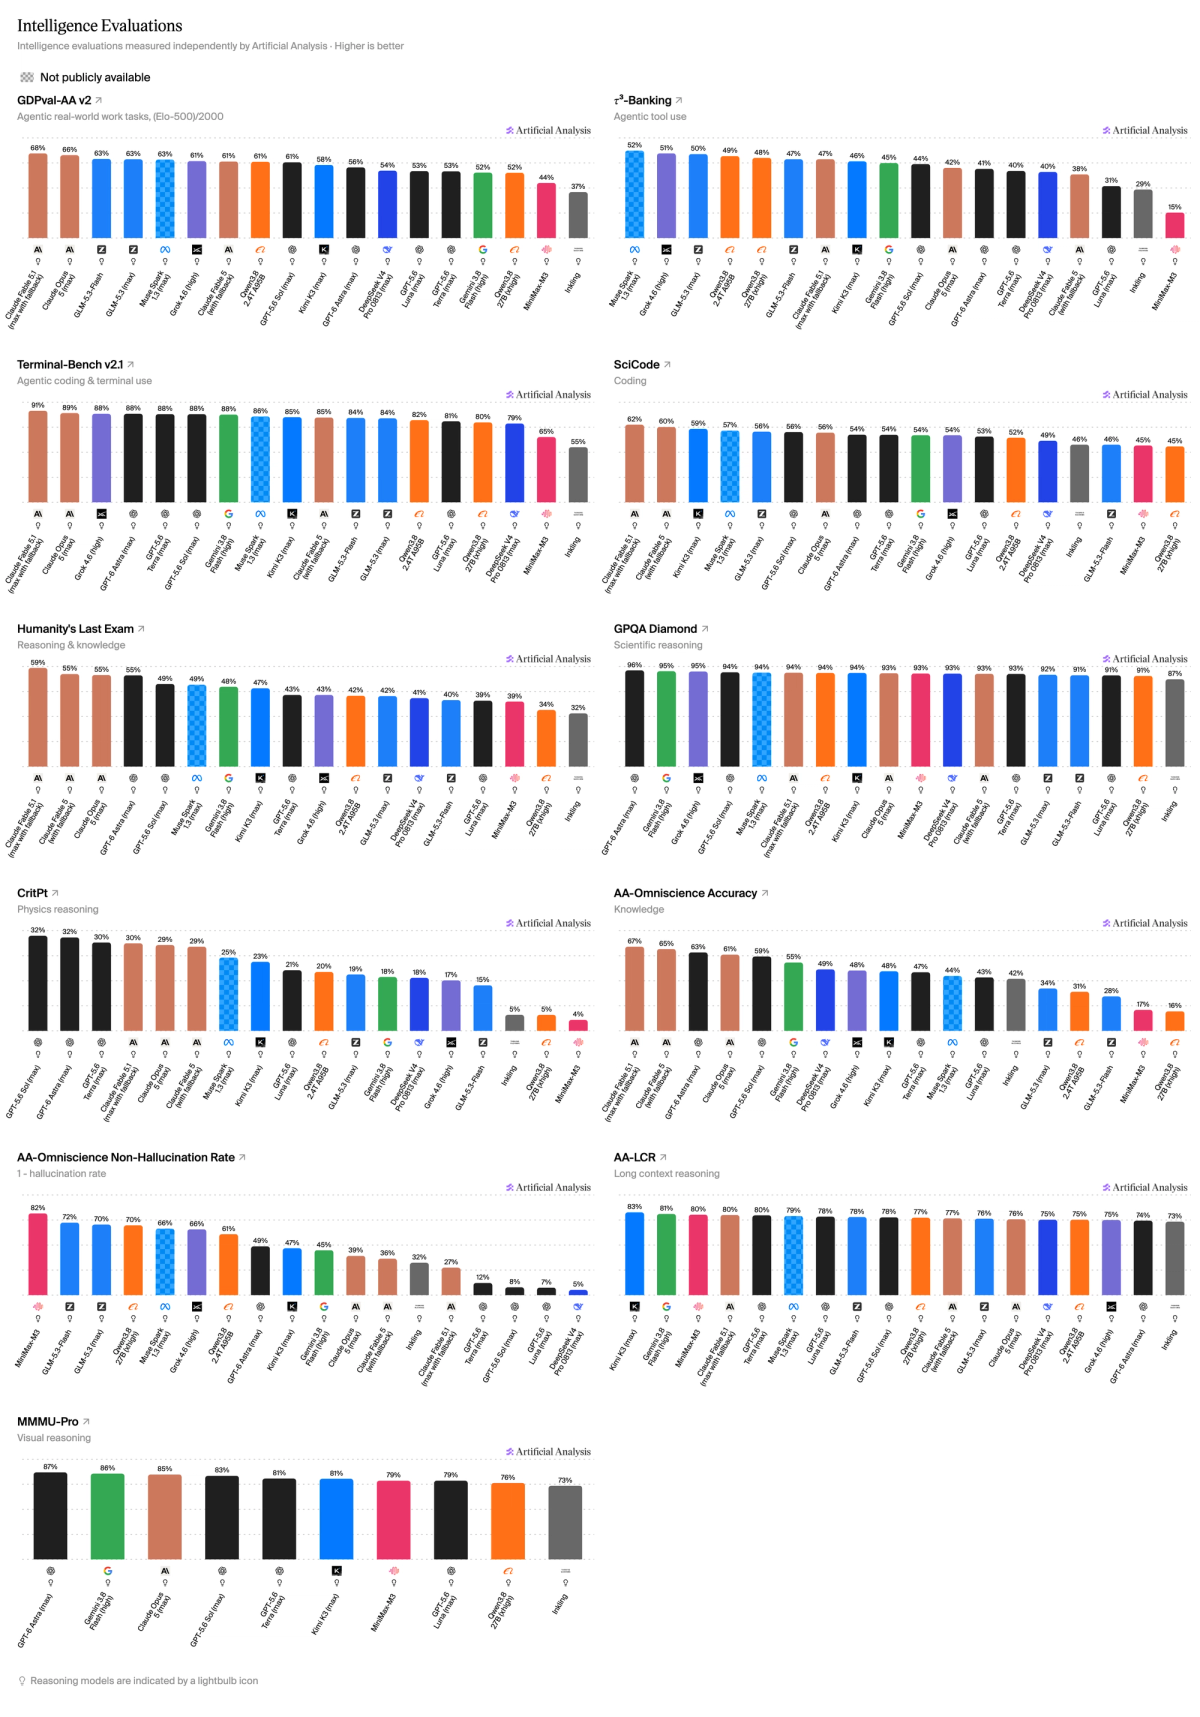
上图为 Artificial Analysis 智能指数 v4.1.1 中各项子评测的详细结果。
将 GPT-6 Astra 与其他主流模型对比,详见:www.artificialanalysis.ai
最新发布
Muse Spark 1.3:Meta 跻身前沿
Meta Muse Spark 1.3 的独立分析与基准测试
2026 年 9 月 2 日
GPT-6 Astra 在 Artificial Analysis 编码智能体指数中取得重大进展
Google 不到四个月推出第四款 Flash 模型:Gemini 3.8 Flash
Gemini 3.8 Flash 在 Artificial Analysis 智能指数上拿到 59 分,同时进入“智能 vs 单任务成本”的帕累托前沿。
2026 年 9 月 2 日
Claude Fable 5.1 登顶 Artificial Analysis 智能指数
Anthropic 的新一代前沿模型在最大努力模式下拿到 66 分,并在智能体知识工作场景中领先;缓存读取价格下调 75%,但只能部分抵消更高的 token 使用量。