宝马如何基于 Amazon SageMaker AI 构建工业 AI
本文与宝马集团的 Saltuk Kezer、Johannes Klepsch 和 Marvin Erdmann 共同撰写。
作者感谢 Sharlina Keshava、Thomas Welle、Christelle Xu、Nicole Meyers、Brian Jensen、Mark Norton、Alexander Opfolter(AWS),以及 Andre Luckow、Christoph Grote 和 Martin Tietze(宝马集团)对本项目落地的贡献。
宝马集团正在 Amazon SageMaker AI 上推进工业 AI 建设:用工程流程数据微调面向具体任务的 LoRA 适配器,再通过单一端点对外提供多个业务领域的能力。
大语言模型(LLM)在处理通用任务时表现很有说服力,但企业内部工程流程、自有分类体系以及行业特有的质量标准,都不在公开训练语料里。当一个任务同时受多条硬性约束限制时,光靠提示词加规则和示例,往往补不上这个缺口——因为模型从训练中从未学到哪些约束不可违反。
宝马集团的工业 AI 战略正是为了填补这一缺口:用结合工业知识与宝马自身数据、工具和流程的领域模型与智能体来解决问题。它不押注于某一个模型,而是依托一套可以持续演进的能力组合。在与 AWS 前瞻部署工程团队(Forward Deployed Engineering,FDE)为期 12 周的合作中,我们朝这个方向迈出了具体一步:在真实用例上验证方法、搭建可复用的基础设施,并弄清楚微调究竟在哪些地方能带来提示词做不到的价值。
本文介绍整体架构,梳理实际结果,并给出一个可复用的框架,供你在自己的业务领域中套用。
选对模型定制策略
企业在探索领域模型时,通常最先考虑两条路径。它们是否合适,取决于能力差距、数据可得性和目标用例。
用自有数据做持续预训练(CPT),是自下而上构建领域模型最直观的做法,但投入很大。而且经过 CPT 的模型,之后仍然需要监督微调(SFT)和强化学习微调(RFT),还得用能反映下游任务的数据来做。在 CPT 之前,先做任务特定的 SFT 可能是更务实的第一步:它能搭起评估基础设施、沉淀数据质量规范和微调方法论,后续定制可以直接复用;初始投入更小,也能更早看到可衡量的价值。
用更大的模型配上详细提示词,是合理的基线方案。但在我们的测试里,靠提示的模型会把一些硬约束当成软偏好——比如保留每个标识符、绝不编造、匹配语言、严格遵循输出结构——指令写得更细也没用。结果部分会量化这种失败模式。
要发展行业 AI 能力,一个关键前提是:为每个下游用例建立可靠、自动化的评估。没有它,就说不清常见失败模式是什么、微调到底有没有用、该不该追加数据和算力。
这次合作只覆盖三阶段中的第一阶段:先做任务特定适配,再做更广泛的多领域适配,最后才进入基础模型开发。
BMW 事件管理工作流中的两个用例
我们选择 BMW 工程事件管理工作流作为试验场。它在研发阶段暴露出设计改进机会,加快车辆问题的解决,而且贯穿整个开发流程,所以在这里学到的东西可以广泛迁移。这些数据自带两种天然的监督信号:每个工单的编辑历史,以及根因分析的结果(哪些事件被关联到同一个根本问题)。数据是双语的,德语和英语大约各占一半。
我们划定了两个用例:
-
工单质量保障:帮工程师更快写出高质量的事故工单,让问题更快分派、更快解决。这项任务拆成三个生成式子任务:把标题改写得简洁、便于分诊;把描述改写成标准结构;生成追问,帮助挖出缺失的信息。
-
事故匹配:给定一个新事故和 1–8 个候选历史事故,判断其中哪些(如果有)出自同一个根因。这是一个判别式匹配任务,帮工程师找到相关问题,避免重复排查。
这两项任务特意设计成不同类型——一个生成式、一个判别式——就是为了说明同一套基础设施对两者都适用。
方法:基准测试、数据整理、训练、评估、组合
整套方案是一条可重复的工作流:两条 Amazon SageMaker Pipelines,一条负责整理数据,一条负责训练和评估适配器(adapter);再加一个实时端点,用同一个共享基础模型服务所有适配器。生成模型和评判模型由 Amazon Bedrock 在欧盟(EU)区域运行。SageMaker 训练作业在临时 GPU 实例上训练模型适配器,Amazon Simple Storage Service(Amazon S3)存放产物,Amazon SageMaker AI 配合 MLflow 跟踪每一次实验。每一步都参数化、带缓存、有版本、可复现。下图是整体架构:绿色实线表示与 Amazon S3 之间的数据流,青色虚线表示 Amazon Bedrock 推理,紫色虚线表示 MLflow 跟踪。
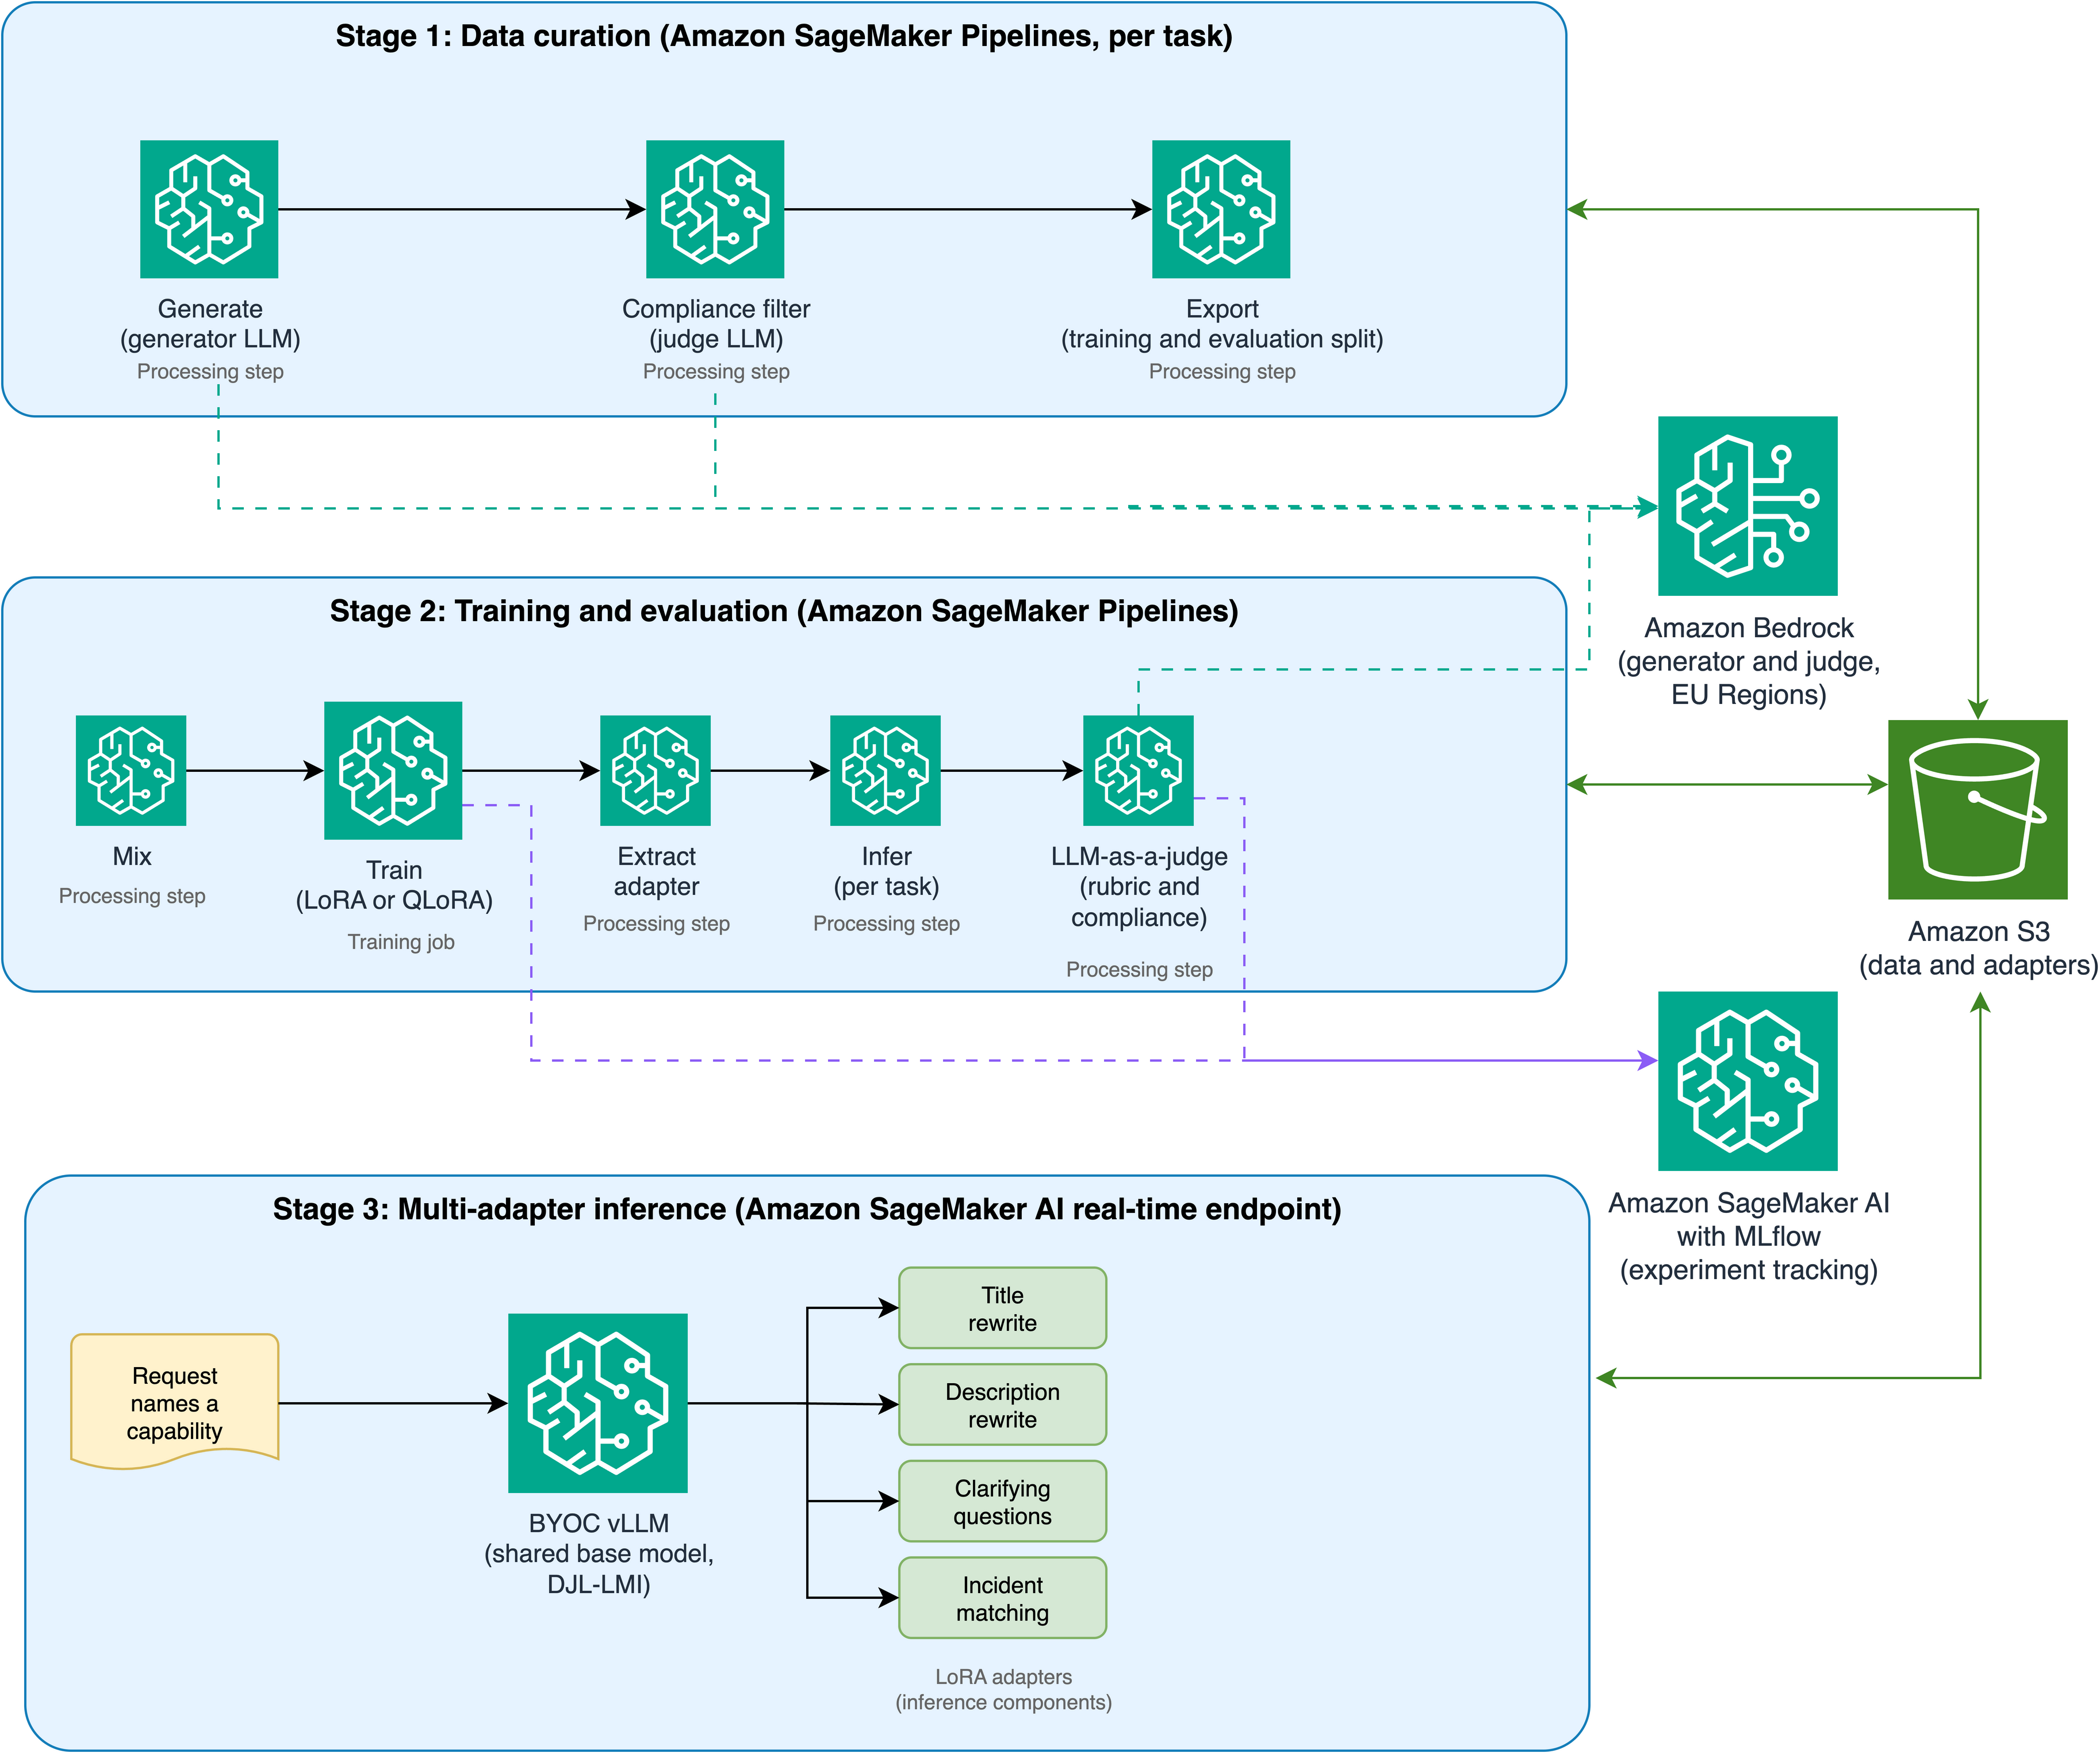
图 1:端到端架构
选模型
没有哪个榜单能完整衡量所需的双语领域推理能力,所以我们自己搭了一套双语测试集,覆盖工程推理、数学、抽取式问答和翻译任务,对 16 个基础模型(foundation models,FMs,参数量从 2B 到 235B)做了基准测试。
这轮测试最终选定了三个角色:
-
待微调的目标模型——Gemma 4 E4B。这是一个小型开放权重模型,激活参数约 4B、总参数约 8B,迭代和部署成本都很低。
-
数据整理用的生成模型——工单质量任务用 Qwen3-235B,事件匹配任务用 Gemma 4 31B。选它们是因为双语生成和推理质量好。
-
要超越的提示基线——Gemma 4 31B,大小约为目标模型的四倍,并给它完整的任务说明和评分标准。
整理训练数据
每个数据整理任务都跑在一条 SageMaker 管道上,包含三个参数化处理步骤,并配有步骤级缓存,重跑时会自动跳过没有变化的步骤:
-
生成——Amazon Bedrock 上的生成模型通过批量推理,每次运行产出数万条候选训练对。我们会随机去掉部分样本的元数据和描述,让模型学会处理新建事件时那种稀疏的输入。
-
过滤:在 Amazon Bedrock 上另跑一个评审模型,把不满足任务特定要求的样本对去掉,检查项包括无幻觉、所有标识符完整保留、结构有效、语言匹配。
-
导出:训练集和评估集按时间切分,评估只用训练截止时间之后创建的工单,避免数据泄漏,也更贴近生产环境。
生成和过滤都在欧盟区域的 Amazon Bedrock 上运行,数据留在区域内,同时把 GPU 算力省下来用于训练。
训练
所有适配器都基于同一个基础模型,用 QLoRA(4-bit NF4)训练,训练作业跑在 SageMaker 上,工具链是 Unsloth 和 Hugging Face Transformers Reinforcement Learning(TRL)。Amazon SageMaker AI 配合 MLflow 记录完整链路,从训练数据、超参数一直到评估指标都能追溯。
评估
生成式工单质量任务分两层自动评估,都通过 Amazon Bedrock 完成。
第一层是合规检查,每项都是通过或不通过的硬性门槛。改写类任务的检查项包括:
-
幻觉:不能编造原文没有的内容
-
内容保留与信息丢失:不能丢信息
-
结构:输出格式必须有效
-
语言:回复语言要和工单一致
澄清类问题的检查项包括:
-
有据可依:问题要针对真实存在的信息缺口
-
重复性:不能问工单里已经有的信息
-
语言:和工单语言一致
第二层由大语言模型(LLM)评审打分,按 1–5 分 rubric 评估工单整体质量:标题看格式精确度和分诊价值,描述看清晰度、完整性、结构和术语。
评审模型用的是 Qwen3-235B,和生成模型不是同一个,以减少确认偏误。工单匹配则用确定性指标(F1、精确匹配)。评估作为 Amazon Bedrock 批量作业跑在训练流水线里,因此每次实验都会自动产出可对比的指标。
一个端点,多种能力
LoRA 适配器只有几十 MB,而基础模型动辄几十 GB。一个基础模型就能在单个端点后面挂载多个任务适配器:调用方每次请求时指定所需的能力,所有适配器共用基础模型的 GPU 显存。下图展示了架构第三阶段的细节。
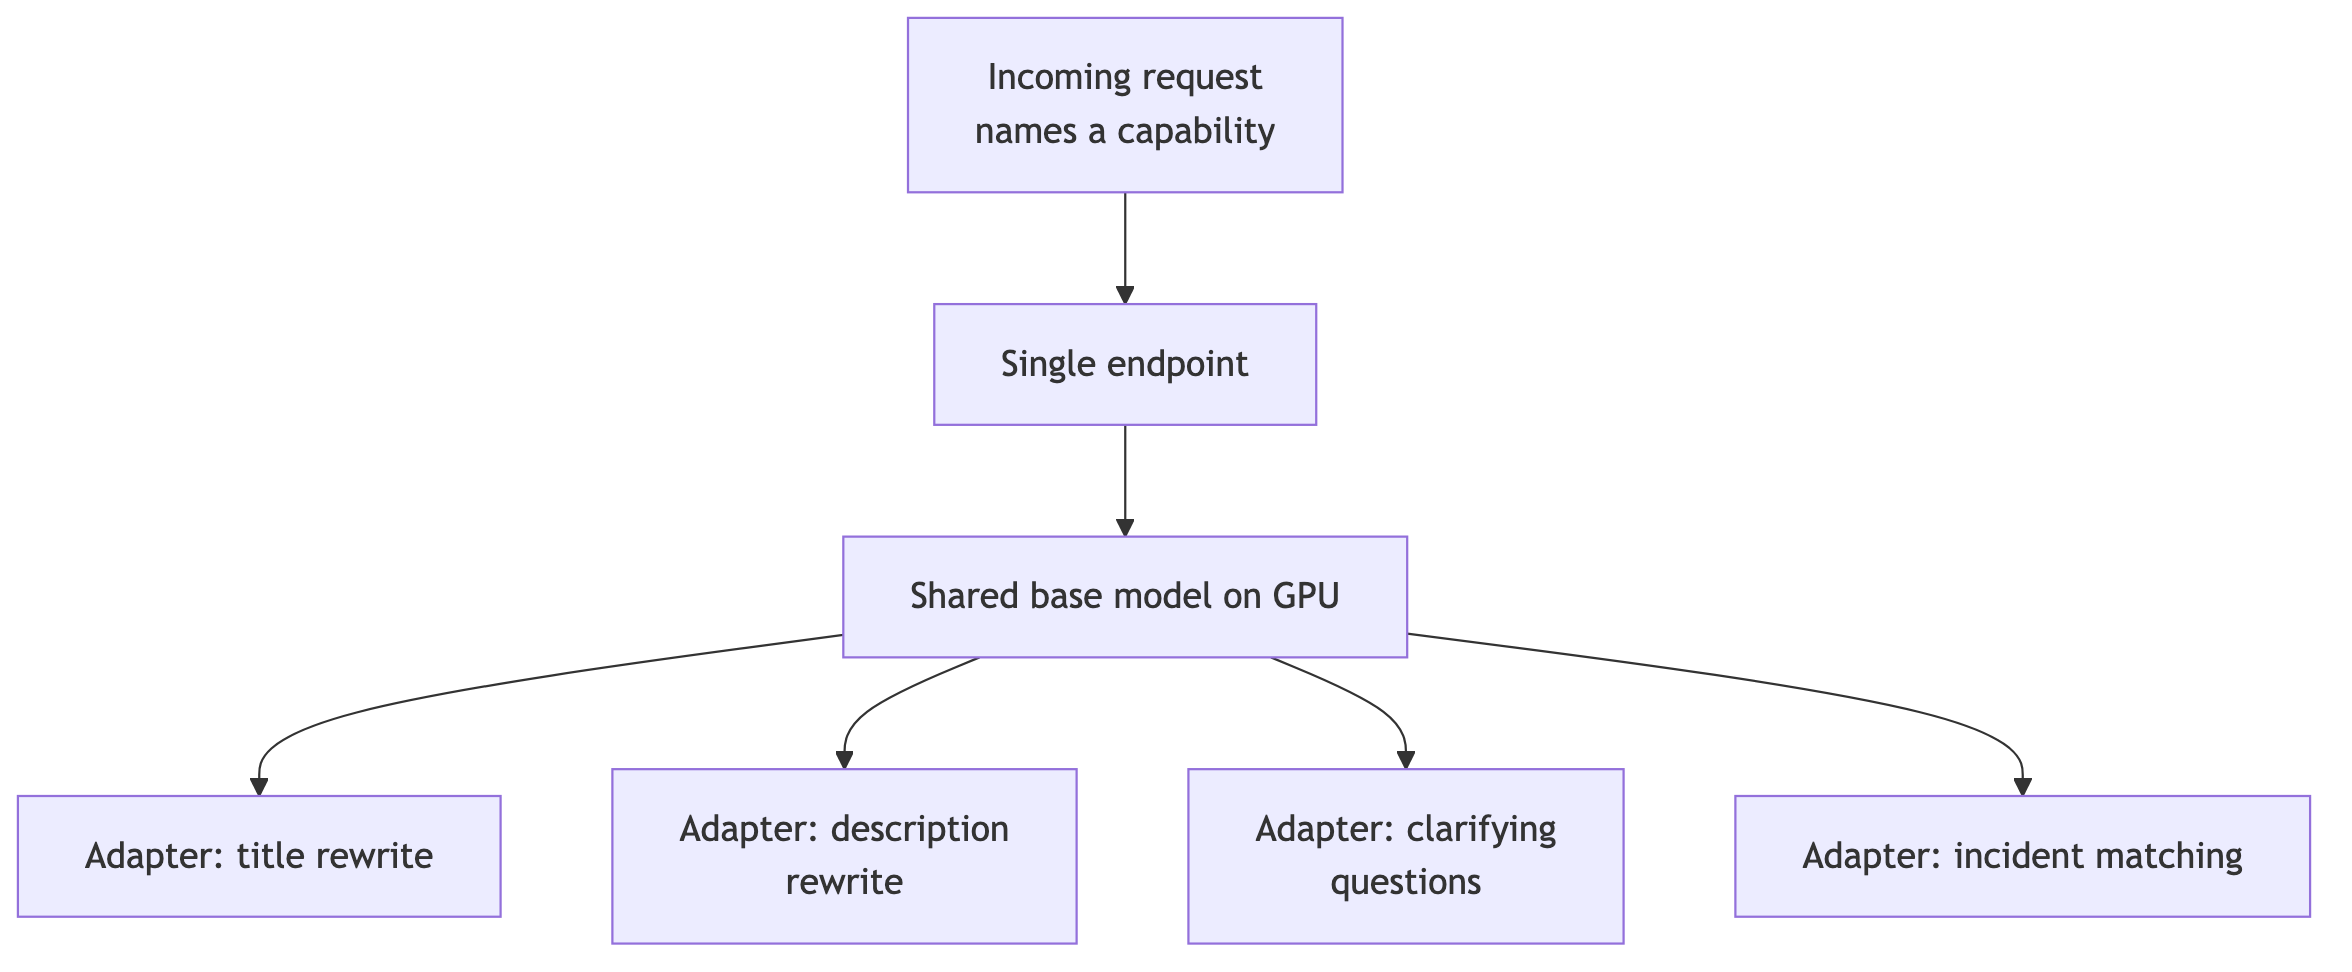
图 2:多适配器推理阶段
我们把 Amazon SageMaker 的高效多适配器推理和多 LoRA 服务与 vLLM 结合起来,部署在一个自带容器(BYOC)的 vLLM 端点上,底层使用 DJL-LMI 服务容器。基础模型和每个适配器都跑在同一块 GPU 上,每个适配器从 GPU、CPU 或磁盘加载只需几毫秒。
一个联合适配器就能服务整个任务族。以工单质量为例,单个联合适配器在全部三项任务上的表现都接近最佳,不过按任务分别训练的适配器在各自任务上依然是最优的。
结果
所有结果都来自单种子、单超参数的运行,在留出评估集上测得;事件匹配使用的是固定候选集,而非端到端检索。这些数字可以作为有力的方向性证据,但不代表调优后的上限。
工单质量保证
面对同时存在的多条约束(保留每个路由代码、绝不捏造组件、匹配工单语言、遵循六段式结构),仅靠提示词的 31B 基线模型把其中一些当成了软性偏好。它在约 19% 的标题改写中捏造了路由代码,在约 13% 的追问中没能匹配语言。用精心筛选、通过所有校验的样本做微调后,问题解决了。微调后的模型在标题改写上的合规率提高了 8 个百分点,追问提高了 13 个百分点,描述任务上的差距也缩小到 1 个百分点以内。下图展示了各任务的合规率。
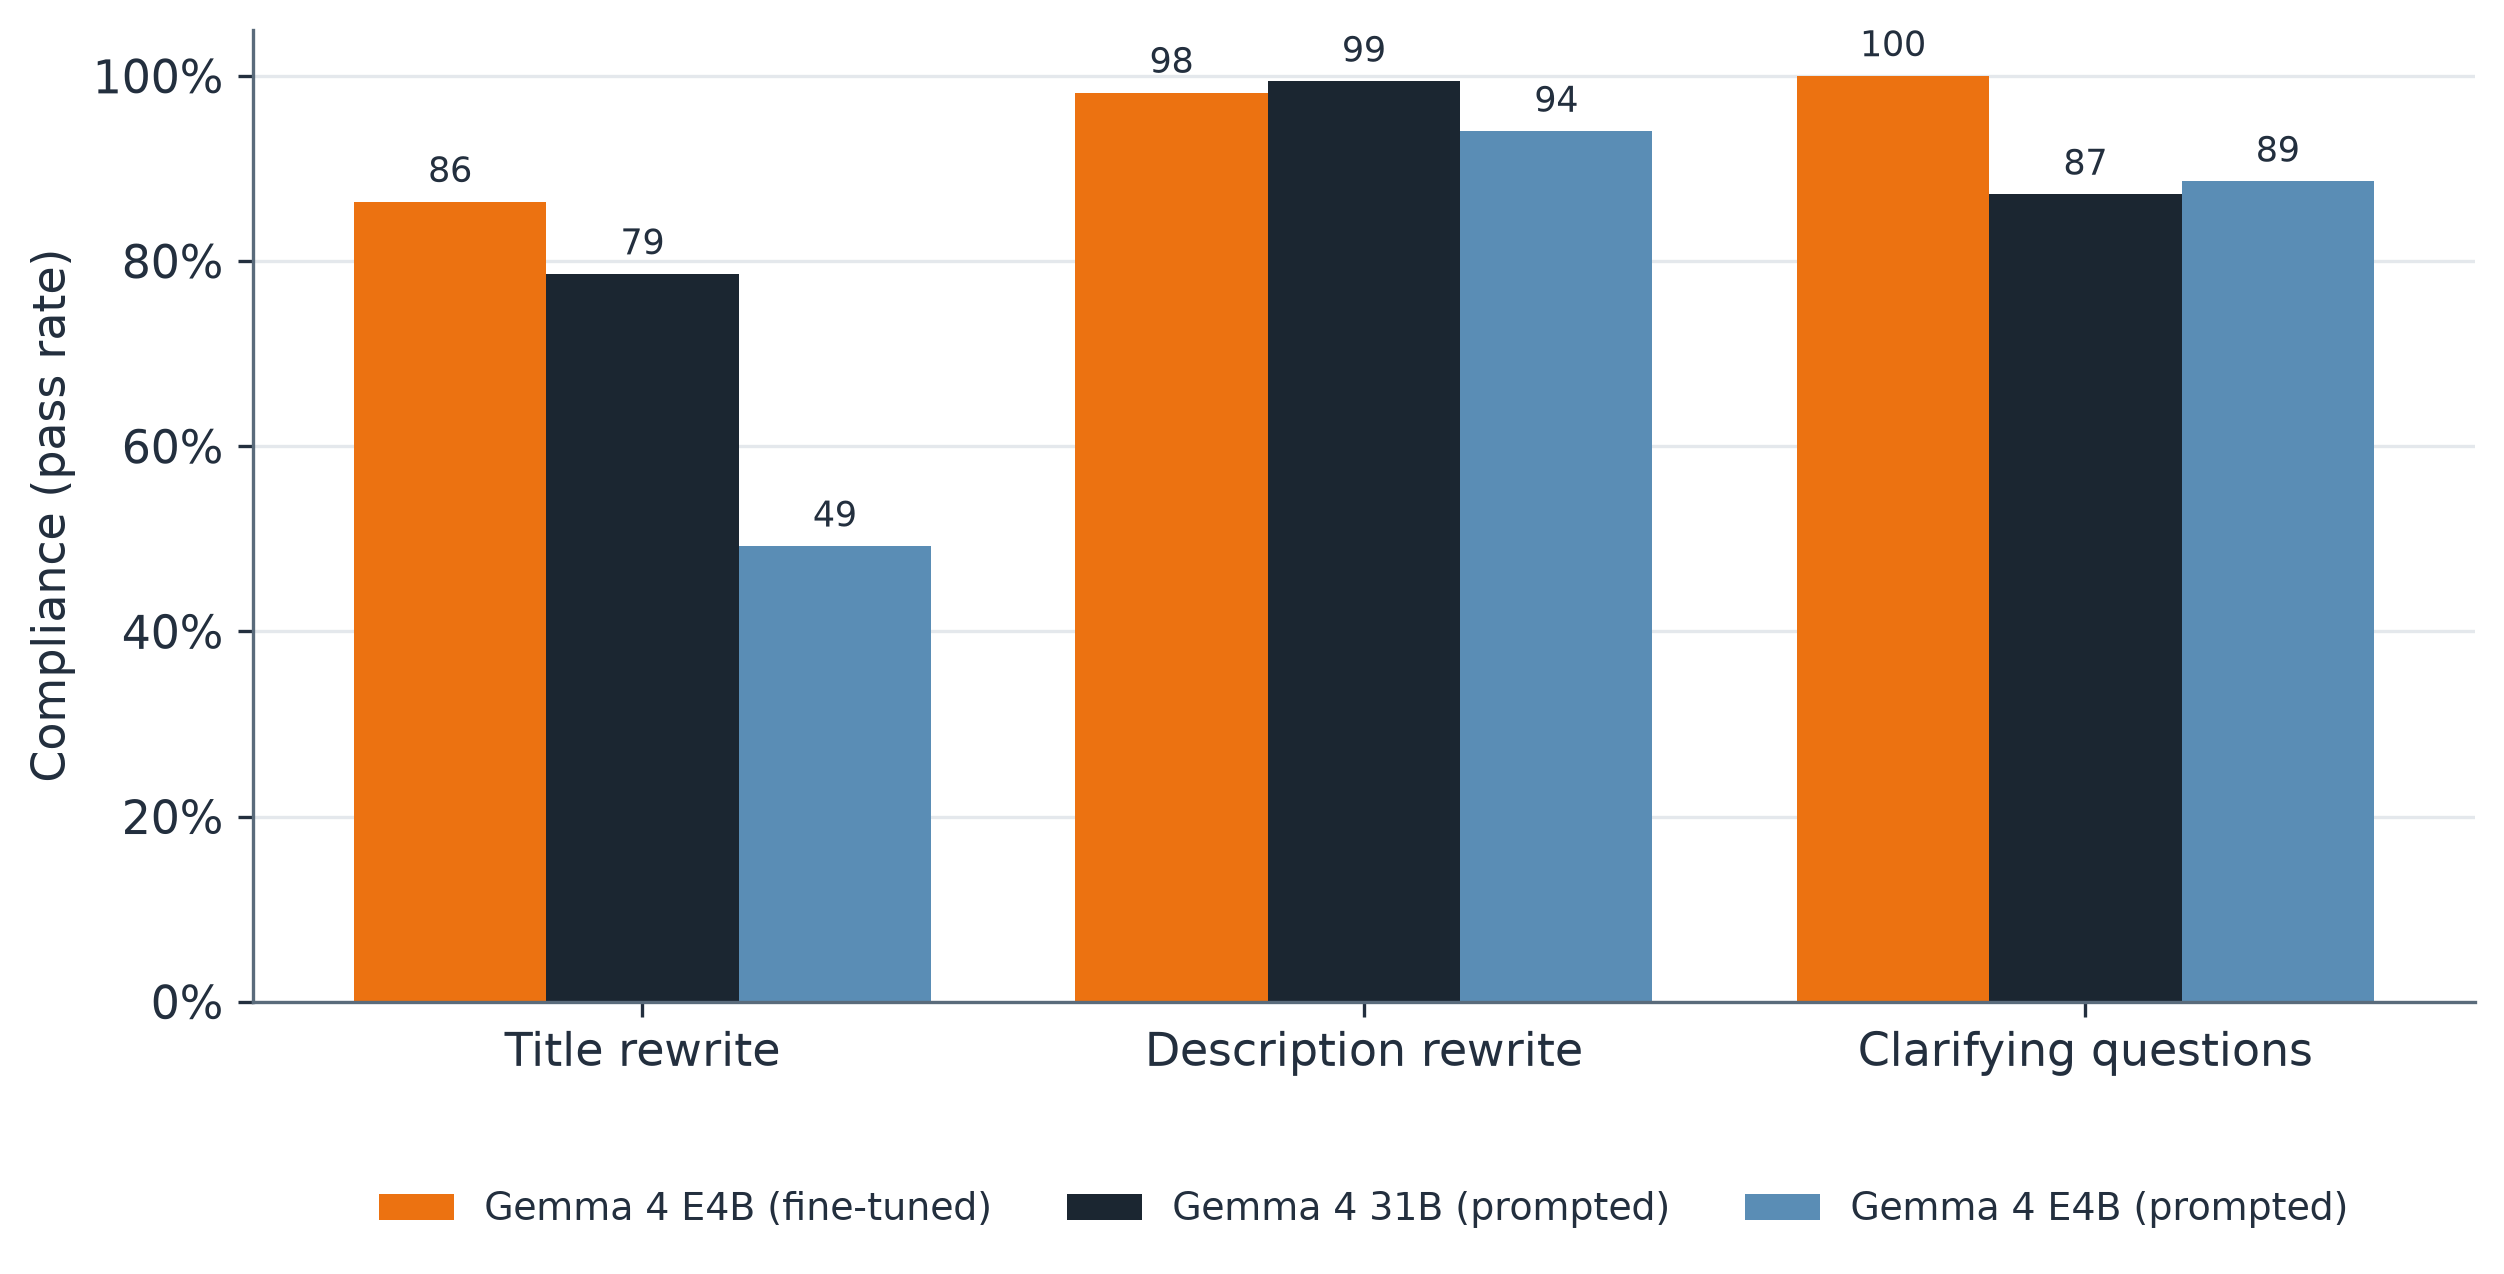
图3:按任务分类的工单质量合规情况
在 1–5 分评分标准下,所有模型的质量都明显高于人类基线(即原始工单)。微调模型将标题质量从 3.74 提升到 4.71,描述质量从 2.84 提升到 3.87,在标题上与更大的提示词模型持平(4.75),在描述上超过后者(3.77),同时在合规性上胜出。目前剩下的主要差距是描述完整性(2.78/5):这是有意为之,模型不会虚构报告人未提供的信息,而“澄清问题”任务通过在开头主动询问来补上这一缺口。下图展示了各任务的评分质量。
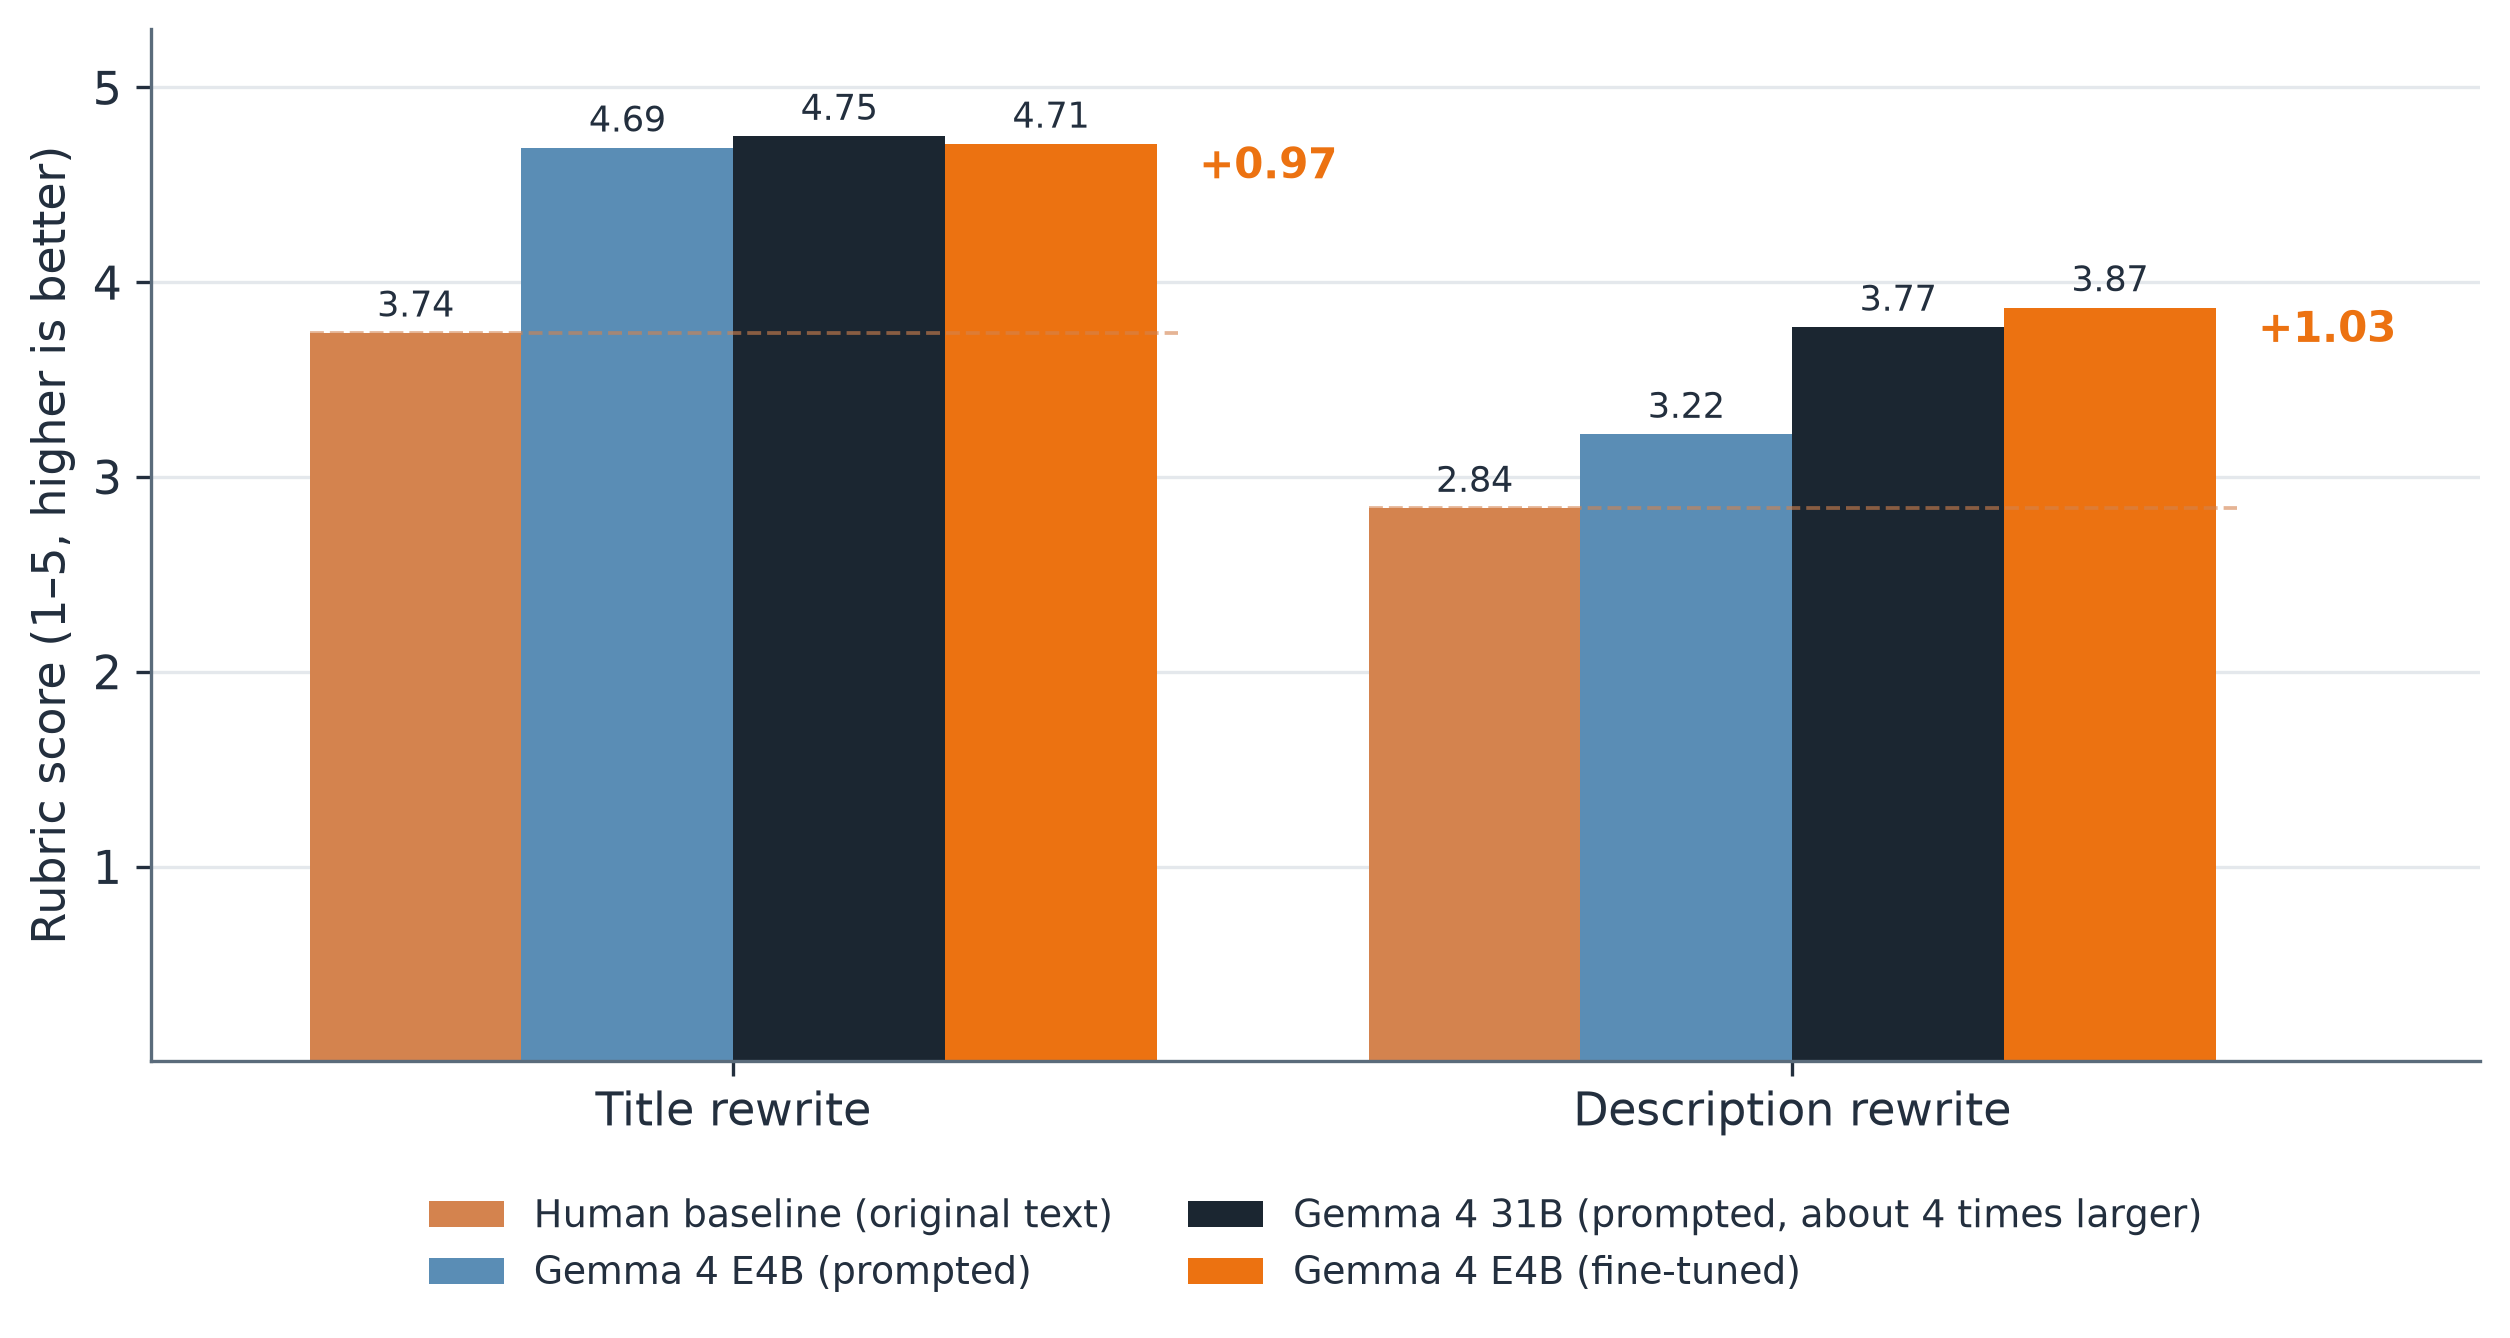
图4:各任务的评分质量(1–5 分)
事件匹配
提示词模型表现出一种“倾向于找关联”的偏差:即使候选事件没有共同的根因,它们也会识别出匹配项。微调后的联合适配器在每个候选集规模上都优于提示词基线(后者规模约为其四倍),F1 分数高出约 9.6 到 14.7 个百分点。大部分提升来自能够识别“无匹配”情况并返回空列表。在两个候选事件的情况下,更大的提示词模型“无匹配”F1 为 47%,同规模提示词模型为 25%,而微调适配器达到 70%。不同寻常的是,随着候选集增大,它的“无匹配”F1 反而上升,如下图所示。
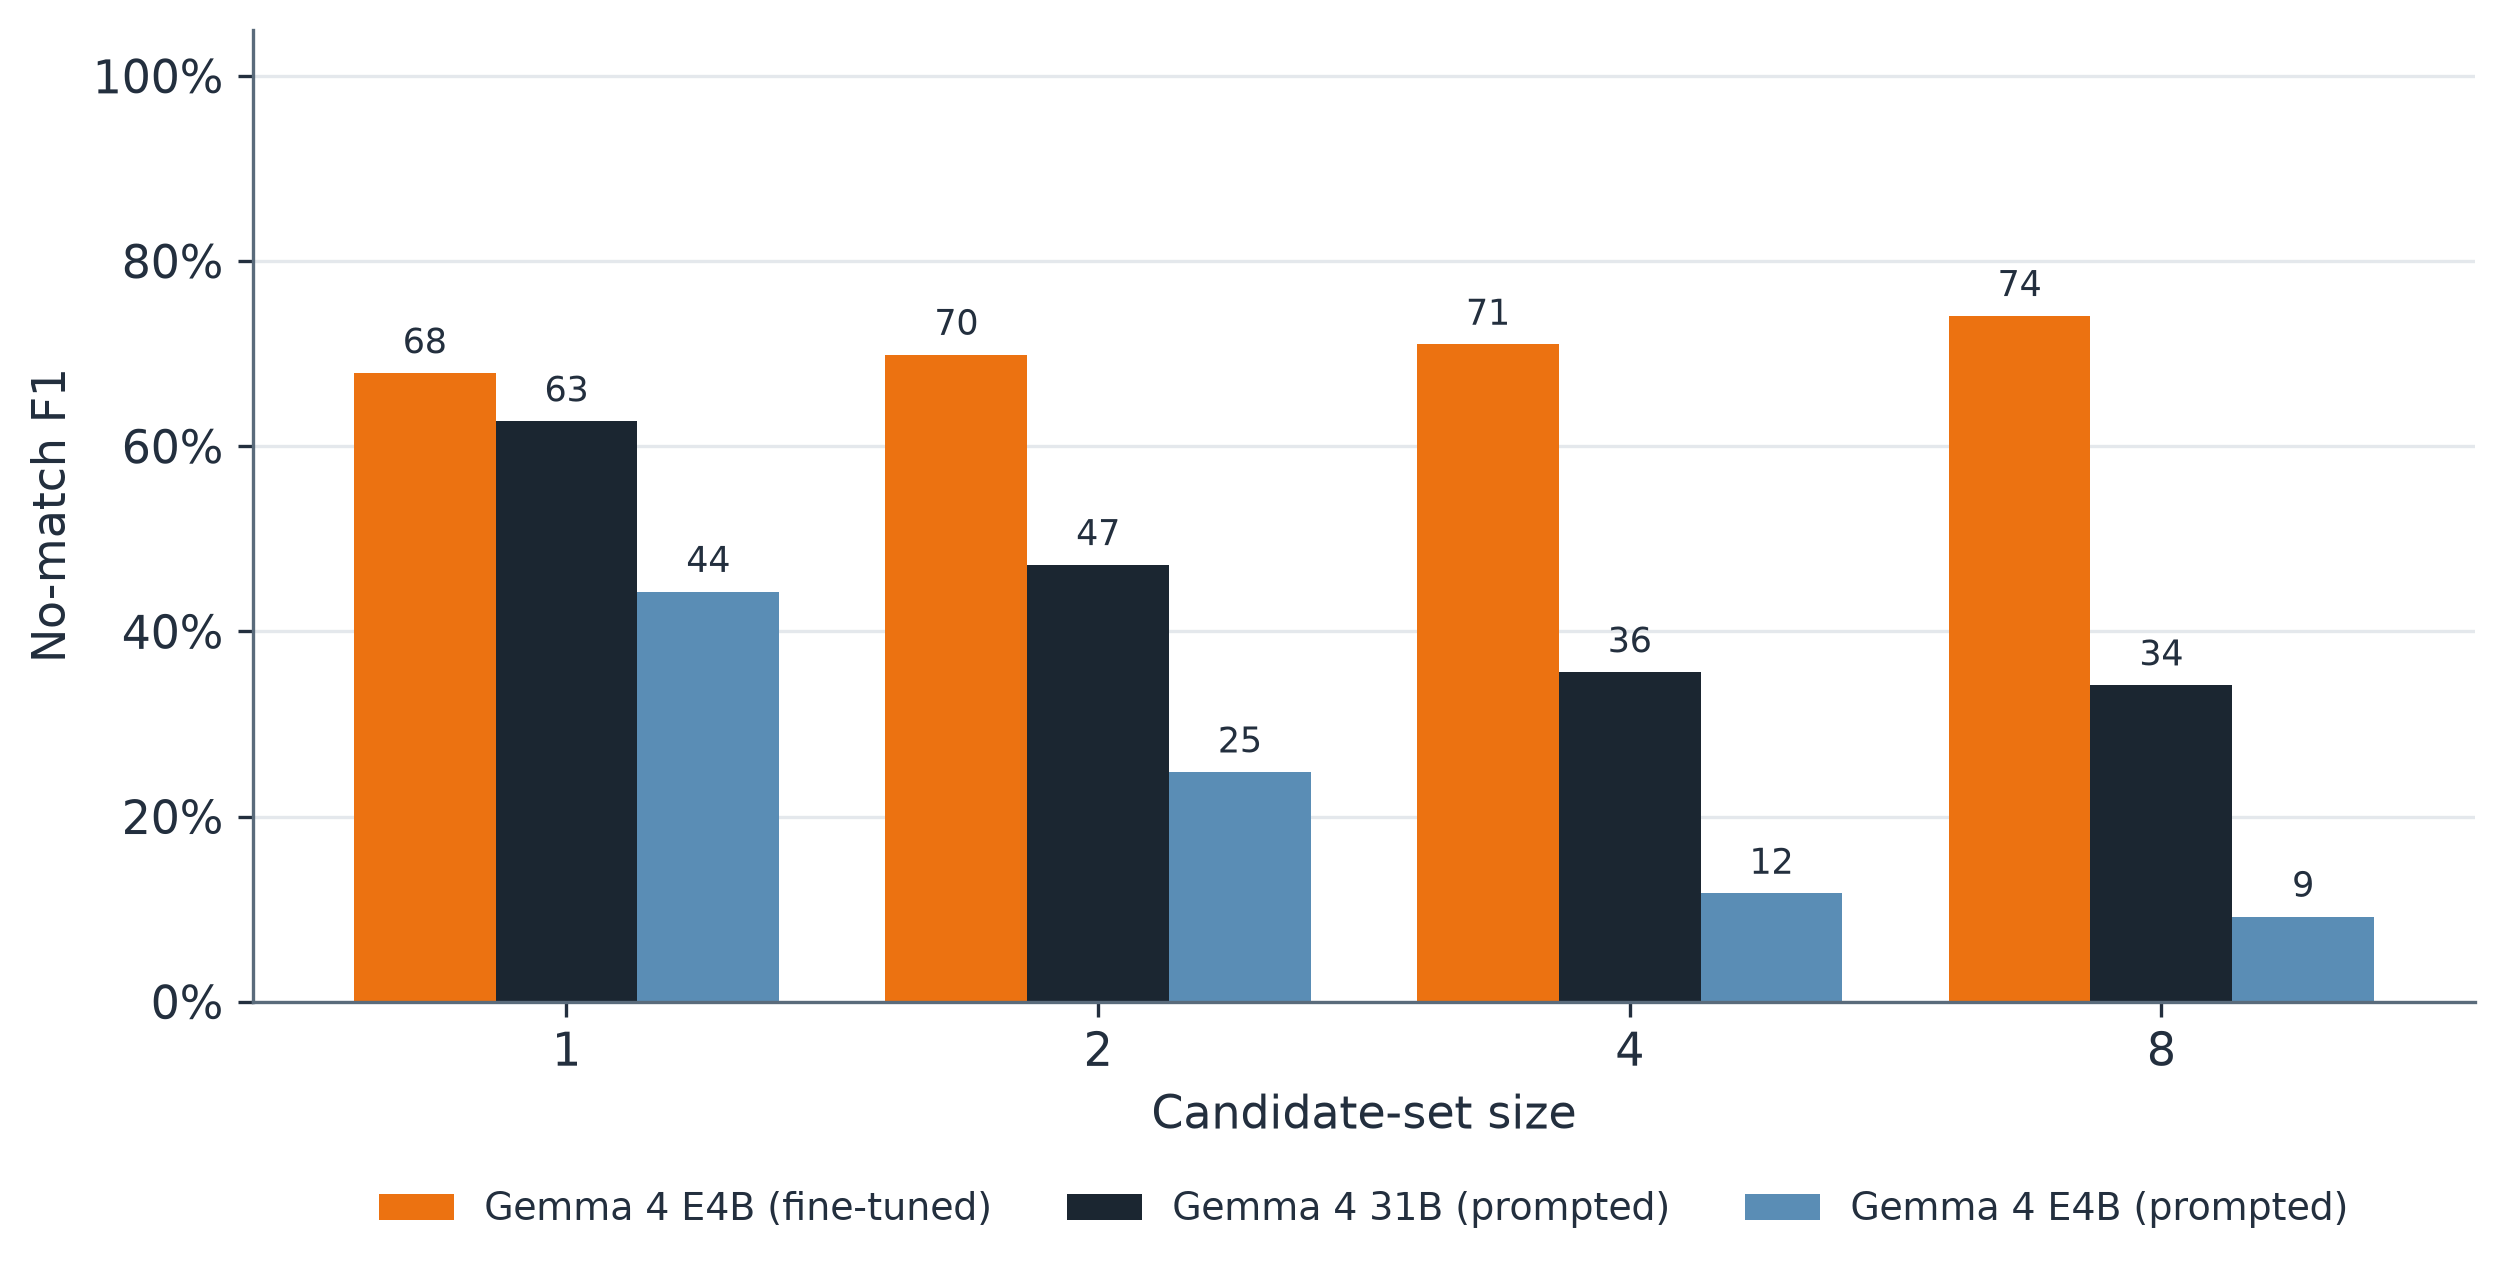
图 5:按候选集规模统计的无匹配 F1
一套可复用的框架
这次合作沉淀出一套可复用的四步框架,用来逐步搭建 Industry AI 能力:
-
映射用例——把所在领域的用例梳理出来,对照可用数据和当前模型能力,判断哪些能做、哪些还不能做。
-
逐个用例推进——为每个用例定义评估方式和现成基线,整理高质量训练数据(筛选要狠:违反合规要求的数据,只会教会模型去违反合规),再训练一个小型的任务专用适配器。
-
组合——找出结构足够相似、适合联合训练的任务,用同一个端点统一提供服务。
-
让残余差距决定真正的投入方向——如果 SFT 和 RFT 都补不上差距,说明你已经用证据找到了需要预训练或架构改造的理由。
可复用的资产包括:可配置的评估工具、数据整理模板、训练流水线、适配器注册表,以及多适配器服务能力。用例定义、评估标准、整理后的领域数据和适配器产物,控制权都留在 BMW 手里。这些是保护 BMW 知识资产、并在未来比较不同模型方案时的战略控制点。之后每个数据相似的用例都能复用这套基础设施,成本比第一个用例低得多。
结论
BMW 集团的 Industry AI 战略是一场跨越领域专用模型和智能体的多年旅程。要朝这个方向走得最快,并不是一上来就预训练一个巨型模型——那条路又贵又慢,而且之后照样需要同样的微调和评估基础设施。
“我们训练了一个80亿参数的小型专用模型,其质量大致相当于310亿参数的提示模型。在我们的评估中,它的质量得分高出25%以上。借助Amazon SageMaker AI Training Jobs管理训练基础设施,我们能够专注于AI工程,同时将数据安全地保留在AWS环境中。” —— Andre Luckow,BMW集团IT创新与新兴技术负责人
本文介绍了如何识别现成模型的不足,在精选的领域样本上微调小型适配器,将它们组合在一个端点后面,并进行严格评估。在我们的实验中,在体现BMW业务流程的高质量样本上进行微调,解决了比它大四倍的提示模型的失败问题。按照这种方式推进的每个用例,要么直接交付价值,要么以证据表明下一笔投资应该投向哪里。
延伸阅读
-
使用Amazon SageMaker Pipelines和MLflow进行大规模LLM实验
-
在Amazon Bedrock Model Evaluation上使用LLM作为评判者
-
Amazon SageMaker AI上的高级微调方法
-
为监督微调准备数据,第1部分:格式与质量