Claude Opus 5.5 如何在 38 分钟内做出一部定格动画 Docker 解说视频
有人在 Reddit 上分享了一个用 Claude 制作动画解说视频的提示词。我拿一个自己很熟的话题试了试——Docker 容器。我把提示词粘进 Claude Code,填好语音和音乐模型的 API 密钥,然后离开了工位。
回来时,一部 57 秒的成片已经躺在那里。Claude Opus 5.5 自己写脚本、用代码画出每一帧、指导旁白、剪辑音乐、合成音效、完成混音、渲染视频,最后还交给另一个模型做了审校。整个过程跑了 38 分钟,API 调用花了 0.15 美元。
片子里没有任何图片文件。每一处纸张纹理、撕裂边缘、角色和道具,都是 JavaScript 在 HTML canvas 上现画的。
成片质量不错,但真正让我印象最深的不是它,而是那次会话日志。模型听不见声音,也看不了视频,却交付了一版干净的混音,还揪出了自己初稿里的两处事实错误——因为它找到了办法去逐步验证。这篇帖子主要讲的就是这件事。
一个听不见声音的模型,依然交出了干净的混音,因为它对每一处声音都做了测量,而不是凭感觉相信。
提示词
下面是我当时发出的提示词,去掉了 API 密钥。我自己写的只有话题那一句。
Create a pure javascript animation. 30s-60s stop motion paper craft style video
with appropriate audio on the topic what is docker containers and how they work

Entire video should be as high of a production value as possible. Please spend
your time on this, it's very important.

Use high quality text-to-speech model for generation. You can find open router
API key in .env file

You can use any tools you can find access to and resources on the internet. You
create the script, the assets, the animation, concept, everything.
I have to go away from my computer so please work autonomously until done.
Quality is paramount. Production value should be on professional level.

One more thing: max OpenRouter spend is $6.99
提示词写得很宽松,我觉得这正是它管用的原因。“纯 JavaScript 动画”定下了媒介,模型只需要一个浏览器,别的什么都不用:不用图像生成器,不用视频模型,也不用设计工具。“所有东西都由你来做”把创作决定权全部交了出去。“自主工作直到完成为止”意味着它不必等我,而它确实没等。它做了 75 次工具调用,一个问题都没问。花费上限的作用比我预想的更大,这个我稍后再讲。
成品长什么样
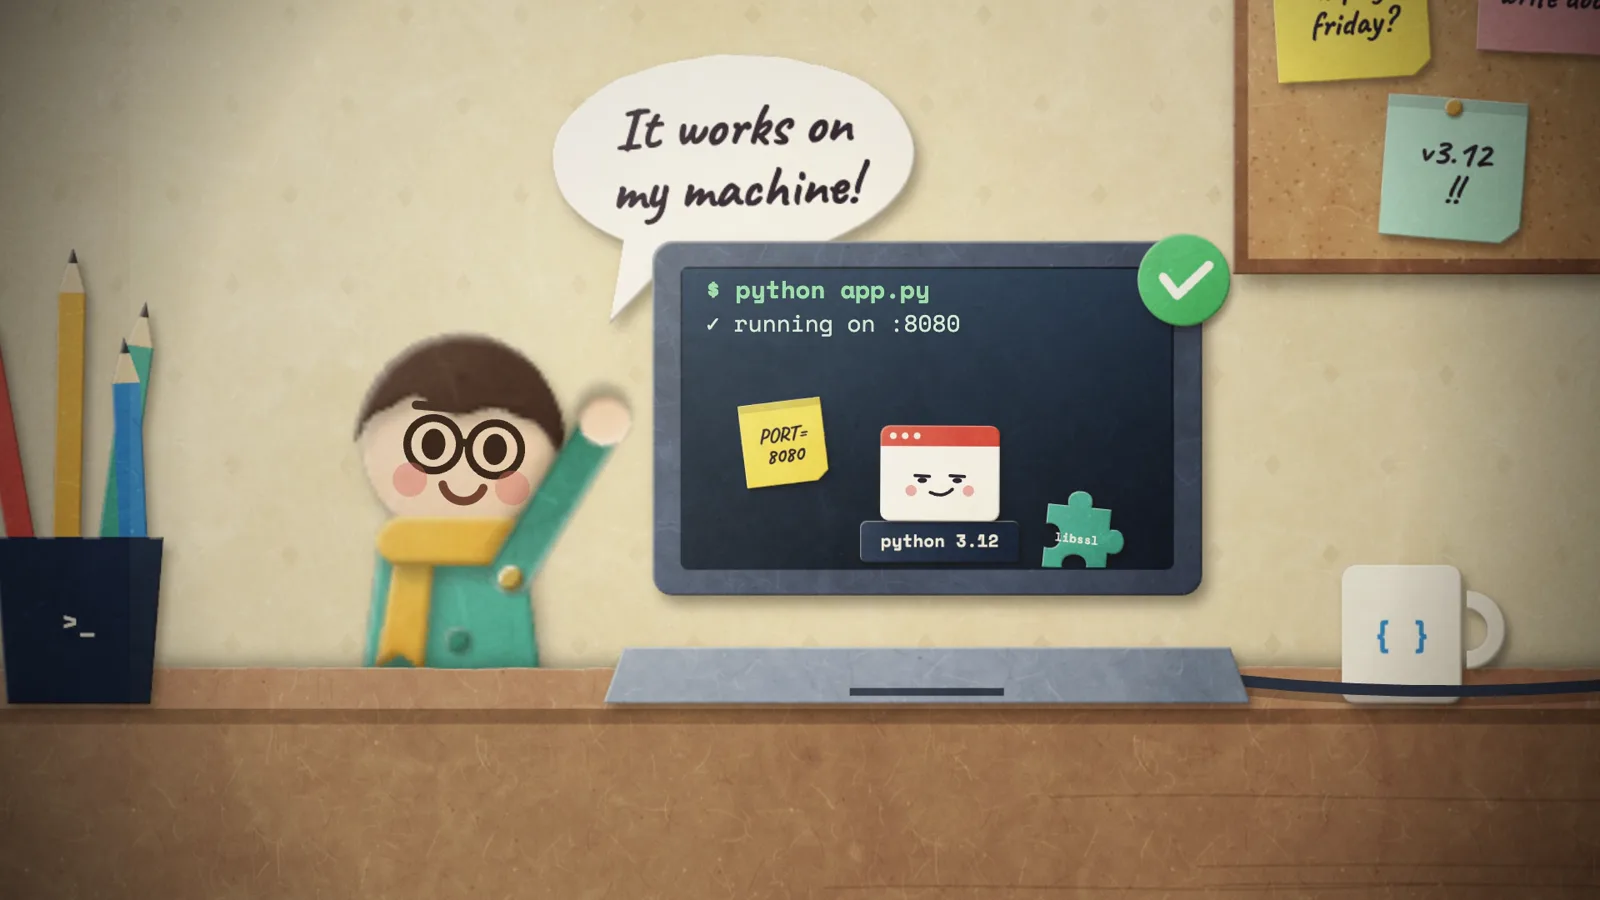
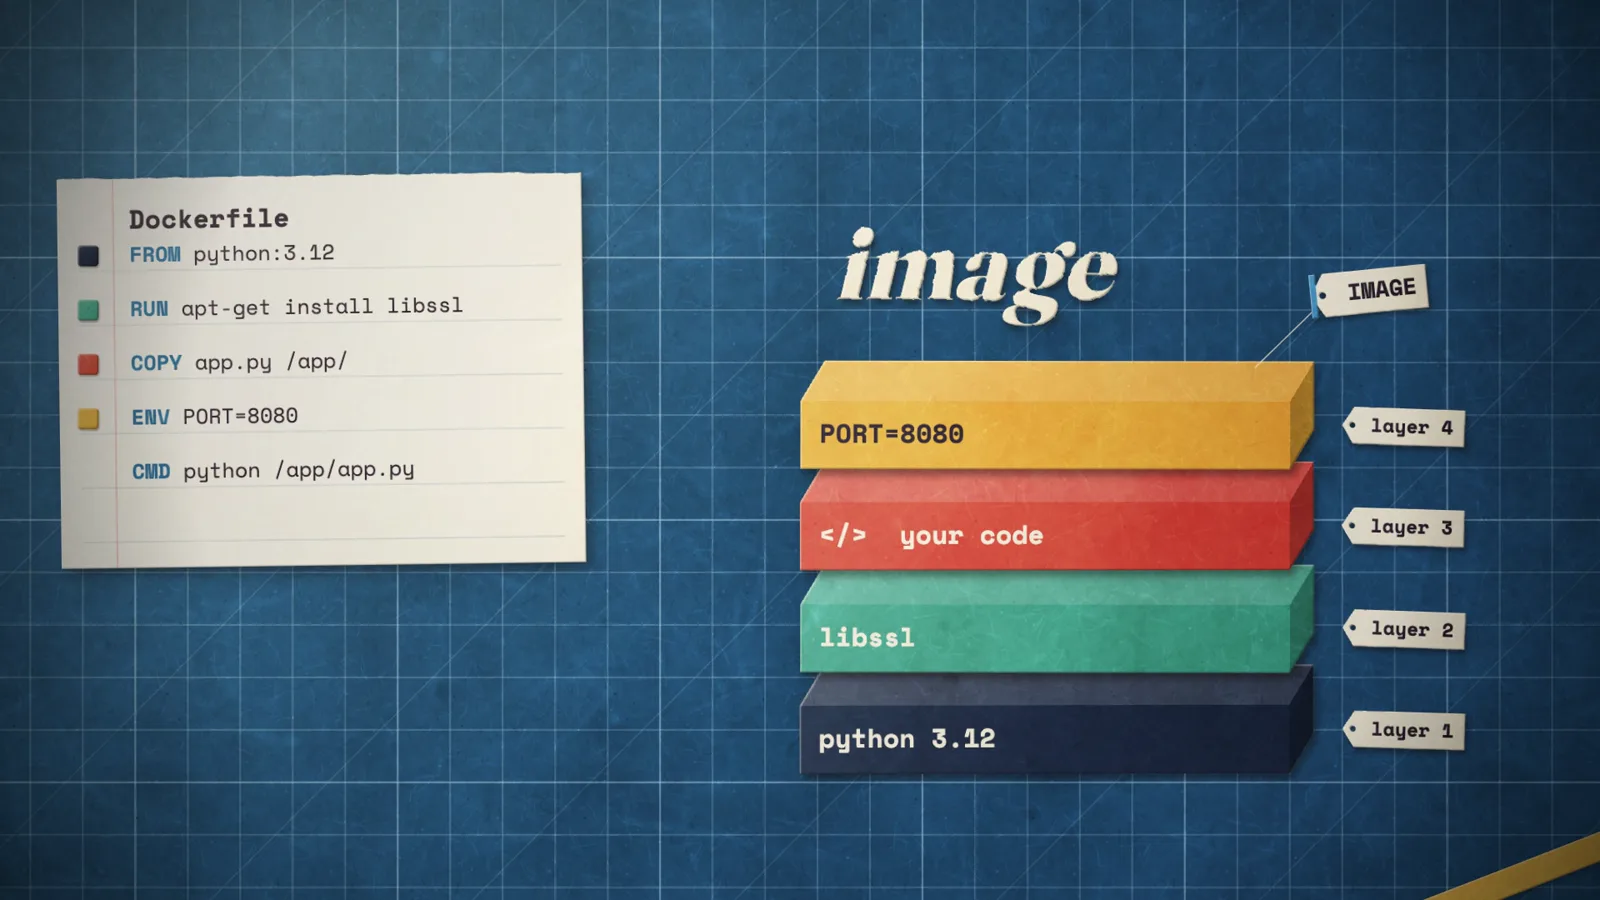
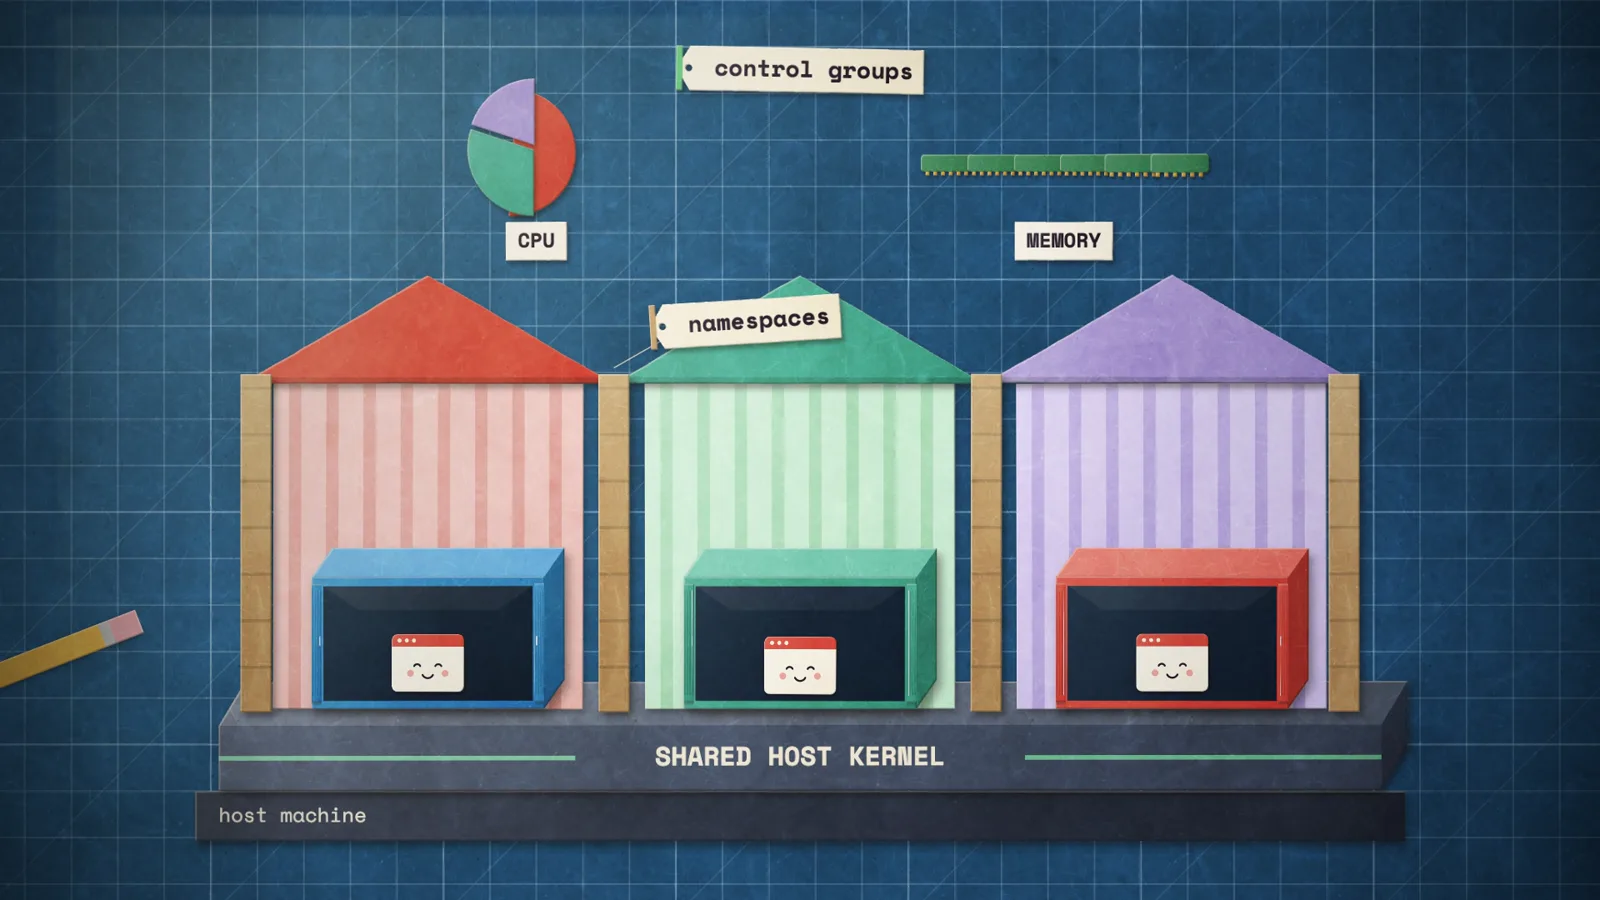
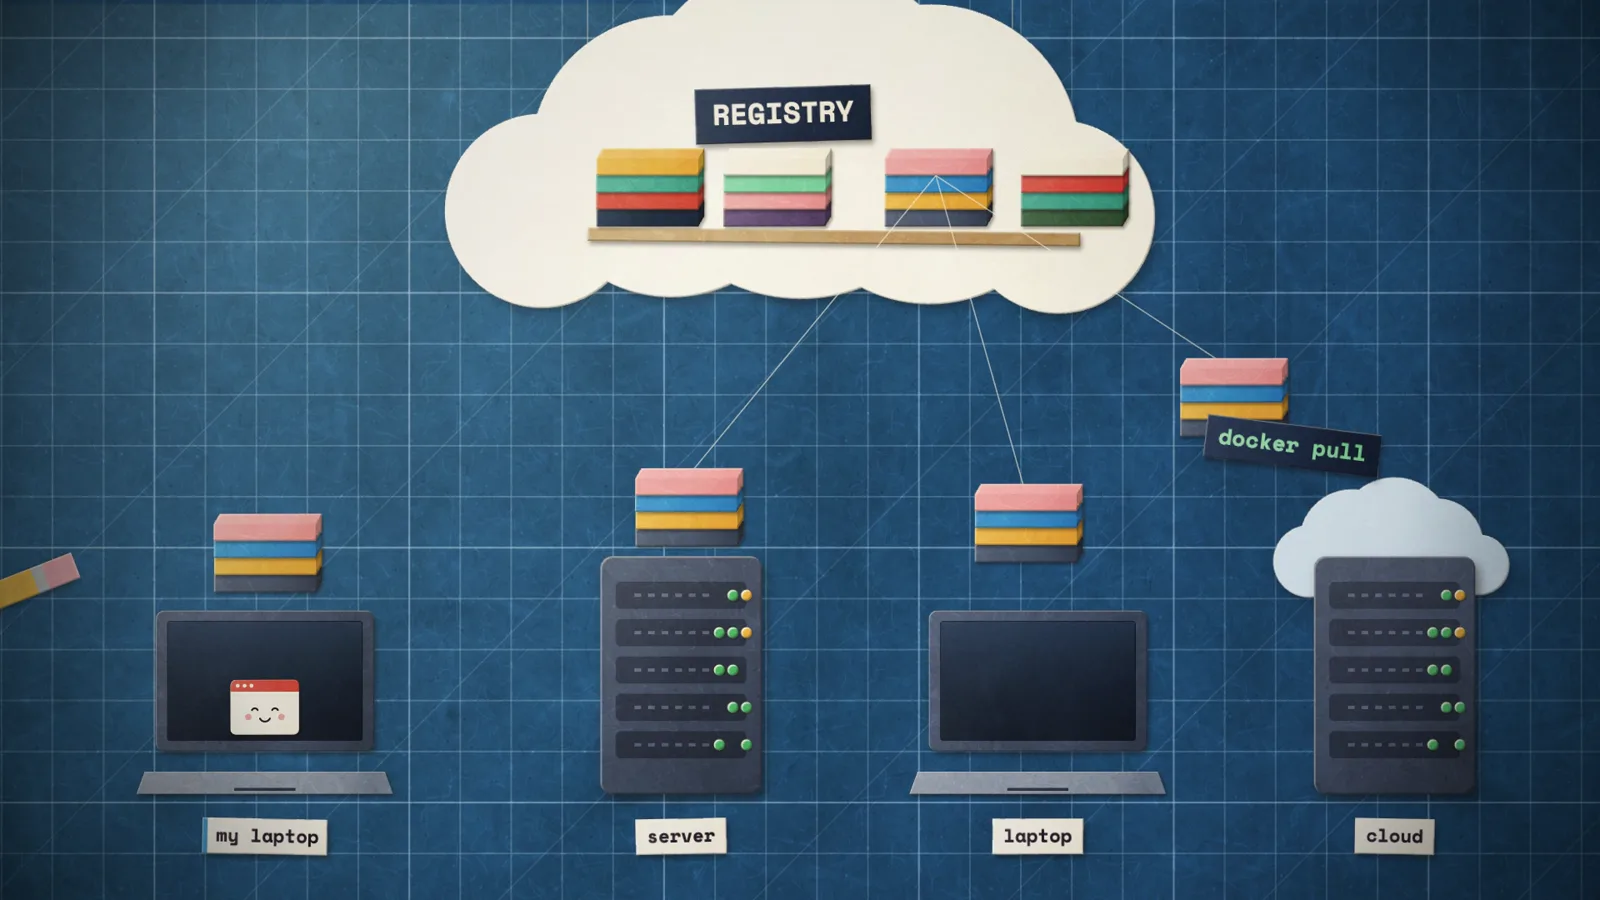
影片开场,一个纸片开发者坐在桌前。笔记本电脑上写着“在我机器上能跑!”应用跳到服务器那边,结果 Python 版本不对,缺了个库,还有个没人记下来的配置也没设,于是应用被撕成两半。Docker 的解决之道,是把应用和它需要的一切打包进一个货运集装箱。接着它依次讲了:用 Dockerfile 逐层构建镜像,docker run 冲压出一个个一模一样的容器,容器共享同一个宿主机内核,命名空间和控制组分别是墙壁和资源配额,还有一个所有机器都来拉取的镜像仓库。最后,一头纸鲸鱼驮着这些容器出现,标题落下。
事后我翻看会话日志,工作顺序让我意外。我以为它会先画起来,结果它做的第一件事是旁白。它写了 12 行脚本,录了一段试音,检查过,又录了两段,然后确定每一行在精确的哪一秒播放。之后才生成音乐,音乐剪完才开始做画面。画画花了 38 分钟里的 15 分钟左右,剩下的时间都用在声音、检查和渲染上。
纸片质感是怎么做出来的
整部影片就是一个 HTML 页面。一个函数 renderFrame(ctx, t) 负责绘制任意时刻 t 的完整画面:先找到该时刻所属的场景并画出来,再加上暗角、轻微的曝光闪烁和胶片颗粒。
纸片精灵
每个纸片都在启动时预先绘制到自己的离屏 canvas 上。paper() 函数负责给形状填上纯色,叠加纸张纹理,从左上方补一层柔光,最后切出斜边:把形状复制一份、偏移 1.6 像素,让一条边受光、另一条边落进阴影。正是这圈斜边,让平面图形看起来像是有厚度的卡纸。纹理颗粒同样是现场生成的——分层噪声上面再画 1500 根短“纤维”,所以不需要任何贴图文件。
剪刀从来剪不出直线,所以没有一个形状是干净利落的。wobble() 会沿着多边形的每条边行走,用噪声把点往里往外推——噪声是缓慢漂移的,不是随机跳变:
// hand-cut wobble along a closed polygon (scissors are never perfect)
P.wobble = function (pts, seed, amp = 1.2, step = 14) {
  const R = P.rng(seed), out = [];
  let d = 0;
  for (let i = 0; i < pts.length; i++) {
    const a = pts[i], b = pts[(i + 1) % pts.length];
    const len = Math.hypot(b[0] - a[0], b[1] - a[1]), n = Math.max(1, Math.ceil(len / step));
    const nx = -(b[1] - a[1]) / (len || 1), ny = (b[0] - a[0]) / (len || 1);
    for (let k = 0; k < n; k++) {
      d = d * 0.6 + (R() - 0.5) * amp;   // drift, not jitter
      const u = k / n;
      out.push([a[0] + (b[0] - a[0]) * u + nx * d, a[1] + (b[1] - a[1]) * u + ny * d]);
    }
  return out;
};
所有随机性都来自带种子的生成器,所以集装箱门的毛边在每一帧里都一模一样。
做出定格动画的质感
定格动画有两个破绽。画面是一顿一顿跳的,不是平滑移动的;而且每次拍摄之间,每个部件都会被挪动一点点,因为有人用手把它摆回去了。代码把这两点都模仿了出来。
时间被量化到每秒 12 张画面,每张画面在 24 fps 的视频里连续显示两次。动画师把这种拍法叫作“一拍二”(on twos)。
P.FPS = 12;
P.step = (t) => Math.floor(t * P.FPS + 1e-6) / P.FPS;  // quantize to the grid
P.frameOf = (t) => Math.floor(t * P.FPS + 1e-6);
然后每个部件都会得到一个微小的偏移量,每张画面变一次。偏移量来自画面编号和部件 ID 的哈希,所以看起来随机,但每次渲染结果都一样:
P.jit = (frame, id) => P.hash(frame, id) * 2 - 1;  // [-1, 1], new each drawing

P.drawJ = function (ctx, sp, x, y, r, s, f, id, amt = 1) {
  P.draw(ctx, sp,
    x + P.jit(f, id) * 0.9 * amt,          // under a pixel of drift
    y + P.jit(f, id + 0.5) * 0.9 * amt,
    (r || 0) + P.jit(f, id + 0.25) * 0.006 * amt,
    s || 1);
};
不到一个像素的位移,听起来好像没什么。但效果出乎我的意料。没有它,片子看起来就是矢量动画;有了它,看起来就像有人坐在桌前,一点点挪动纸片。
运动本身只是普通的关键帧加缓动。下面这两行写的是柜门甩开、再砰地关上,以及图层分离时带一点过冲:
const open = K(T, [[14.2, 0], [14.42, 1, 'out'], [15.4, 1], [15.62, 0, 'in']]);
const gap = K(T, [[20.36, 0], [20.66, 38, 'back'], [21.5, 38], [21.8, 0, 'inOut']]);
因为 T 已经对齐到 12 fps 的网格,哪怕这些曲线再平滑,出来的也是阶梯状的动作。开发者角色由几个纸片部件拼接而成,用“黄铜开口销”连接,摆姿势的方式就是绕着销子旋转每个部件,跟真正的纸偶一样。
声音出自一个听不见声音的模型
在会话早期,Opus 5.5 写道:“我无法收听音频。”然后它就围绕这个限制设计了每一步音频处理。
旁白由 OpenRouter 调用 Gemini 3.8 Flash TTS 生成。模型并没有直接把脚本丢过去,而是在前面写了一份配音导演简报,细到每一句该怎么念:
# AUDIO PROFILE: The Explainer
A warm, clever science-show host in their thirties. Bright, friendly, quietly
witty. A real human voice actor, not an announcer.
...
Beats: The first line, "It works on my machine.", is a smug, sing-song
impression of a proud developer. A comic drop on "and breaks." ...
A playful, knowing question on "So... does it work on your machine?"
它录了三条,每条都在我本机跑一遍 faster-whisper。转写结果给出的词级时间戳,精确标出每句话的起止点,它据此把最好的一条切成一行行字幕,填进 timeline.json:
{ "id": "breaks", "src": "ach_0", "in": 5.94, "out": 6.55, "at": 7.0,
  "text": "and breaks." }
之后每个场景都按这些时间点做动画。画面跟着声音走——人类剪辑师也是这么干的。
配乐是一段 60 秒的曲子,来自 Lyria 3 Pro。提示词里写明了结构:前七秒是段得意的即兴,代码崩掉时来一次垮塌,第 12 秒一个「啊哈」的转折,结尾收在按钮上。Lyria 并没卡准这些时间点。模型用两个工具补上了这一环:先把这段曲子导成小 MP3 发给 Gemini Flash,让它返回一份带时间的段落与剪辑点清单,花费不到一美分;再在本地用 librosa 找出节拍网格。两者结合,它把曲子切成七段重新排列,贴合影片节奏。每一次剪切都落在强拍上;「breaks」那句正对上一个磁带停转效果,最后一下重音落在片尾标题上。
48 个音效全部用 NumPy 和 SciPy 合成:纸张拍打、砰砰声、撕裂声、集装箱闷响、门轴吱呀、橡皮图章、打字、剪刀、海浪、海鸥,还有鲸鱼喷水。一张音效表把它们中的 248 处按动画时间点排好。下面这三行就对应前面门的几个关键帧:
ev(14.2, 'creak', -20, -0.2)       # the doors start to open
ev(15.4, 'creak', -24, -0.2)       # the doors start to close
ev(15.62, 'clank', -11, -0.2)      # the doors shut
混音脚本干的是一位混音师的常规活:对人声做均衡和压缩,语声出现时把音乐压低,在音乐中频段挖个坑好让人声清楚,铺一层环境底噪,最后加限制器。至于它没有耳朵是怎么验收的,后面再讲。
渲染
播放影片的那个页面同时也负责渲染。URL 里带上 ?render=1,它会跳过播放器,只暴露一个函数 window.renderAt(t)。一段简短的 Puppeteer 脚本用无头 Chrome 打开这个页面,把每一次绘制后的画布存下来:
for (let k = n0; k < n1; k++) {
  const url = await page.evaluate((t) => {
    window.renderAt(t);
    return document.getElementById('film').toDataURL('image/png');
  }, (k + 0.5) / 12);
  save(`f_${String(k).padStart(4, '0')}.png`, url);
}
这样大约一分钟就能生成 690 张图。ffmpeg 以 12 fps 读取这些图片,每张复制一份变成 24 fps,混入音轨,再编码成 H.264。因为整个流程不依赖真实时钟,某一帧渲染得慢也不会从视频里丢出去。
不用我盯着是怎么跑起来的
Claude Code 给了模型一个 shell、我的文件系统,以及查看图片的能力。就这些。真正让 38 分钟无人值守跑通的关键,是它怎么用这些能力。
按依赖顺序搭东西
一部片子里的几乎一切都依赖时间。你不知道某句台词什么时候说出口,就没法给对应的镜头做动画;而台词什么时候说出口,得先录好才知道。所以模型按这个顺序推进:脚本、旁白、锁定时间轴,然后按时间轴做音乐剪辑和各个镜头,再在动画之上加音效,最后混音、渲染。锁定时间轴时它还特意记了一笔:「画面和音乐提示都跟随这条时间轴。」这样后面就没有任何东西因为前面改了而需要返工。
花钱之前先算账
那个 6.99 美元的上限是针对整把密钥的,而我已经把大部分额度用在了别的工作上,只剩大约 0.20 美元。第一次旁白录完后,模型去问 OpenRouter 这次调用花了多少、密钥用了多少:
# simplifiedcurl -s "https://openrouter.ai/api/v1/generation?id=$GEN_ID" \ -H "Authorization: Bearer $OPENROUTER_API_KEY" # total_cost: 0.0140795curl -s https://openrouter.ai/api/v1/key \ -H "Authorization: Bearer $OPENROUTER_API_KEY" # usage: 6.817
然后它开始规划:一次录制 0.014 美元,那还剩得下一段音乐提示和大约四次录制。它最后用了两次。音乐做完、只剩 0.06 美元时,它停掉了所有付费调用,只留一次——花 0.018 美元复查草稿。它的理由是:它听不到自己混出来的声音。其余全部跑在我的笔记本上,不花钱。
这还不算 Claude Code 本身的使用费,那部分是单独计费的。
遇到我交代模糊的地方,它先自己拿主意,再告诉我一声
回头看我写的那句提示词,“OpenRouter 最多花 $6.99”本身就有歧义——我指的是这部片子,还是指这一整套密钥?当时已经花掉 $6.80,这两种理解对应的预算差得可不是一星半点。一个爱停下来问的模型,估计会一直干等着我回来。而这个模型选了更保守的那种理解,把活儿干完,然后在最后的报告里把假设写明白:它把 $6.99 当成整把密钥的总额度;如果我本意是按项目算,那还有余地再多试几条、多加几个配乐选项。
这就是我想要的「无人值守干活」的样子:选最稳妥的路、别停下、然后把你做的假设告诉我。
它一边干一边记笔记
每做完一步,它就写下那么一两句,说说发现了什么、下一步打算做什么,比如「第 1 到第 5 幕读着清楚。后面要修的:图层标签被右边缘裁掉了,相邻的容器门有重叠」。这样一来,它自己手里就攒着一份待办问题清单,我这边也拿到一份看得懂的日志。这篇文章里大部分内容就来自这些笔记。
最后它还写了份 README:脚本、带时间点的分场清单、每一部分怎么做的、花了多少钱、以及把成片重新搭出来的具体命令。它还提醒我,frames 文件夹有 2.3 GB,可以放心删;还有 API 密钥得换一把,因为我把它直接粘贴到对话里了。
它是怎么自检的
这一段我越想越觉得有意思。这个模型听不见,也只能看到静止的画面,所以它没法完整「看」自己做的片子。但它没放弃这些检查,而是给每一项都找了个替代方案:用转写文本来「听」台词,用节拍检测加文字描述来「听」音乐,用算术来听咔哒声,用响度计来检查平衡,用一张张静帧拼成联系表来「看」每一幕,再叫上另一个模型来看完整部片。
每个场景之后都生成静帧
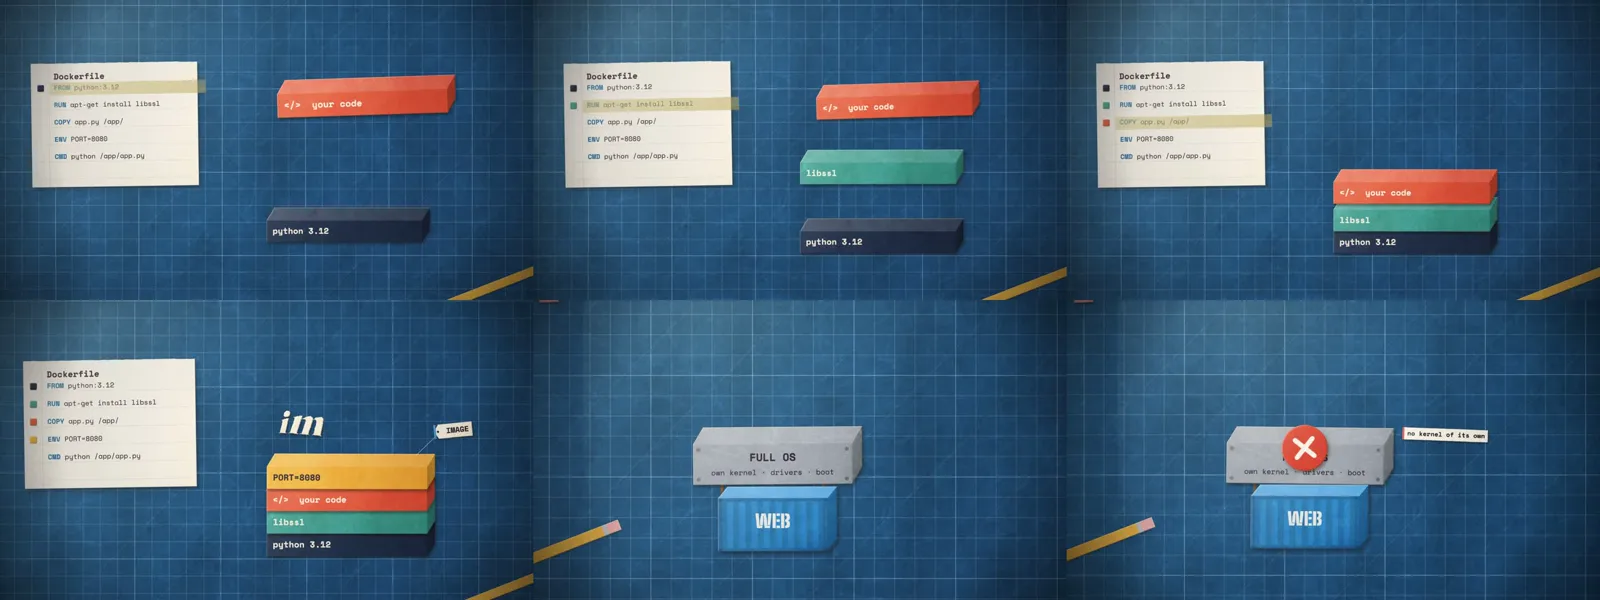
一个小脚本能按任意一组时间点渲染影片,再把各帧拼成一张图,存为 render/sheet.jpg。每写完一个场景文件,模型就渲染一张拼图看一眼。这样反复五轮,做出的修改正是我自己也会做的那些。办公桌前的开发者比例太小,于是把人物从 2.5 放大到 3.2。层标签超出右边界,就把层叠往左挪。容器门和相邻的门重叠了,就把开度改成 60%,而不是完全打开。镜像仓库那台笔记本电脑尺寸不对,于是画了个更小的,并加上“my laptop”标签。它还把手边的台灯换成笔筒,把结尾卡上的鲸鱼抬高,把喷水柱加粗。有个标签原本写的是“starts in ~1 s”,它改成“starts in seconds”,好和旁白对上。
逐字校对
每一条旁白录音在使用前都过了一遍 Whisper。第 0 条和脚本逐字吻合。第 1 条说的是“Every developer has set it”,所以弃用。
混音之后,它又把最终音轨转写了一遍,确认剪辑没有切掉任何字,结果 Whisper 又听成了“set”。这有可能是剪辑切掉了“said”的结尾,也可能只是 Whisper 听错了。接下来它的处理方式我很欣赏:把那一行按三个略微不同的边界分别切出来,再用词级置信度逐条转写。三次结果都是“said”,置信度为 1.0,说明剪辑没问题,是整轨转写出错了。
用算术听爆音
音频剪辑出问题会表现为爆音:相邻两个采样点之间突然跳变。在七个音乐剪辑点上,模型分别测出最大的跳变值,再和整条音轨 99.9 百分位的跳变做对比。最严重的一个是 0.0436,正常上限为 0.0498,所以没有哪个剪接点明显异常。它还测出最终混音为 -15.5 LUFS、峰值 -2 dB,这对在线视频来说是正常水平。
第二个模型,它核对了它的意见
整部片子是唯一没法靠测量判断的东西。它把第一版草稿压成 1.5 MB、640 像素的副本,发给 Gemini 3.8 Flash——这个模型能看视频、听声音。然后它以“资深动画导演兼混录师”的身份请求评审:按优先级列出真正的问题,并附上时间戳。
评审发现两个真正的技术错误。片中的 Dockerfile 先复制代码,再安装依赖库,顺序错了。因为这样每次改代码都会重装软件包,构建缓存也就失效了。片子还说容器“没有操作系统”,这是个常见误区。容器的基础镜像里确实带着操作系统用户空间,只是没有自己的内核。模型把两处都改了:Dockerfile 和图层动画现在先安装依赖库;那块板子上现在写着“完整操作系统:自带内核 · 驱动 · 启动”,并贴了一个标签“没有自己的内核”。它还采纳了三条音频意见:“breaks”下面有刺耳的嗡鸣;12 秒处音乐回来得太突然;句子之间音量自动闪避(ducking),忽高忽低。
但它对其中一条提出了异议。评审说 7.5 到 12 秒之间音乐几乎完全静音。模型测量了每个段落的音量,发现那一段和其他部分一样响,于是判定这条意见不准确。不过同一组数据也显示,整段配乐在旁白下面压得太低,所以它还是把音乐提高了 1.5 dB。
我觉得这是整个过程中最有用的习惯。它请第二个模型来做判断,但凡是自己能测量的东西,都不会只听第二个模型的一面之词。
测试它准备交给我的东西
最终编码完成后,它没有只看自己渲染出来的 PNG 帧就收工。它从成品 MP4 里抽出四帧,逐一检查——这一步验证的是编码环节本身。接着它用无头 Chrome 打开线上运行的 index.html,计时了 57 次画面绘制,核对音频长度,点击播放,确认时间确实在走。结果是没有页面报错,帧耗时中位数 0.1 毫秒,最差 6.2 毫秒(每秒画 12 帧的话,每帧有 83 毫秒的预算),音频 57.5 秒,点击后一瞬间播放器停在 1.4 秒。做完这些,它才写 README,然后告诉我搞定了。
自己动手做一部
你需要 Claude Code 搭配 Opus 5.5、Node.js、Google Chrome 和 Python 3。Node 这边只装两个包:puppeteer-core 和 ffmpeg-static。Python 这边用到 numpy、scipy、soundfile、pyloudnorm、librosa 和 faster-whisper。另外还需要一个 OpenRouter 密钥,并给语音、音乐和审阅模型设好消费上限。几美元就能做上好几部片子。
Reddit 上那份提示词直接拿来就能用。看完日志之后,我现在会用下面这个版本。它保留了开放式的要求,同时把这次跑通的关键习惯都写清楚了,省得指望模型自己去想:
用纯 JavaScript 做一段动画:一支 30 到 60 秒的纸艺定格动画讲解视频,
带旁白、配乐和音效,主题是:<你的主题>。

成片质量是第一优先级。概念、脚本、美术方向、动画和声音全部由你决定。
自主推进,直到片子做完。不要停下来问我问题。

限制条件:
- 所有内容都用代码画在 HTML canvas 上。不许用图片文件。
- OpenRouter 的 API key 在 .env 里。绝对不要打印它。付费总额上限 3 美元。
- 先把旁白时间轴定死,再开始做动画。动画要跟着人声走。
- 每一遍旁白都要用本地语音转文字检查过才能用。
- 每做完一个场景,把静帧拼成一张缩略图总览,然后检查。
- 让一个能看视频的模型审阅一遍草稿。每条意见都要先核实再动手改。
- 保留每一个早期版本。不是本次会话里你自己创建的文件,一律不要删。
- 最后写一份 README:片子讲了什么、怎么做的、花了多少钱,以及重新构建它的完整命令。

产出:一个 1920x1080、24 fps 的 MP4,外加一个可以实时播放这支片子的 index.html。
其中两行来自失误。我直接把 API 密钥粘进了提示词,于是它以明文形式留在了会话日志里,这样的密钥只能当作已泄露处理。把它放进.env并明确说明。另外,智能体独自干活时可能会顺手删掉旧渲染,所以要叮嘱它保留。你之后会比对这些草稿。
还有几点我想分享。从 30 秒的短片起步,短片检查起来更快,也能迅速告诉你这种风格是否适合你的主题。选一个包含具体物件的主题。Docker 里有箱子、层、服务器和一头鲸鱼,我猜抽象主题会难画得多。让模型把「纸片引擎」放进独立文件,这样下一部片子可以直接复用。就算预算充裕也要设消费上限,因为它逼着模型在调用前先算好价格。看 MP4 之前先打开index.html。这个实时页面可以用方向键拖动进度,是检查节奏最快的方式。
仍然需要人来做的事
配音是 AI 声音。它很不错,喜剧节奏也抓得住,但你听得出来。模型也判断不了一个笑话好不好笑。它的检查能发现错词、点击和音量问题,却看不出一个梗冷场了。
需求描述和模型同等重要。风格、时长、主题全都来自提示词,片子好不好,取决于这些选择做得怎么样。