推出 Infinity:一个面向极端智能体并发的运行时
智能体大部分时间都花在等待工具上。一个编程智能体可能启动一次持续二十分钟的构建,一个分诊智能体可能等上几个小时才等到代码仓库的下一个拉取请求,一个助手则可能一直等到第二天早上才拿到审批结果。大多数智能体运行框架把智能体循环当成一串阻塞步骤来执行:框架调用模型、调用工具、等待工具返回,然后重复。智能体在等待期间一直占着进程和内存,也无法响应这期间到达的事件。
今天,我们在 Apache 2.0 开源许可下发布 Infinity,它属于 Hydro 项目,这是 AWS 与加州大学伯克利分校合作推进的工作。Infinity 是一个研究项目,它重新构思了智能体运行时,思路来自编程语言里用于挂起和恢复异步函数的技术。当智能体调用工具时,Infinity 会把调用派发出去、保存对话,然后挂起智能体。等工具结果到达,运行时再从保存的状态恢复智能体。
有了 Infinity,并发智能体变得极其轻量。例如,在树莓派 5 的 8 GB 内存里,我们可以容纳 75,000 个并发智能体。Infinity 还让并发智能体可以部署在标准无服务器平台上。当 Infinity 在一次工具调用期间挂起智能体时,无服务器函数就可以结束。所以哪怕一次工具调用要花好几天,智能体等待期间也不需要任何东西在运行。
Infinity 是一个早期研究版本,我们分享它是为了尽早获得反馈。本文余下部分将介绍 Infinity 背后的理念及其架构。我们先概述编程语言如何用无栈协程(stackless coroutines)挂起异步函数,以及为什么智能体也能以同样的方式被挂起。我们会探讨 Infinity 如何利用这一点,在无服务器平台上也能并发运行大量智能体。接着我们会介绍合成工具调用(synthetic tool calls),Infinity 用它向现有模型投递异步事件,我们也用合成事件实现智能体之间的通信。最后,我们会讨论一些希望进一步探索的开放问题。
把 Agent 当作无栈协程
Rust、JavaScript、Python 等许多语言都支持用 async 和 await 写异步逻辑。函数在等待异步操作(比如网络请求)时会挂起,原本运行它的线程转去做别的事。操作完成后,运行时会让函数从中断处继续执行。要做到这一点,运行时必须保存函数的continuation(续体),也就是恢复执行所需的状态。
保存状态有两种方式。操作系统线程和有栈协程(stackful coroutine)会把任务完整的调用栈留在内存里等待。无栈协程(stackless coroutine)不同,Rust 实现 async fn 用的就是这种方式:编译器把每个函数改写成状态机,每个 await 处只保留必要的值。这样内存占用更小,执行器就能高效地跑大量无栈协程。
LLM Agent 也可以像无栈协程一样挂起。Agent 调用工具的那一刻,它的对话历史已经包含了结果返回后继续运行所需的全部信息。只要运行时把这部分历史持久化,就可以丢弃所有内存状态,之后任何能访问存储的进程都能把它恢复起来。
Infinity Runtime 正是利用这个思路来挂起和恢复长时间运行的 Agent。它把每个 Agent 拆成一系列有边界的切片(slice)来执行。在一个切片里,运行时从可插拔的存储中加载 Agent 历史,执行一次模型补全,持久化输出,最多派发一次工具调用,然后切片结束。工具调用相当于 await 点:切片从不因等待工具、定时器或其他外部操作而阻塞。
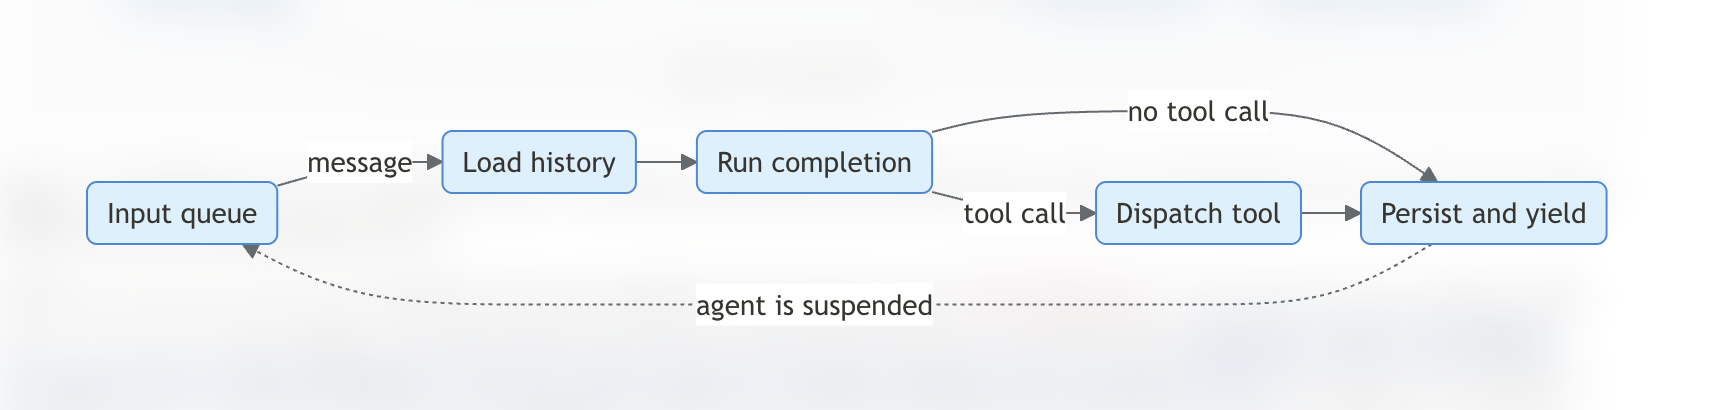
图 1:执行切片的生命周期。模型调用工具时切片结束;工具结果到达输入队列后,开启一个新的切片。
所有能让 agent 恢复运行的事件——包括用户输入的文字和工具返回的结果——都会以消息形式进入一个共享的输入队列。由于队列会暂存尚未处理的事件,运行时不必让 agent 一直保持存活来等待。Infinity Runtime 从队列取出消息后,会启动一个 slice,重新加载 agent 状态并处理这条消息。
并发运行 agent
挂起的 agent 不占内存,因此运行时可以同时管理大量 agent,并按消息到达的顺序调度它们。agent 运行在 agent system 中,这是一个由 agent 线程组成的池子,线程之间共享存储、工具和模型。运行时的组织方式类似 actor 系统:每个对话线程有自己的输入队列,线程之间不共享可变状态,只能通过向对方的队列发送消息来通信。每条消息携带一个 thread_id,标明目标线程。运行时保证同一线程的消息按顺序处理,一次只跑一个 slice;不同线程的 slice 则可以并行执行。
同一线程内必须保证顺序,否则两个 slice 同时读写同一段历史会互相覆盖各自的轮次。不同线程之间则无需协调。在长时间运行的进程里,agent system 给每个活跃线程分配一个 channel 和一个轻量任务,调度方式与 async executor 调度 future 相同。当线程没有排队消息、也没有待处理的工具结果时,它的任务就会退出;等下一条消息到达时,运行时再为它启动新任务。
挂起的 agent 只保留历史记录,因此让 agent 常驻所需的内存大致等于其历史记录的大小。为了测量这一点,我们写了一个基准测试:在一个 agent system 中分批启动 agent,后端使用模拟模型。每个 agent 运行二十轮,每轮都要完整走一遍运行时:模型流式输出约 1.2 KB 的补全内容并调用一个工具,工具结果通过输入队列返回,第二次补全结束这一轮。
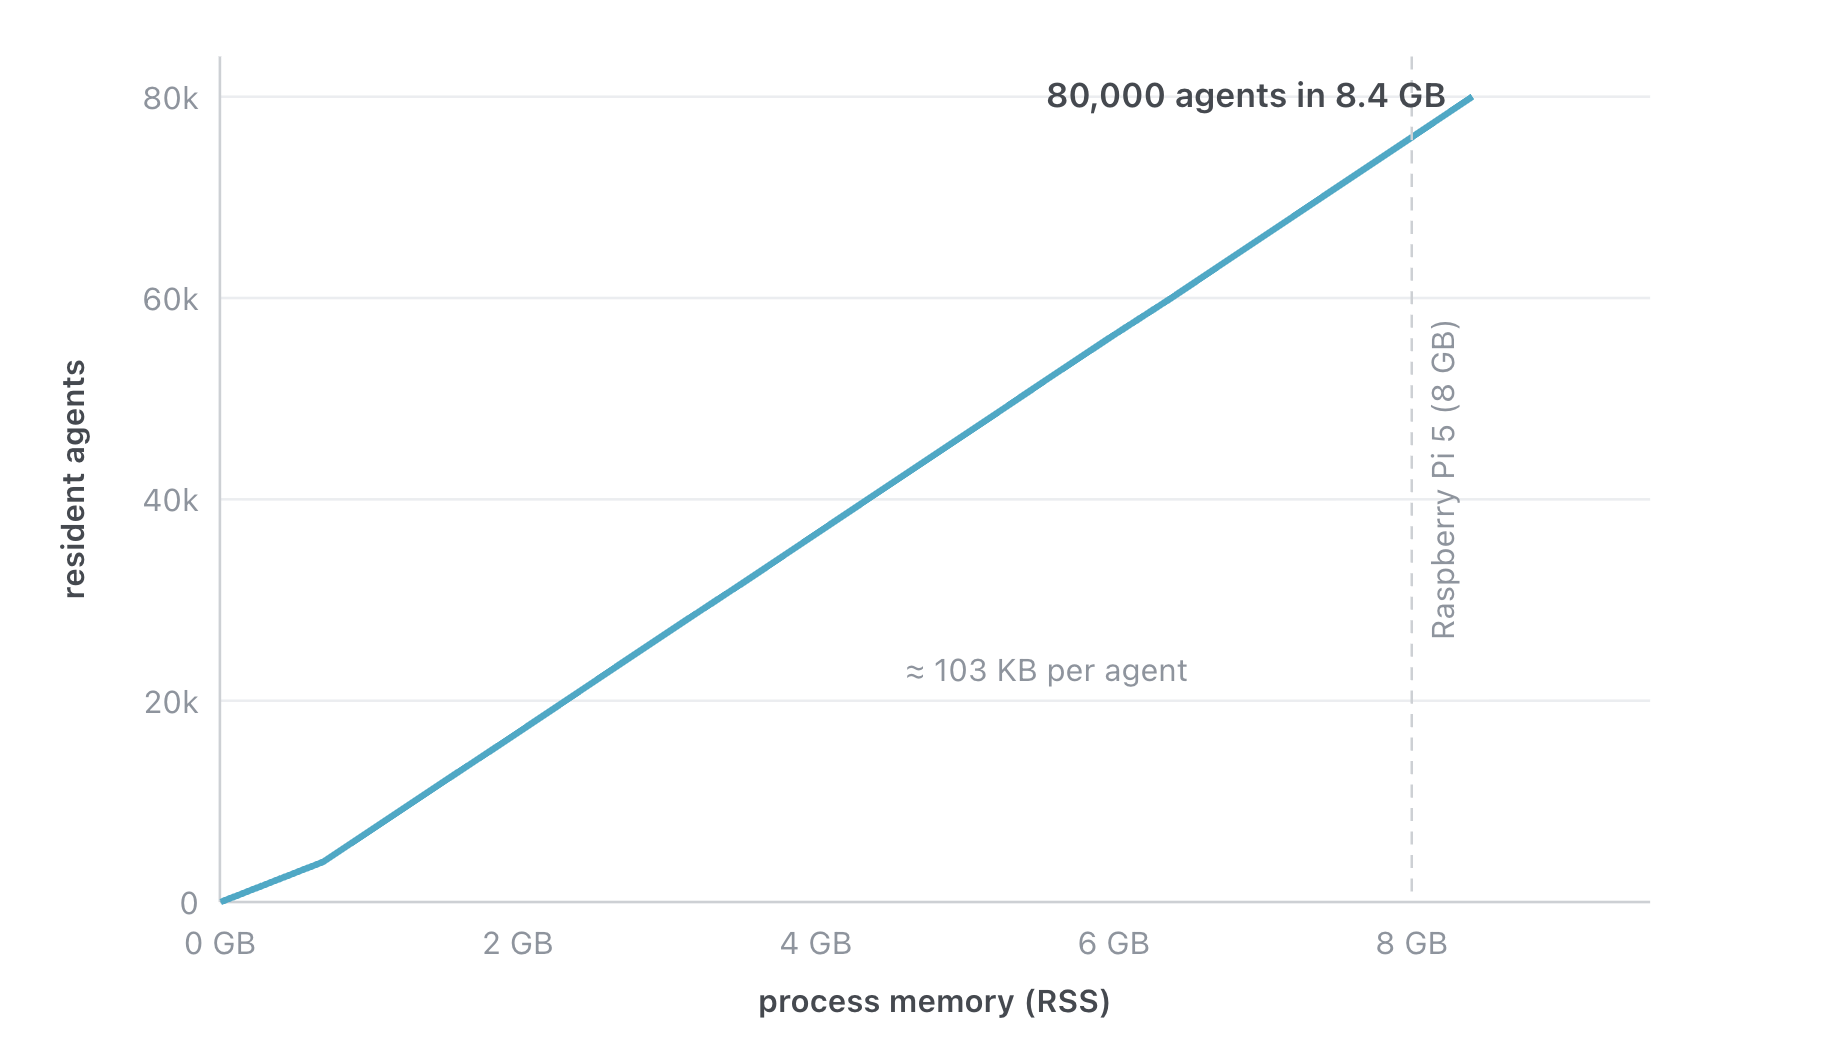
图 2:常驻智能体数量与进程 RSS 内存的关系,8 GB 处的参考线对应 Raspberry Pi 5 的内存容量。
我们在单颗 AMD EPYC 9R14 的单线程上,配合内存存储跑了 80,000 个智能体、共 320 万次完成,作为基准。常驻内存随智能体数量线性增长,每个空闲智能体约占 100 KB。按这个比例,8 GB 内存大约能装下 75,000 个智能体,这正好是一台 Raspberry Pi 5 的内存。这些内存大部分被对话历史占用,因为空闲智能体本身没有任务、调用栈或连接。
示例:不会阻塞的工具
下面看看开发者以本地(内存)模式嵌入运行时是什么体验。这个程序构建一个带有一个自定义工具的智能体系统,启动一个智能体,并打印智能体产生的事件:
let system = AgentSystemBuilder::new_local(
    InMemoryConversationStore::new(),
    InMemoryStateStore::new(),
    StaticModel::new(provider, "global.anthropic.claude-sonnet-4-6").await?,
)
.tool(Box::new(GetBuildStatus { builds }))
.start();

let mut thread = system.thread_builder().launch().await;
thread.send_user_text("Is build 42 green yet?").await?;

while let Some(event) = thread.recv().await {
    println!("{event:?}");
}
与大多数智能体框架的区别在于工具的写法。工具不是执行完再返回结果,而是由 execute 方法启动工作后立即返回。等工作完成时,工具再把结果发到智能体的输入队列:
#[async_trait]
impl Tool<ChannelSender> for GetBuildStatus {
    // name()、description() 和 parameters() 向模型描述这个工具。

async fn execute(
        &self,
        args: serde_json::Value,
        id: ToolCallId,
        call_id: Option<ProviderCallId>,
        context: &ToolContext<ChannelSender>,
    ) -> Result<(), Box<dyn std::error::Error + Send + Sync>> {
        let build_id = parse_build_id(&args)?;
        let (builds, sender, thread_id) =
            (self.builds.clone(), context.message_sender.clone(), context.thread_id.clone());

tokio::spawn(async move {
            let text = match builds.status(&build_id).await {
                Ok(status) => format!("Build {build_id}: {status}"),
                Err(error) => format!("Error reading build {build_id}: {error}"),
            };
            // 结果通过输入队列回到智能体。
            let message = tool_result_message(thread_id, &id, call_id, text);
            if let Err(error) = sender.send_to_input_queue(message, id.as_str()).await {
                tracing::error!(%error, "failed to deliver build status");
            }
        });

Ok(()) // 这个分片结束时无需等待构建完成。
    }
当模型调用 get_build_status 时,运行时会把包含这次调用的轮次持久化,调用 execute,然后结束当前时间片。如果状态查询只需一百毫秒,下一个时间片几乎立刻就开始;如果需要三天,那在这期间 agent 只占用它已存储的历史记录。无论哪种情况,工具和 agent 的代码都完全一样。
调用 send_to_input_queue 是工具与运行时交互的唯一入口。InputSender 是一个 trait(特征),所以队列既可以是示例中这种长驻进程里的内存通道,也可以是云端持久化消息队列——下面我们就来讲这个。
在无服务器平台上运行
由于时间片不会等待外部操作,而且所有状态都从存储加载,运行时可以跑在无服务器平台上:每份工作触发一次函数调用,干完活就可以退出。这个库通过步进模式(step mode)支持这种用法。步进模式的 agent 系统不保留任何运行中的任务,平台每投递一批消息就调用一次 step,两次调用之间内存里什么都不留:
let mut system = AgentSystemBuilder::new(conversation_store, state_store, model, sqs_sender)
    .tools(tool_impls)
    .build();

// 每次队列投递调用一次;函数返回后进程即可退出。
let collector = EventCollector::new();
let outcomes = system.step(inputs, &collector, &mut NoDeferral).await?;
两种模式跑的是同一套流水线,本地模式只是额外加了每线程的驱动层,负责批处理、中断和自动压缩。所以针对核心库写的工具、模型提供方和测试,不用改任何代码就能在两种模式下运行。两者最主要的区别在 InputSender——运行时用它来处理所有“稍后再说”的事情,比如定时器唤醒或发给另一个线程的消息。在步进模式下,sender 写入持久化队列,消息会在之后的某次投递中回来。
在 AWS 上的参考部署里,我们用一个 SQS FIFO 队列作为输入队列,每个线程对应一个 MessageGroupId。每次消息投递都会触发一个 AWS Lambda 函数,该函数执行一步(slice)后就退出。会话历史存放在 Aurora DSQL 中,去重状态存放在 DynamoDB 中,而 sleep 工具则借助 SQS 的投递延迟和 EventBridge Scheduler 来实现定时器。仓库里包含了用于创建这些资源的 CDK 构造(constructs)。
在这样的平台上运行,对运行时提出了几项要求:
-
执行时间有界。 一个 slice 只包含一次模型补全,外加少量存储和分发调用,不会等待任何时长无上限的操作。
-
无需进程亲和性。 所有状态都按线程 ID 存储,因此任意一次函数调用都能处理任意线程的下一条消息。
-
至少一次投递。 队列可能重复投递消息,所以每条输入都带一个稳定的 ID,状态存储会记录每个线程已经处理过哪些 ID。运行时会识别并跳过重复投递的消息,从而让 slice 的处理具备幂等性。
-
轮次持久化。 模型输出的流式数据先写入缓冲区,等整个轮次结束后才提交。如果流在中途失败,运行时会丢弃缓冲区,重新执行这次补全。当一次工具调用结束某个轮次时,运行时会先把这个轮次落盘,再分发调用,这样调用会在结果到达之前就被记录下来。
-
无锁串行化。 FIFO 消息组在队列层面把同一线程的各个 slice 串行化,而 Lambda 不会同时用两次调用处理同一个消息组,所以运行时无需分布式锁。
传统的运行时会在工具调用处阻塞,这类运行时同样可以跑在无服务器平台上,但每次调用在工具执行期间都必须保持打开状态。而在 Infinity 里,处于等待中的 agent 没有任何正在运行的调用,所以一个在等待为期三天的 CI 流水线结果的 agent,在流水线返回结果之前不消耗任何计算资源。
合成工具调用
等待工具返回的智能体,还需要一种方式,来获知等待期间发生的事件。一条长时间运行的命令可能会持续产出输出,而订阅某个代码仓库后,每当有人新建拉取请求(PR),就应该产生一个事件。这两种情况下,一次工具调用产生的不再是单个结果,而是一串结果,运行时必须把这些结果逐个呈现给模型,并且要用模型能推理的形式。
模型 API 无法表示异步事件。一段对话由用户轮次、助手轮次,以及成对的工具调用与工具结果组成,而且每次工具调用只能对应一个结果。为了让事件塞进这个结构,我们考虑过几种办法。给原来的工具调用追加第二个结果,违反了一对一的规则,模型通常会直接拒绝这样的对话。把事件作为用户消息加进去,API 能接受,但这等于把事件算在用户头上,模型就再也分不清哪句话是用户说的、哪条是工具报告的。把事件放在对话之外,比如塞进系统提示,又会让它脱离历史中的事件顺序——而模型正是靠这个顺序来判断事情先后发生的。
Infinity Runtime 的办法是合成工具调用(synthetic tool calls)。有事件到达时,运行时插入一次助手工具调用(模型实际上并没有发起过这次调用),紧接着跟一条包含该事件的工具结果:
▶ Synthetic:  receive_event__injected({
                 original_tool_name: "subscribe_github_events",
                 original_tool_call_id: "call_abc123",
                 original_args: { owner: "acme", repo: "api" }
               })
■ Result:     {"event_type": "pull_request", "action": "opened", "number": 42}
运行时以工具调用的形式投递事件,这样就保留了模型在后训练阶段获得的能力,能够理解工具结果并决定如何应对。参数会标明是之前哪次工具调用产生了这个事件,模型因此知道事件属于自己哪个请求。调用时用的是专用名称 receive_event__injected,而不是重复原始工具名,这样模型就能区分事件与工具的新调用。后缀 __injected 表示这个调用是运行时创建的。运行时绝不会把这个名称作为工具提供给模型;如果模型试图调用它,运行时会拒绝。
工具产生事件的方式与产生第一个结果相同,都是向 agent 的输入队列发送消息。工具把第一个结果标记为订阅的开始,告诉运行时同一个调用之后可能还有更多结果,并把后续每条消息标记为该调用的事件。两次事件之间 agent 可以进入空闲状态,事件到达时会唤醒它。与任何其他消息一样,事件可以在本地进程中唤醒 agent,也可以触发一次新的 Lambda 调用,所以订阅在等待下一个事件时不会让任何东西保持运行。
父 agent 与子 agent 之间的通信
同一套异步工具调用与事件模型也支持 agent 之间的通信。每个 agent 都有一个内置的 spawn_thread 工具,用来创建一个带独立输入队列的子线程。从父 agent 的视角看,spawn_thread 的行为就像一次订阅。子线程一创建好,调用就返回,父 agent 继续做自己的事,子线程的报告随后作为该调用的事件到达:
[Parent thread]

⚙ Tool call:  spawn_thread({ instructions: "Review src/auth.ts for security issues" })
■ Result:     "Child thread is successfully spawned and has ID: thread_a1b2. ..."

... the parent continues with other work, or goes idle ...

▶ Synthetic:  receive_event__injected({
                 original_tool_name: "spawn_thread",
                 original_tool_call_id: "call_spawn_a1b2",
                 original_args: { instructions: "Review src/auth.ts for security issues" }
               })
■ Result:     "Report from child thread: Critical: SQL injection in
                auth.ts line 42."
子线程调用 report_to_parent 时,运行时会把一条消息送入父线程的输入队列,并标记为最初那次 spawn_thread 调用的事件;父线程看到的就是一次指向该 spawn 的合成工具调用。子线程在工作过程中可以多次上报,最终报告则在它调用 close_thread 时以同样方式送达。由于报告绑定了对应的 spawn,父线程能分辨出是哪个子线程发来的,即使同时有许多子线程在跑也不会混淆。
这样一来,运行时无需为 agent 单独搭建一套消息系统。创建子线程、向父线程报告,都是普通的工具调用,其结果和事件通过输入队列传递。前面讲过的顺序保证对它们同样成立,父线程和子线程作为同一 agent 系统里的独立线程并发运行。
选择事件的处理位置
除了决定事件如何表示,运行时还要决定由哪个线程来处理它。如果某个订阅一次性向单个 agent 投递上百个事件,这些事件会占掉该 agent 上下文窗口的很大一部分。子线程给了运行时规避这一问题的办法,工具会为每个发出的事件在两种策略中选择一种。
默认情况下,运行时为每个事件单独开一个子线程处理,不把事件写进订阅线程的历史。它会临时创建一个子线程,继承父线程的上下文,把合成事件交给它,由它自行决定怎么处理。子线程可以处理事件并向父线程报告;如果事件无关紧要,也可以不报告直接关闭,此时父线程的历史保持不变。若多个事件几乎同时到达,每个事件各有一个子线程,这些子线程并发处理各自的事件。
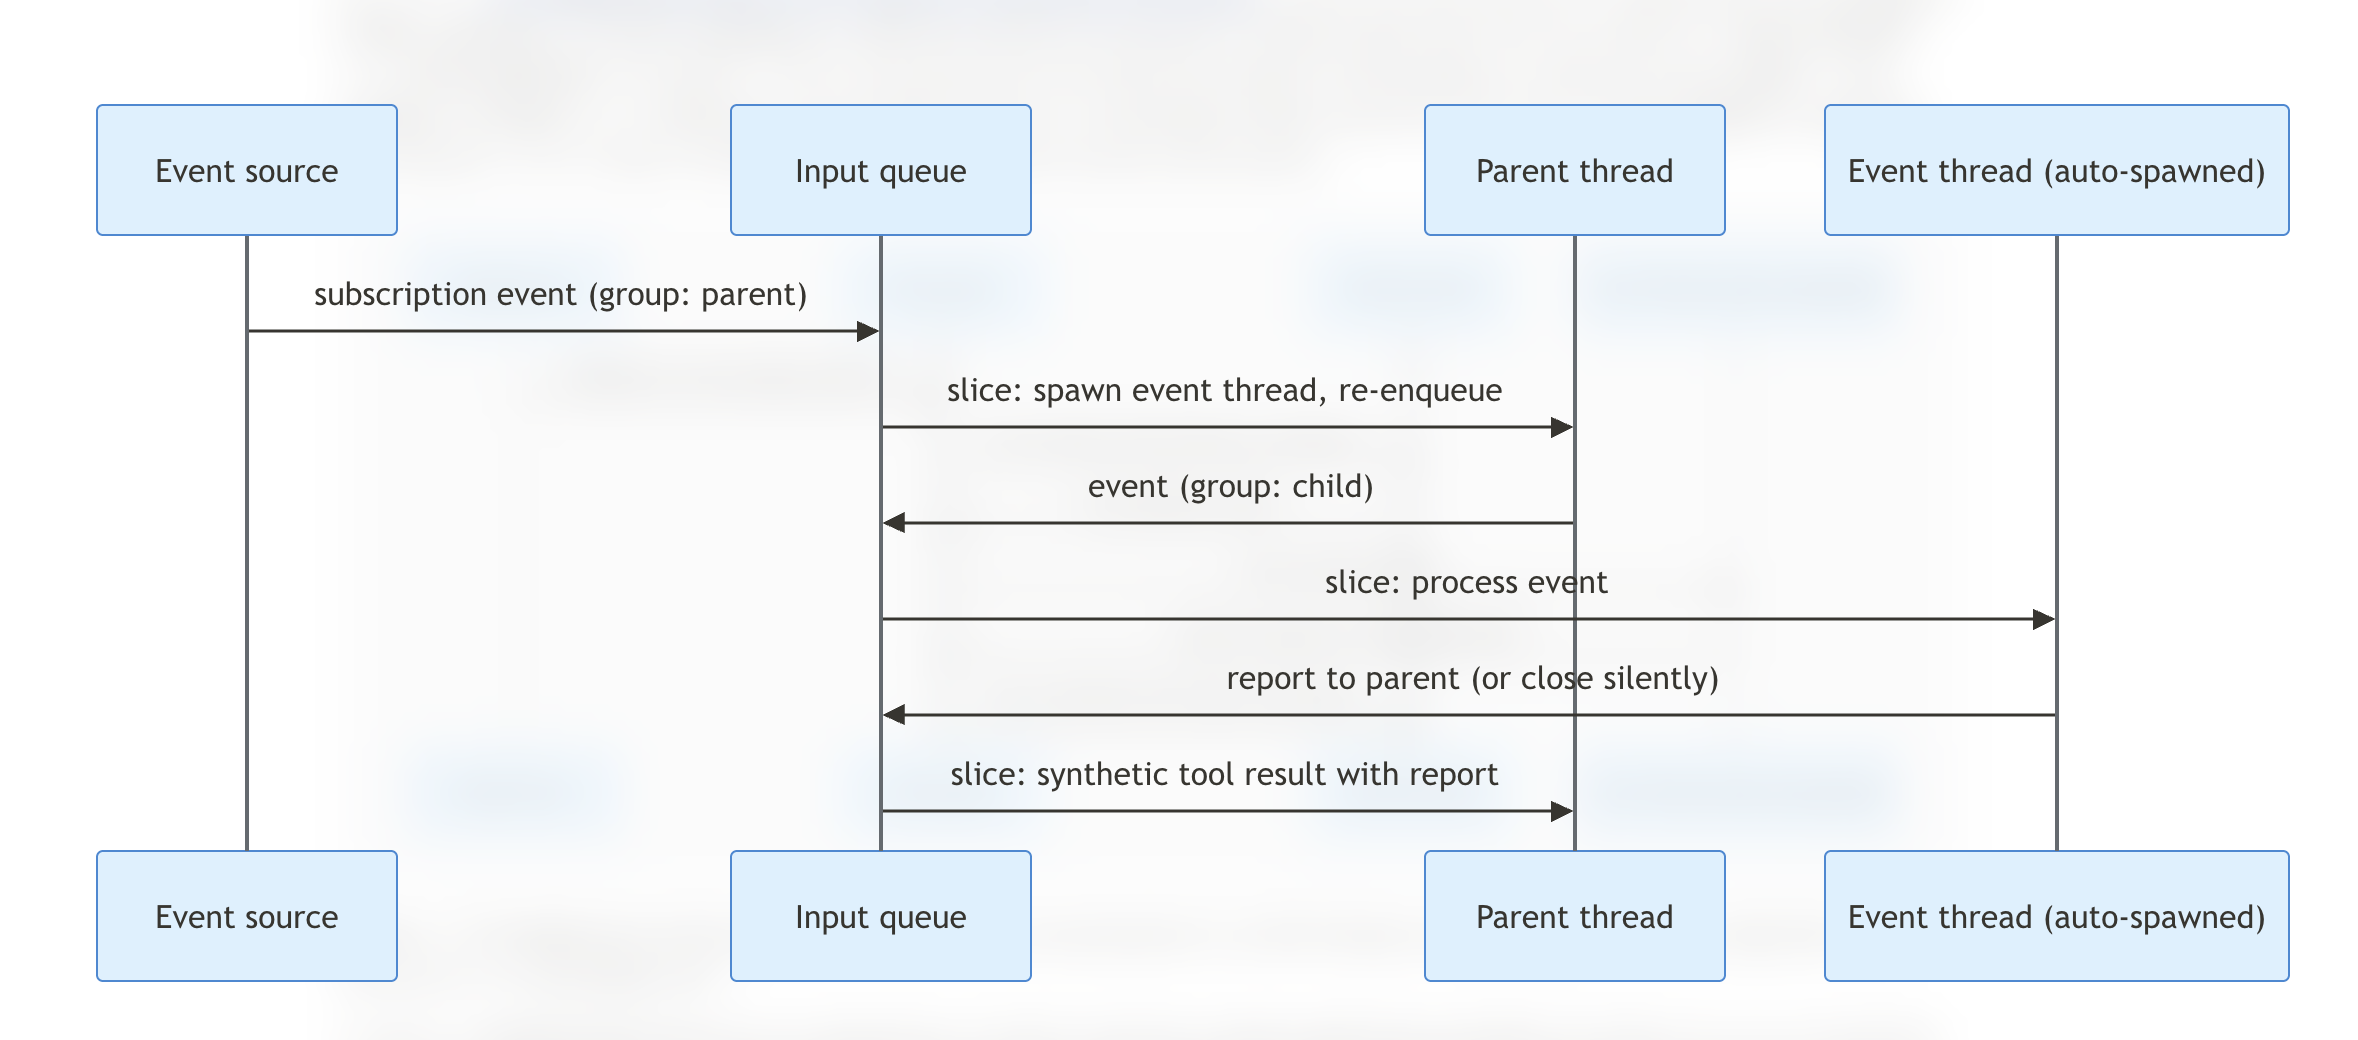
图 3:线程化的事件处理。原始事件在子线程中处理,父线程只收到子线程的报告(如果子线程发了报告)。
工具也可以把事件标记为“关联型”(associative)。这样,运行时会直接把合成调用写进订阅线程的历史记录。这种机制适合用来更新 Agent 正在跟踪的某个操作,比如 Agent 在后台启动的测试跑完后产生的输出。
待解问题
还有几个问题没有答案,我们打算继续研究:
-
交错事件的推理。 合成工具调用能让对话保持结构完整,但模型训练时接触的轨迹大多是工具调用同步发生的场景。事件的数量和顺序、以及在线程处理和关联处理之间怎么选,会怎样影响 Agent 的决策,我们想搞清楚。
-
调度策略。 运行时目前按消息到达的先后顺序处理线程。Agent 系统本身有优先级,调度器可以把这些因素考虑进去,比如让面向用户的线程优先于后台事件处理器。
-
Agent 树中的压缩。 运行时按历史记录中的位置给压缩摘要建索引,所以压缩前创建的子 Agent 仍然能重建它继承的历史。对于长期运行的大型对话树,压缩该怎么处理,我们还没研究。
-
事件真实性。 运行时把每个事件锚定到发起它的请求上,但暴露在互联网上的 Agent 可能收到伪造的数据。运行时应该如何确认事件的来源,让操作可追溯、可问责,同时又不破坏无状态架构?
结论
现在,人们越来越希望智能体能长时间运行、对事件做出反应,还能把任务拆分给子智能体(subagent)处理。Infinity 针对这类智能体提出了一套基于无栈协程(stackless coroutine)的执行模型:运行时把每次工具调用都当成一个挂起点,把对话历史保存为智能体的续延(continuation,即恢复执行所需的状态),等到消息到达时再恢复这个智能体。按这个模型,空闲智能体的内存开销大致只相当于它的历史记录,大量智能体可以共用少量线程,同一份智能体代码既能在本地进程里运行,也能跑在无服务器(serverless)平台上。通过合成工具调用(synthetic tool call),运行时可以在模型 API 本身已支持的结构内,把异步事件呈现给模型;父子智能体之间的消息传递也复用了同一套机制。
Infinity 现已在 GitHub 上发布。按照快速入门指南,几分钟内就能搭好一个运行在 Infinity 上的简单智能体。这是早期研究版本,我们欢迎大家对设计思路和具体实现提出反馈。