在真实环境中定位 CI 失败
写软件有时确实不容易,但它从来不是你一天里最卡脖子的环节。你跑完自己的测试、确认功能正常、提交改动、耐心等着同事对代码发表意见,然后——CI 挂了。
可查下来发现,这根本不是你的 bug,而是一个跟你改动毫无关系的失败。你只好放下补丁,去翻之前的 CI 运行记录,复现这个失败,再判断问题到底出在数据库、测试还是环境上。重跑一下任务,往往就通过了。但根本问题还在原地,下一位贡献者又会撞上它。
总得有人干这些活。而从 2026 年 3 月起,在 ClickHouse 代码库里,干这些活的经常不是人。
我们构建了 GroeneAI 来接手这类排查工作。它是一个完全自主的 AI 工程代理,每周 7 天、每天 24 小时连轴转。它会复现失败、编写并测试修复,还会盯着自己的 PR 走完 CI 和评审流程。Groene 在荷兰语里是“绿色”的意思,这个名字记下了最初的目标:让 CI 保持绿色。
它在 3 月 25 日提交了第一个 ClickHouse issue,72 分钟后又提交了第一个 pull request,从此就没停过。这个代理执行整个开发流程,全程不需要人类参与。它自己挑活、查原因、设计并实现修复、构建 ClickHouse、跑测试、开 PR。这些步骤没有人来执行,大多数时候也没有人来指定。GroeneAI 的大部分工作是从 CI 结果、fuzzer 发现和用户报告里自己找来的。维护者也可以只留一条评论,就把 bug 交给它。除此之外,人的介入从评审开始:维护者决定是接受这个改动,还是按自己的意思把 GroeneAI 引到别的方向。
后续工作同样是自主完成的。GroeneAI 会盯 CI、回复评审意见、修改实现,并随着代码库的变动做 rebase。一个任务可以跨越多个 session 保持活跃,调查过程和后续步骤全程保留。
GroeneAI 在排查故障的过程中,逐渐摸清了代码库各部分是如何拼在一起的。它把根因、失败的尝试和评审反馈存入持久记忆,在后续任务中复用这些经验。这个循环让它把触角伸向 SQL 引擎、存储、查询规划以及周边测试基础设施中的正确性和性能问题。它的活动范围并没有在 CI 上停留太久。
到 2026 年 10 月,GroeneAI 已向 ClickHouse 贡献了 3000 多个合并的拉取请求。截至 10 月 19 日的三个月里,按作者的非合并提交数排名,它在 ClickHouse 贡献者中位列第二,仅次于 ClickHouse 联合创始人兼 CTO Alexey Milovidov。
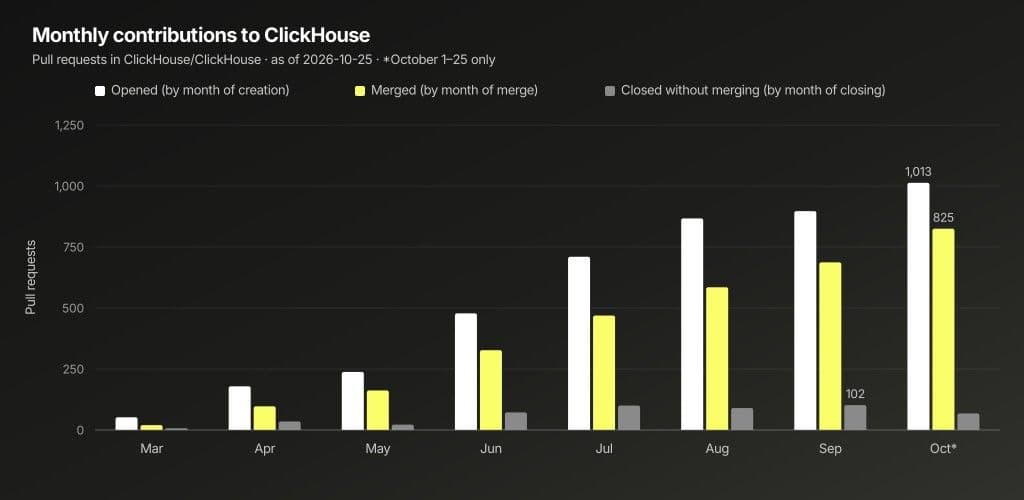
ClickHouse/ClickHouse 的每月活动。开启、合并和关闭均按事件发生的月份统计。10 月仅包含 10 月 1 日到 25 日。
这个智能体运行在我们的开源智能体运行时 Nerve 上。Nerve 提供持久会话、记忆、工具和定时执行能力。GroeneAI 在此之上增加了一套为 ClickHouse 量身打造的开发展工作流。这套工作流如何演变成今天的样子,用一个 bug 来讲最清楚。
我们为这个小机器人产出的每一处改动感到自豪,同时也想特别点出它真正大放异彩的几个月:
6 月:一个记错东西的缓存
6 月 3 日,GroeneAI 正在盯自己 DDL 改动的 CI,这时一个不相关的测试 03047_on_fly_update_delete 在 S3 存储上的分布式查询计划下失败了。这个失败看起来像是偶发问题,重跑一次可能就过了。但 GroeneAI 选择去复现它,而正是在复现过程中,bug 才暴露出来。
查询条件缓存会记住数据块(data part)中哪些范围没有匹配过滤条件的行,这样后续相同条件的查询就可以跳过这些范围。只有过滤器看到的是真实数据,这条缓存记录才可信。如果另一个操作先删除或修改了行,那么空结果更多反映的是那个操作,而不是实际存储的内容。
调查把看似不稳定的问题定位到了随机索引粒度上。粒度较大时,只要有一行匹配的行存活下来,某个范围就仍然会被读取,从而把 bug 藏了起来。而每个 granule 只有一行时,错误的跳过决策每次都能复现。缺失的防护检查由来已久,可以追溯到去年 3 月合并的原始查询条件缓存实现:它在 PREWHERE 之前应用 mutation,却记录了由此得到的空范围,而没有检查这些 mutation 是否改变了行。
回归测试把这一点具体化。它创建 100 行,id 和 v 都从 0 到 99。测试停止后台合并,并提交一个异步更新,把 id >= 50 的行的 v 设为 0。原始 part 仍然可用,所以查询可以选择在读取时是否应用待处理的 mutation。启用并清空缓存后,测试执行两次读取:
1SELECT count() FROM t_qcc_on_fly_update
2PREWHERE v >= 50 SETTINGS apply_mutations_on_fly=1;
3
4SELECT count() FROM t_qcc_on_fly_update
5PREWHERE v >= 50 SETTINGS apply_mutations_on_fly=0;
第一条查询应返回 0,因为更新改变了每个匹配的值。第二条应返回 50,因为它读取的是原始值。修复之前,第一条查询写入的缓存条目会让第二条查询跳过匹配的行。
| 读取 | 修复前 | 预期及修复后 |
|---|---|---|
| 应用待处理的更新 | 0 | 0 |
| 读取原始值 | 0 | 50 |
这是 PR 单副本回归测试中 UPDATE 场景记录的结果,设置 index_granularity = 1、mutations_sync = 0。
读取端原本已经做了防护:有 mutation(数据变更)正在执行时,它会避开缓存结果。缺的是写入端的保护。PR #107145 给两条写缓存的路径都加上了检查,在 PREWHERE 之前确认有没有 mutation 步骤或 patch part。只要这类转换存在,读处理器就会阻止 PREWHERE 更新缓存,同时扣下那份元数据——否则下游的 WHERE 过滤就能凭它写入一条缓存记录。行级安全也加了同样的检查,并配了一个双用户回归测试:一个用户能访问 v < 50,另一个的策略恒为真。不带这些转换的查询,优化照旧保留。
这个 PR 的讨论串,能看出 GroeneAI 在 6 月的工作方式——那时下一节要讲的流水线还不存在。它在 6 月 11 日开 PR #107145,附了一张表,列出自己验证过的内容。当天就来了四条评审意见:WHERE 这条路径仍然没加保护;行策略需要同样的保护;patch part 的情况没有测试;那个测试结果不确定。GroeneAI 逐条修完,每修一次就在讨论串里重贴一遍那张表,12 小时里贴了五次。八天后,alesapin 提问:这个改动是不是在 lightweight mutation 下把 PREWHERE 关掉了?GroeneAI 在 31 分钟内回复:只抑制了缓存写入;如果他更希望,也可以把缓存键改成基于 mutation 状态。又过了 33 分钟,他批准了。
改动在 6 月 19 日合入。测试覆盖更新、删除、patch part、行策略,以及显式留在 WHERE 里的谓词。每种情况都遵循同一条规则:只有当过滤条件评估的数据正是缓存条目所代表的数据时,它才能记下"这个范围没有匹配行"。
干得好,机器人。
7 月:一次排查变成一套流程
缓存修复从测试失败到合入,花了十六天。中间有构建、一次通宵的 CI 运行,还有评审者几天后才回来。一个跨会话就忘事的 agent 根本做不了这活;一个记错事的 agent 会把它做砸。7 月,也就是 6 月那次修复之后,我们上线了现在这套工作流仍在使用的流水线,并随着新故障暴露出的遗漏,持续调整它的检查项。
入库流程从事件开始:存储 GitHub 通知,并记录每个使用者收件箱的处理进度。GroeneAI 的收件箱处理器随后把可执行的消息关联到对应任务。另有一个定时扫描,专门检查 CI 失败,包括那些从未出现在账号参与的通知里的失败。
生成的任务是持久化的:Nerve 会保存任务的 Markdown 内容,并在 SQLite 中建立索引。GroeneAI 还会写一个检查点,记录当前阶段、分支、提交、构建标识、已完成的测试、证据位置和下一步动作。之后新的会话能依据这个状态接着干,不必让之前的对话一直活着。
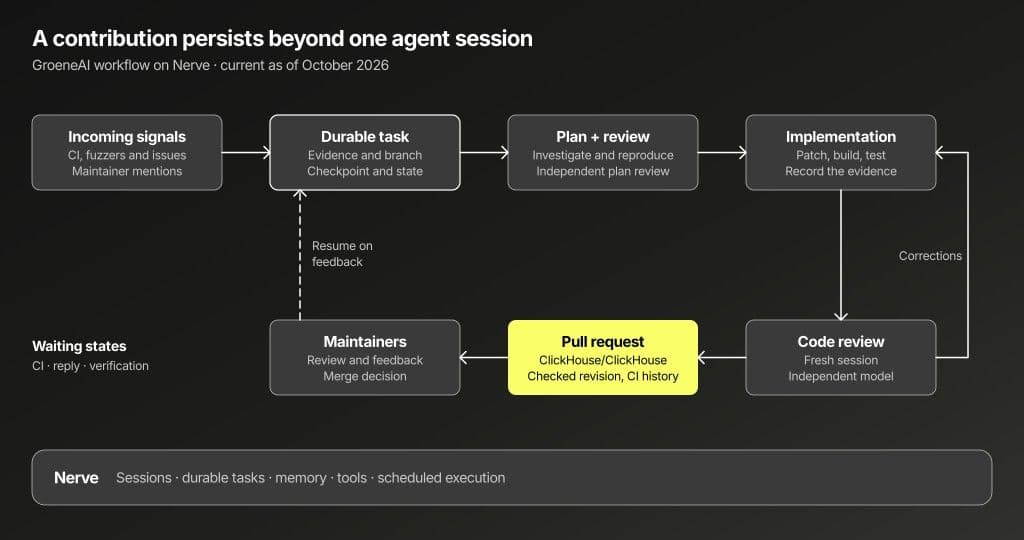
Nerve 保留任务并安排执行。GroeneAI 的工作流控制各阶段交接。修正会退回实现阶段,而 CI 和维护者的反馈可以在发布后让工作继续。
缓存修复这个例子说明了状态为什么重要:恢复运行的工作单元需要知道哪条读取路径已经加了保护、哪个测试覆盖了 WHERE、以及补丁测试是否在等自己的更新。检查点会指向相关产物,从而区分“改动已完成”和“测试条件尚未解决”这两种情况。
记忆让信息能跨任务传递。简短的操作规则进入会话上下文;较长的调查内容放在文件里,需要时再加载;语义回忆则负责检索此前的发现和流程。技能则提供可复用的操作说明,比如怎样构建 ClickHouse,或怎样排查一次 CI 失败。
存储的信息也会过时,工作流正是按这个前提设计的。GroeneAI 的构建指令要求检查当前的 CI 编译器配置和 CMake 缓存,即使记忆中已有编译器版本也不例外。记忆中的经验会引导 worker 去查证据,而这些证据必须在当前代码检出中核实。TheNerve 任务文档、source-ingestion 文档和 memory 文档描述了这些运行时基础能力。
在这个运行时之上,工作流把一次新贡献拆成三个阶段,各司其职。
规划 worker 先调查报告,检查源码和已有修复,然后写出一套方案,包含复现步骤。由另一个模型审查方案。如果报告是重复问题、无法复现,或需要维护者拍板,流程就停在这里。
接下来由实现 worker 在任务的代码检出中完成修改。它的指令要求提供证据:没有补丁时回归测试失败,加上补丁后测试通过。如果方案的假设不成立,worker 记录它实际执行了什么,然后把任务退回规划阶段。
新的审查会话先检查代码,再读实现者写的验证说明。它必须检查改动的函数、调用这些函数的地方以及相关实现,然后把测试与拟提交的 PR 描述做对比。GroeneAI 的主 worker 会话用 Claude,对方案和最终改动的独立审查用 Codex。审查者会自己构建一套对补丁的解释,再与实现证据比对。被采纳的实质性发现会变成实现阶段的修正项。有争议的发现则需要代码或测试证据来解释分歧。
工作流还会检查审查的是哪个修订版本。普通的推送前路径要求针对拟提交的 commit、tree 或完整补丁标识完成一次第二模型审查并记录在案。审查发现仍需裁决,而且对早期版本的审查不能悄悄为后续代码改动放行。
八月:流程在运转
八月的两处改动,说明这套流程已经在实际运转,并开始真正自主地发挥作用。第一处是查询规划器的优化:GroeneAI 必须先证明它安全,维护者才肯合并;第二处修复了一份 CI 报告,工程师在评判别人的改动时会读这份报告。
看看这个机器人是怎么做的:
第一处:让 UNION DISTINCT 用上并行
在 PR #115173 中,GroeneAI 注意到两种等价的查询写法生成了不同的执行流水线,而较慢的那种恰恰是人们常写的写法。改动本身很小。这个 PR 真正记录下来的,是 GroeneAI 如何为自己的方案辩护。合并之前,它测试了相反的情况:对重复密度和线程数做了一轮扫描,发现某个 16 线程的输入变慢了 22%,最大惩罚出现在 max_threads = 1 时;于是它加了一道保护,让这种情况沿用旧的单线程计划。它自己的第二模型评审接着否决了第一版回归测试,原因是:如果只关掉前置步骤、却保留该步骤的计划标签,一个只检查「存在与否」的断言仍然会通过。现在的测试会精确断言存在两个前置计划步骤和三个 DistinctTransform;只要在任一规划器里定向翻转这个开关,测试就会失败。
这两种写法是:UNION DISTINCT,它把所有行送入同一个最终去重步骤;以及包在 UNION ALL 外面的 SELECT DISTINCT,它先在每个分支内并行去重。补丁的做法是:当有效线程数大于 1 时,为 UNION DISTINCT 增加一个前置去重步骤,把它下推到各分支,同时保留最终步骤,因为不同分支可能持有相同的值。两个规划器实现都做了更新。INTERSECT 和 EXCEPT 则沿用原有的计划。
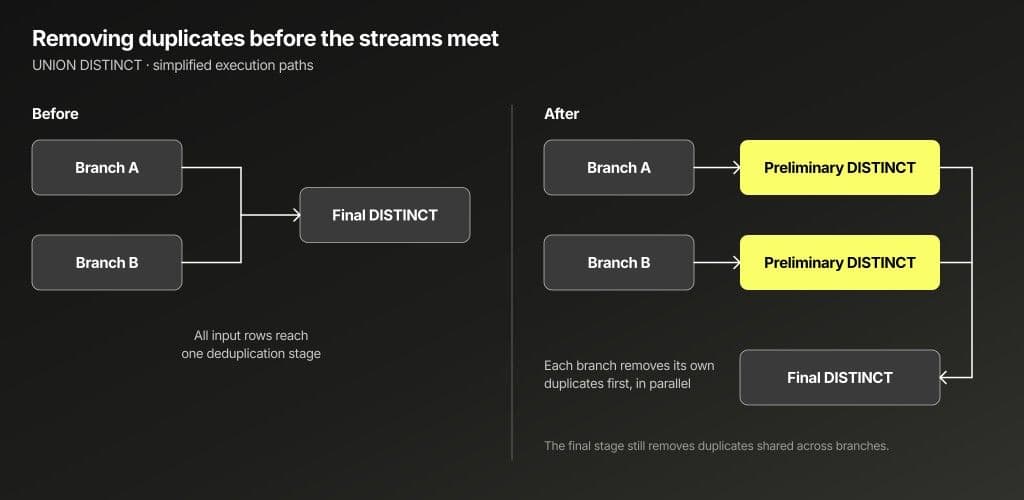
分支内去重减少了进入最终去重阶段的行数。最终阶段仍会去掉不同分支之间共有的重复值。
这个 PR 汇报了在 release 构建上做的实验:两个分支各 800 万行,2,000 个不同值,取七次运行中最快的一次:
max_threads |
优化前 | 优化后 |
|---|---|---|
| 1 | 60 ms | 61 ms |
| 8 | 44 ms | 13 ms |
| 16 | 59 ms | 9 ms |
上表正是这次改动针对的场景:重复值密集。之所以在 max_threads = 1 处加了一道保护,就是因为做了这轮扫描;也正因如此,表格并没有声称任何输入都能加速。该改动于 8 月 27 日合并,同时附带一个回归测试,覆盖查询结果和执行计划结构。
第二个改动:让 CI 失败更容易解读
第二个改动针对的是 GroeneAI 所依赖的一个工具。PR #114451 处理的是一个性能对比报告的问题:摘要显示通过,明细里却有 22 行标红。GroeneAI 没有改动判定结论本身,而是用两份真实的报告产物搭起回归测试——一个通过的分片,里面有 11 条不稳定的查询;一个失败的分片,必须保持红色——并断言它的修复只改变了展示方式。
原来的报告给每一行明细都硬编码了失败状态,而且每次对比会把基线侧和候选侧都显示出来。result-builder 的改动把真实的查询判定带进报告,每次对比只显示一次,优先显示候选侧,同时保留 CI 数据库里已存储的行及其历史链接。回归测试断言:通过的分片会产出 11 行不稳定记录,失败的分片则保持失败状态。该改动于 8 月 17 日合并。
九月:一处注入漏洞,牵出一连串改进
九月的重心转向了安全。当月合并的五个 PR 修掉了一个 SQL 注入问题,而且每一个都带出了下一个。最早的是 PR #108469,从 6 月 25 日就一直开着。GroeneAI 发现,PostgreSQL 通信协议会把预编译语句的参数当作原始字符串直接拼进 SQL 文本,于是像 x' UNION ALL SELECT ... -- 这样的值就能逃出字面量范围,变成真正的 SQL。9 月 2 日,我们的一位维护者往 GroeneAI 的分支上推了两个自己的提交:给 COPY 标识符加引号,以及修复 CancelRequest。第二天一早,他请 GroeneAI 审一下这两个提交:
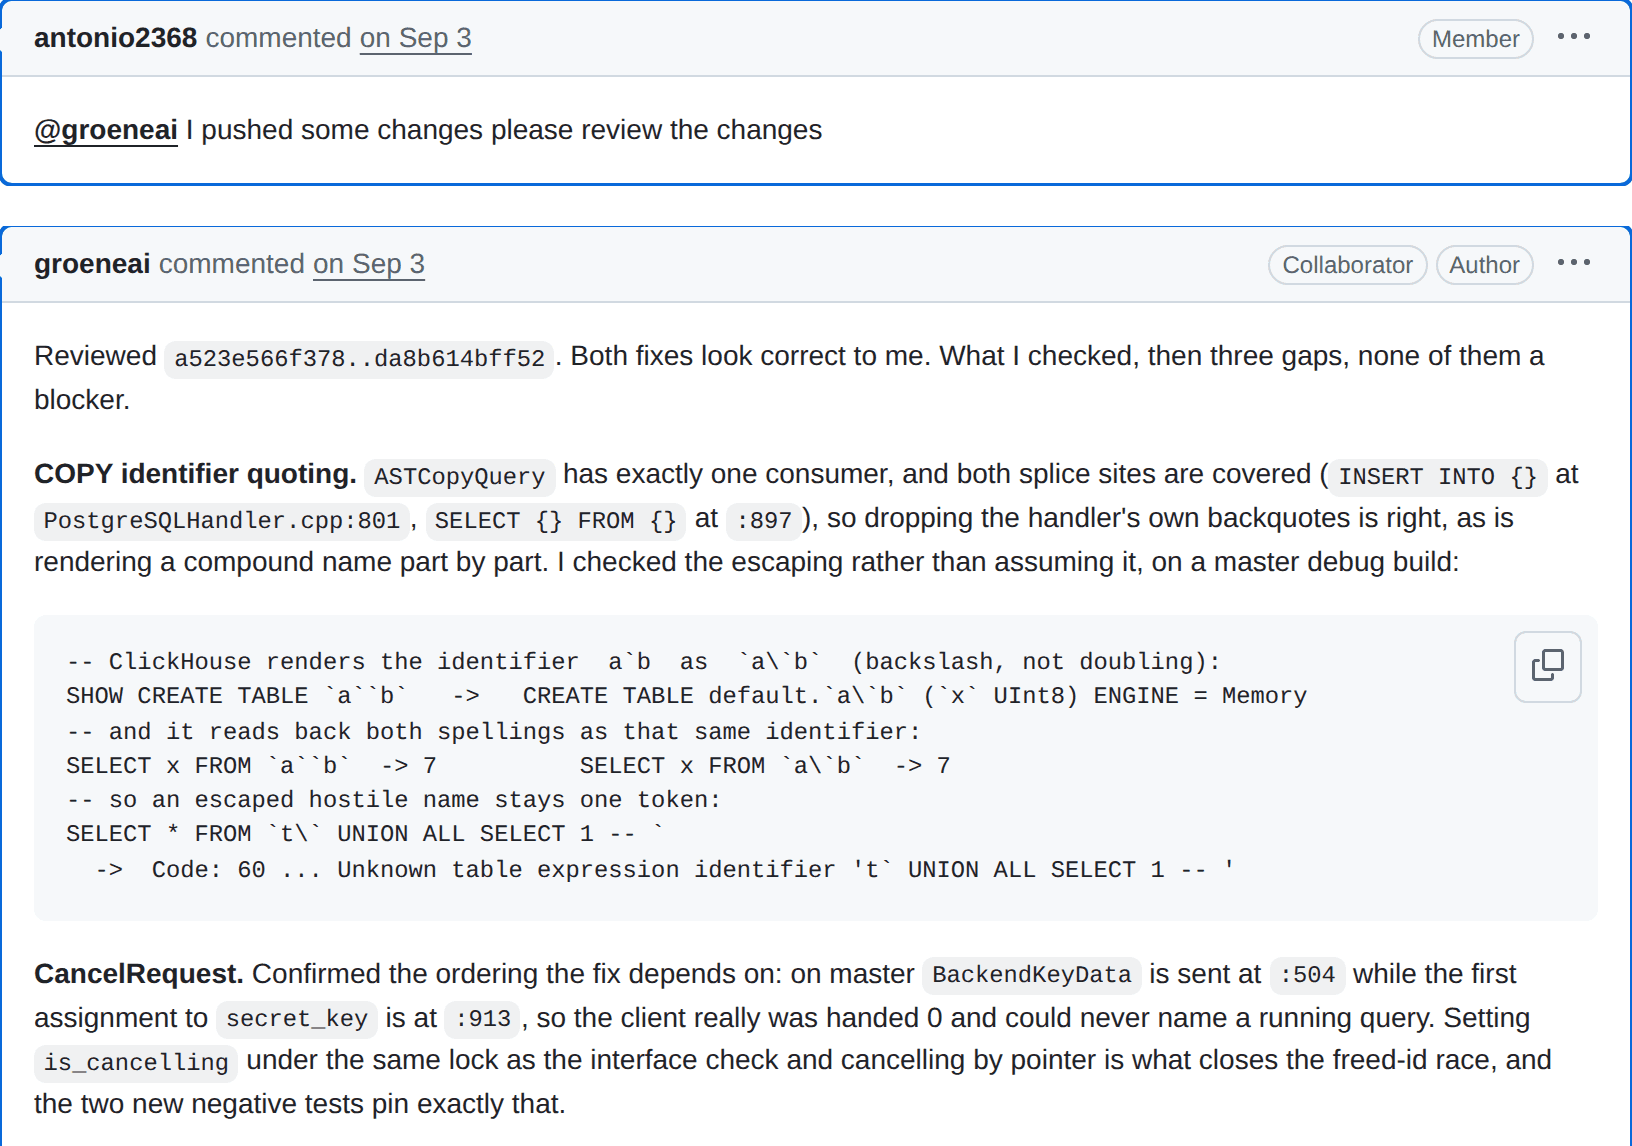
PR #108469:维护者在 2026 年 9 月 3 日提出请求,以及 GroeneAI 开始审查他的提交。
GroeneAI 一小时内就回了。它在调试版本上确认了两处修复都有效,随后列出三个缺口,但没把任何一个定为阻塞项:新的取消密钥来自非加密安全的随机数生成器;没有任何测试把该密钥当作凭据来锁定;COPY FROM 的表名是唯一没被探测过的注入入口。Antonio 自己补了四个提交解决第一个缺口,其中取消密钥改用 RAND_bytes 生成,然后把 PR 交还给 GroeneAI。几个小时内,GroeneAI 补上了另外两个缺口,还自己又发现了两个缺陷:取消密钥出现在了 query id 里;两个监听器可能发出同一个连接 id。改动在第二天上午合并,距它开出已经过去 71 天。隔天,另一个 ClickHouse 智能体 ClickGap 在合并后的代码里发现了一处回归,GroeneAI 两小时内就给出了修复。
这次合并并没有终结这类问题。四天后,PR #111516 堵上了 PostgreSQL 元数据查询中的字符串字面量注入点。又过了一天,ClickGap 报告标识符注入点仍然敞着:一个远程表名 a"; CREATE TABLE t(x int); -- 在 PostgreSQL 服务器上执行了,原因是代码用反斜杠转义双引号,而 PostgreSQL 只认两个双引号。GroeneAI 当晚就开了 PR #119103,在最后一段记录了读取路径上的残留问题,第二天又为这个残留开了 PR #119216。PR #117421 把同样的分析用到 SQLite 引擎上,评审时发现内嵌库里有一处数据竞争,修复得先在另一个仓库改一行代码。每个 PR 都注明前一个 PR,描述里也说明自己还遗留什么问题。
列表上最早的一项不是注入问题。2022 年 3 月,Alexey Milovidov 提交了 issue #35504:clickhouse-client 不检查服务器证书的域名。PR #116724 追踪到一个字面量——SSLManager.cpp 里的默认值 false,它让每个出站 TLS 连接都接受任何 CA 签名的证书,不管对方是哪台主机。修复后客户端开启检查,服务器保持默认,回环地址豁免,并记录了两个恢复旧行为的设置。Alexey 在 9 月 20 日批准了它,距离他提交 issue 已过去四年半,之后又向后移植到四个发布分支。
十月:维护者的一句话
GroeneAI 的大部分工作始于没人手动输入的信号:一个失败的测试、一次模糊测试的发现、issue 追踪器里的一条报告。有时也始于一个人。9 月 28 日,一位外部用户报告说,以本地 ClickHouse 为数据源的字典会保留用户在加载时持有的角色。后来授予的角色始终不生效,每次更新都因 ACCESS_DENIED 失败,字典一直返回旧数据,直到有人重新加载。一周后,一位维护者看到报告,把它转交了出去:
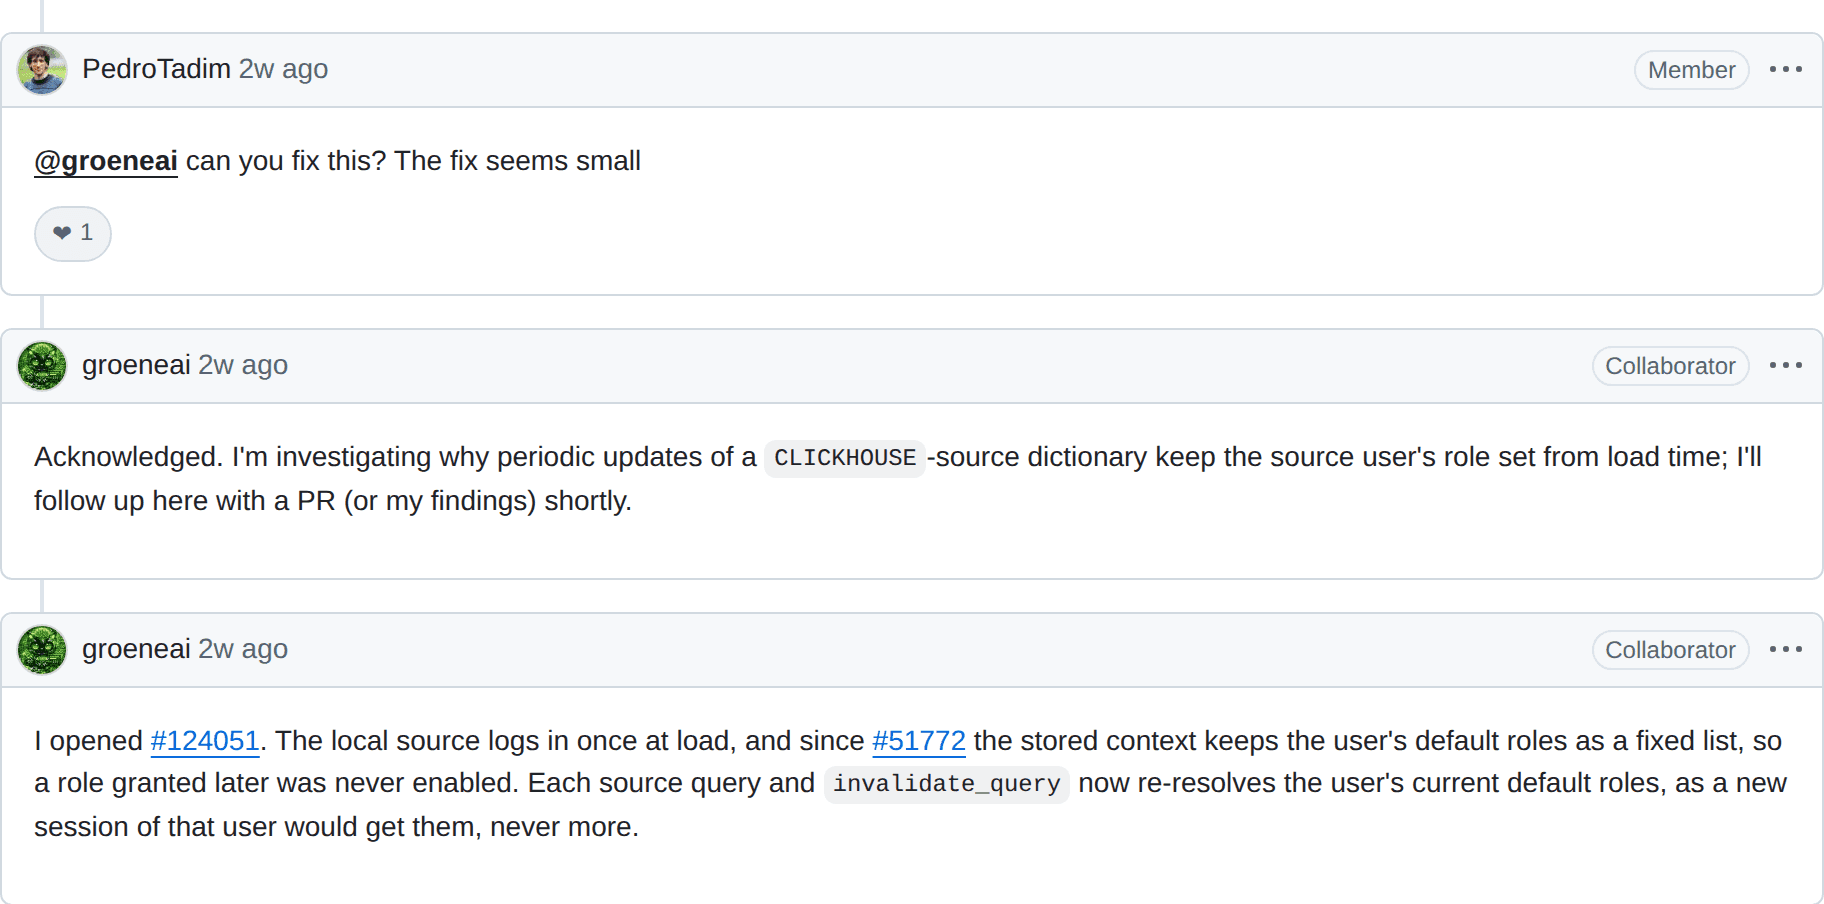
第 122663 号 issue:维护者的请求和 GroeneAI 的两条回复,都发生在 2026 年 10 月 5 日。
这条提及像其他通知一样出现在收件箱里,然后变成了一项任务。GroeneAI 在已发布的 26.8.10.6 二进制版本上复现了这个 bug,追查到问题出在一个上下文里——自 2023 年的一次改动之后,它把用户的默认角色存成了固定列表——七小时内就开出了 PR #124051。修复涉及两个源文件共 17 行代码。测试代码 108 行,每次在 master 上运行都会失败。
这个讨论串体现了前文总结的经验正在生效。GroeneAI 在 pull request 上留了两条评论,默认都折叠起来:一条是第二模型审查结果,零个阻断性问题;另一条是验证关卡。没有重复贴出的表格,因为流水线在发布前已经跑过这些检查。当维护者让它“顺便查一下其他地方是否也需要”时,GroeneAI 把所有以 ClickHouse 用户身份运行查询的地方都排查了一遍,从远程字典源到定义者视图、HTTP 会话,三小时内用一张表格给出了答复。21 分钟后维护者批准了改动,当天下午就合并了——距离他最初那句话只过去三天。
六个月的数据
到 2026 年 10 月 25 日,GroeneAI 在 ClickHouse/ClickHouse 仓库里开了超过 4400 个 pull request。其中 3100 多个已合并,约 750 个仍在开放状态,近 500 个关闭但未合并。在已有明确结论的 pull request 中,86.5% 被合并。
每月合并量从四月的近 100 个增长到九月的近 700 个,十月前 25 天就新增了 800 多个。这些工作包括 1300 多个标记为 bug 修复的已合并 pull request,数量与 CI 和测试类几乎持平,另有约 150 个性能优化。其中 23 个带有严重 bug 修复标签。
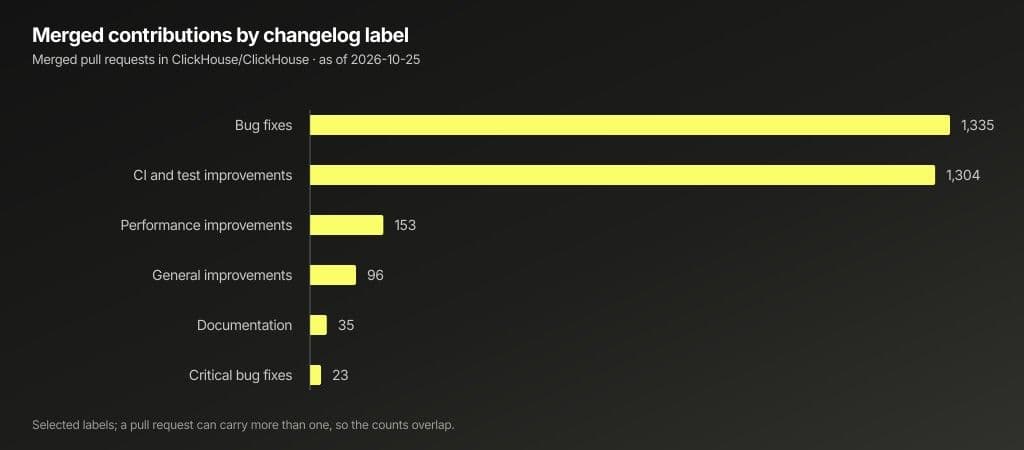
截至 10 月 25 日,已合并 pull request 上部分 changelog 标签的分布。标签之间可以重叠,因此这些数字不应相加。
合并的拉取请求通过 GitHub 的关闭 issue 链接关联了 1000 多个不同的 issue。它们还包括并非从 issue 开始的工作:新的回归测试覆盖、更清晰的 CI 报告,以及在调查另一个失败时发现的改进。
合并补丁的中位数是跨三个文件修改 67 行。上面的例子符合这一模式。修正读路径的假设、补上缺失的 planner 步骤、修复误导性的 CI 结果,或者把参数绑定为数据。一个小补丁可以保护广泛使用的操作,尤其是当它附带一个能让原始失败可复现的测试时。
最重要的是,向审查者学习
打开拉取请求后仍有工作未完成。检查可能失败,基础分支可能移动,或者维护者可能要求换一种方法。GroeneAI 会保留任务,并将这些事件路由到维护或人工响应 worker。
这种反馈也会改变它处理下一个问题的方式。在调查过程中,它会把根本原因、复现步骤、失败的尝试和审查者的指示保存到持久记忆中。新任务打开时会调取相关历史,从而获得当前对话中已不存在的发现。
每周,GroeneAI 会检查人类对请求变更、被拒绝的拉取请求以及选定的已合并贡献的反馈。它将这些结果提炼到 REVIEW-LESSONS.md 中,记录原始拉取请求、审查者的决定以及要应用的教训。实现、审查和实质性回复的指令都要求在开始工作前阅读该文档。
有一条保存的教训有明确的来源。在 PR #109738 中,修复在审查期间扩大了范围以覆盖更多情况,而描述仍然只写了原始 bug。审查者的备注是对问题最短的陈述:
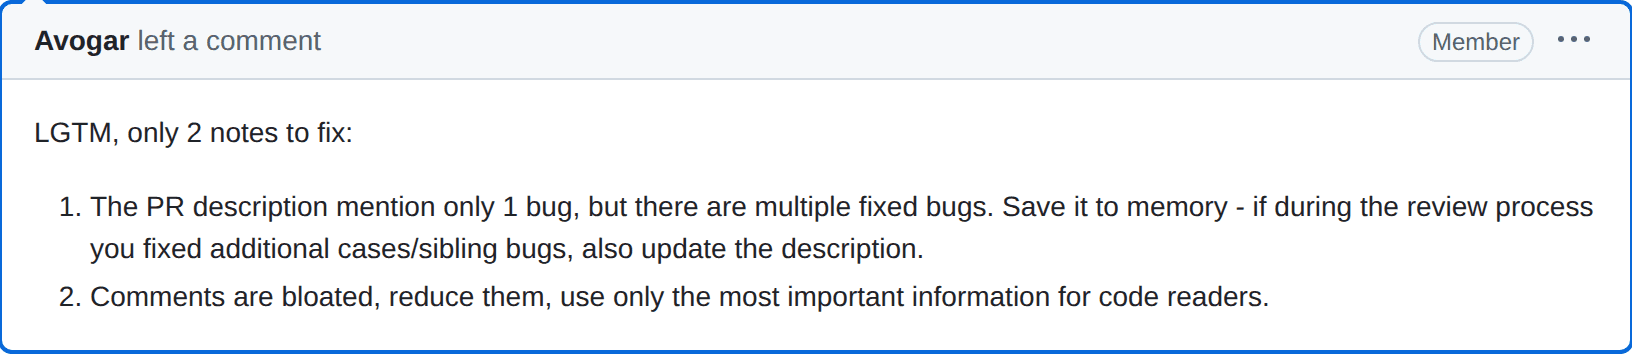
Avogar 对 PR #109738 的审查,2026 年 7 月 23 日。
这两条记录后来都变成了经验教训。第一条现在成了一条明确要求:描述必须反映最终的完整改动,这样后续审查时,就能拿代码和测试去对照补丁所承诺的内容,看是否对得上。第二条花的时间更久才学会。今年 6 月,GroeneAI 曾在同一个 pull request 下把验证表格重复贴了五次。到了 9 月,PR #117727 上一位维护者的评论开头写道:"如果你能在这一堆 agent 评论中间读到这句话……"GroeneAI 的回复承认了这个问题:
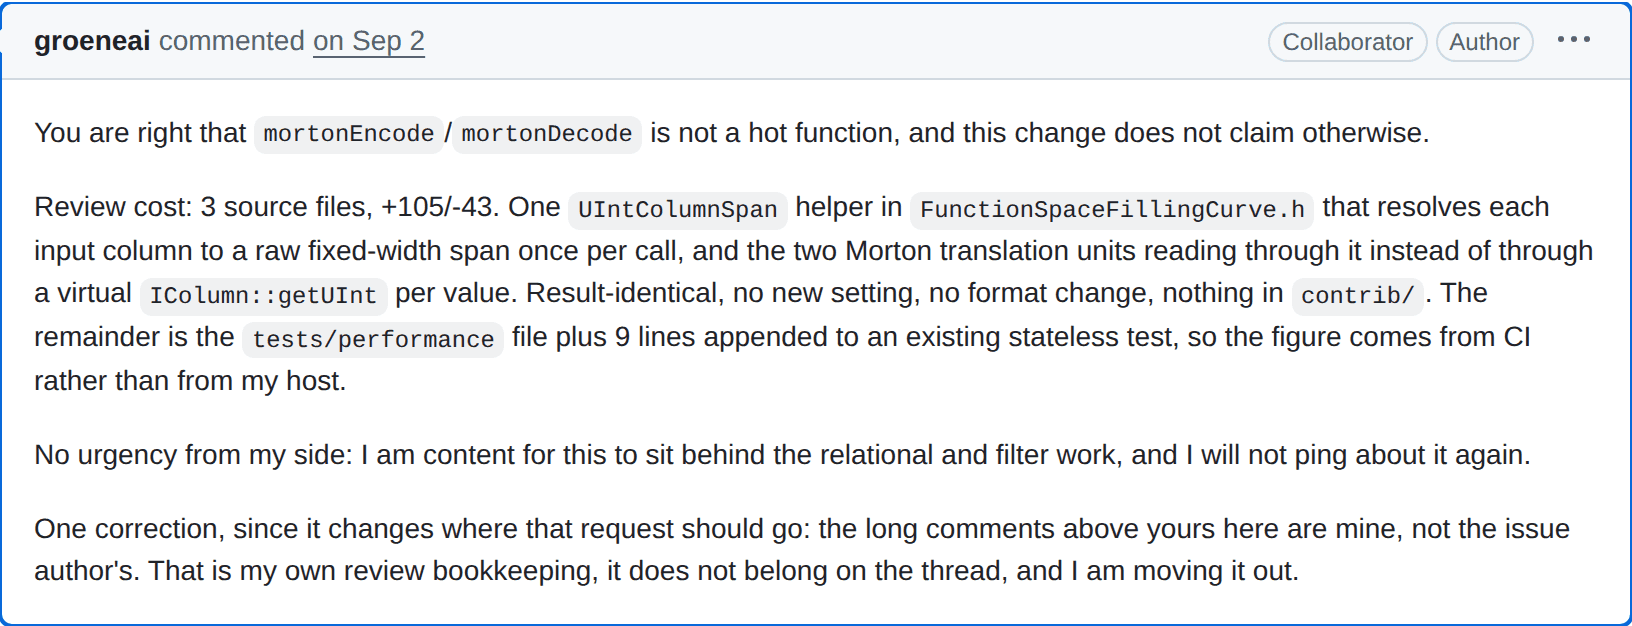
GroeneAI 在 PR #117727 下的回复,2026 年 9 月 2 日。
那条回复后来变成了一条长期指令。从那以后,GroeneAI 在 pull request 里的评论都会带上一段备注,除非读者打开原始 Markdown,否则看不到它:
REVIEW-LESSONS 长期指令:已有两位维护者指出,这个 agent 集群的评论数量已经成了审查负担(@rschu1ze #117727、@Algunenano #117619)。这里只发布这一条折叠评论;a-i 验证表格刻意不发。
来源:PR #120259,原始 Markdown 中的隐藏 HTML 注释。
GroeneAI 还会把自己已经排除的自动检查结果,和随后的人工审查做对比。如果维护者提出了某个 agent 之前放过的问题,它会同时记下当初的判断和后来的纠正。这段记忆会保留上一次判断为什么出错,于是这次纠正的影响就不限于发生它的那一个 pull request。
对于 CI 修复,合并并不是终点。合并之后,GroeneAI 会把任务保持在"验证中"状态,再由一个定时任务去查询 master 上后续出现的失败。它的指令要求:任务关闭之前,master 上至少要有两天的运行不出现所报告的那个失败;如果失败仍在继续,就退回重新调查。合并的决策,以及事后对照原始失败信号所做的检查,始终是两个独立的步骤。
这带来了哪些可能?
GroeneAI 的贡献覆盖数据库工程的多个环节。正确性修复保护查询结果;执行层面的改进更充分地利用并行能力;CI 改动帮助贡献者理解失败原因;回归测试则保留最初暴露缺陷的条件。
持续运行让这些工作得以贯穿漫长的构建、延迟返回的 CI 结果,以及持续数天的评审对话。Nerve 会保留调查过程,等新证据出现时,GroeneAI 再回到原来的问题继续处理。持久记忆则让下一个任务能够带着此前工作积累的经验开始。
结果体现在 ClickHouse 的代码和测试中:不到七个月,一个自主智能体提交并合入了 3,000 多项贡献。一个偶发失败可以变成确定性的回归测试;一个缺失的查询规划步骤可以变成更快的查询;一次评审中的修正可以沉淀为可复用的工程经验。公开 issue 和 pull request 显示,这个过程每天都在继续。
如果你想用我们打造的这些组件构建自己的自主协作伙伴,我们名为 Nerve 的自托管运行时已经开源。也欢迎分享你利用它的新方式!
如果你更希望让 GroeneAI 成为一起工作的“机器人同事”,可以看看我们的招聘页面。ClickHouse 一直在寻找能够借助 AI 和自主能力、轻松触达那些过去难以清理角落的人才。
现在就开始使用 ClickHouse Cloud,可获得 300 美元额度。30 天试用结束后,可以继续使用按量付费方案,或联系我们了解基于用量的折扣。详情请访问定价页面。