多智能体框架中如何组织上下文
摘要
大多数 agent 框架(harness)都有 subagent(子智能体)功能,用来让主控 agent 派生出新任务。子智能体可以并行推理、隔离上下文,这样主控 agent 就能把活分出去,而不必把中间过程塞进自己的上下文窗口。
主控 agent 负责说明任务,子智能体通常在一个全新的上下文窗口里完成它。这样做有浪费:子智能体可能重复执行一些收集上下文的操作,比如读文件,而这些主控 agent 其实早就做过了。
于是我们做了 forked subagent(分叉子智能体),用在「子智能体能从主控 agent 的上下文里受益」的场景中。分叉出来的子智能体不再从零开始,而是直接继承主控 agent 的完整对话。相比隔离式的子智能体,分叉往往更快、更省钱:复用主控的对话可以吃到提示缓存(prompt caching)的红利,也减少了重复劳动。
带子智能体的框架
把任务委派给子智能体,是 agent 管理自身上下文的一个有效办法。子智能体带来上下文隔离,让单个任务的细节不会进入主控 agent 的上下文窗口。想了解更多,我们曾详细写过各种多智能体架构。
其中 supervisor(主管)模式通用性最强,大多数编码框架都采用了它。它的做法是:主管维护一份计划,把具体工作分派给专用的子智能体。比如:
-
Worker(执行者):完成边界清晰的具体实现。
-
Reviewer(审查者):对已完成的工做给出独立判断。
主管 agent 一般只会收到子智能体返回的任务结果,子智能体的中间推理过程不会进入它的上下文窗口。不过,子智能体该从主管那里拿到哪些上下文,取决于这个子智能体是干什么用的。
子代理的上下文模式
为了把这件事讲清楚,我们在最新版 deepagents 中引入了「上下文模式」(context mode)。它用来规定子代理能从主管代理(supervisor)那里拿到哪些上下文。目前支持的取值为 "isolated" 和 "fork"。
隔离式子代理(isolated)
这是 Deep Agents 中子代理原本就有的默认行为。子代理启动时拿到一个全新的上下文窗口,只有主管代理给它的任务描述。

分叉式子代理(fork)
把模式设为 "mode": "fork",主管代理当前的状态就会传递给子代理,而不是让它从空状态起步。这实际上是从当前线程分叉出去的一条延续线——额外加上一段由主管代理写好的指令——最后再收敛成一条工具调用结果,交回主管代理读取。
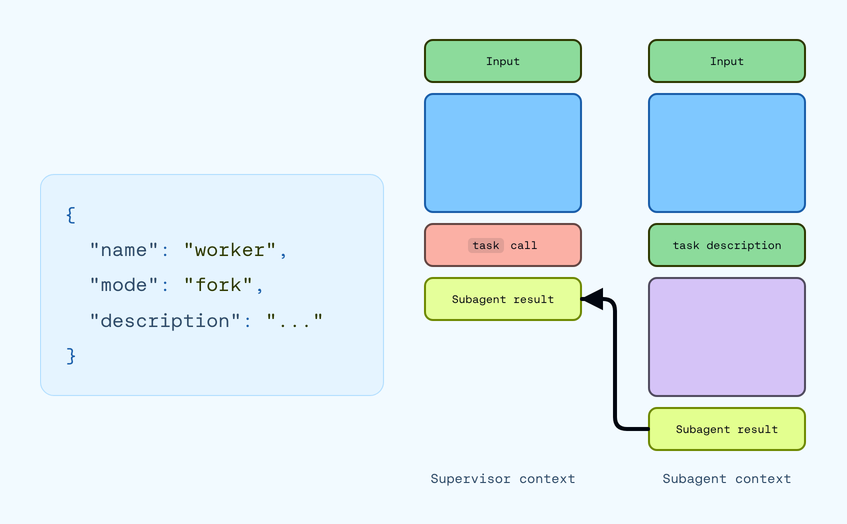
具体流程是:
-
主管代理生成一次工具调用,附带任务描述,用来唤起子代理。
-
子代理拿到主管代理的完整状态,包括对话历史。末尾那条工具调用会被剔除,它的任务描述则被整理成一条用户消息,同时附上一段固定前言,说明子代理的角色。
-
子代理完成后,它最后一条消息会作为对最初那次工具调用的响应,返回给主管代理。
分叉式子代理虽然比隔离式子代理带入了更多上下文,但设计上依然遵守提示缓存(prompt caching)。当子代理必须掌握详细上下文才能正确完成任务时,用分叉可以省下反复的工具调用和上下文收集。
如何选择上下文模式
选哪种上下文模式,取决于子代理与当前工作的关系。有个好用的思路是看两种常见角色:一种是接续主管代理工作的执行者(worker),另一种是独立评估其成果的验证者(verifier)。
Worker Agent:接续已经在进行的工作
主管已经收集好信息或做出决策后,再由 Worker 执行具体的某块工作。比如,主管先排查一个错误,定位到某个具体函数,然后把实现修复和测试的工作交出去。如果单独启动 Worker,它就得从头把证据再找一遍。用 fork 模式,Worker 能拿到主管的历史,接着之前的调查继续做。当某项工作有明确产出、而主管并不关心中间步骤时,就适合这样派发。
const fixerSubagent: SubAgent = {
  mode: "fork",
  name: "fixer",
  description:
    "Use when a problem has already been diagnosed and the remaining work is to implement and test the fix",
  systemPrompt: "...",
}
主管可能用它执行这样的任务:
根据我们发现的超时问题更新重试逻辑,然后补一个回归测试
Verifier Agent:独立评估工作产出
Verifier 会参照某些标准来审核另一个 Agent 的产出,比如检查一个 diff 是否正确、是否向后兼容、测试覆盖是否到位。
这种情况下,继承主管的推理反而会帮倒忙。Verifier 应该评估工作本身,而不该被主管的诊断或预期带偏。isolated 模式只把任务和相关审核材料交给它,不带上之前的对话。
const reviewerSubagent: SubAgent = {
  mode: "isolated",
  name: "reviewer",
  description:
    "Use after an implementation is complete and needs an independent review",
  systemPrompt: "...",
}
主管可能这样调用它:
审核这个 diff 的完整性、向后兼容性和测试覆盖是否充分。
我们之前写过 RubricMiddleware,那也是用独立 Verifier 的一个例子!
让子 Agent 专门化
和工具、中间件一样,上下文模式也是让子 Agent 专注某一类任务的手段之一。下面是我们认为比较专门化的几类子 Agent,以及它们和上下文模式的关系:
研究员 Agent:调查某个问题
研究员负责调查一个问题,然后把精简后的答案交回给主管。比如,主管可以把关于某个不熟悉的库、某个竞品,或者某项技术决策来龙去脉的问题分别派下去。
如果一个问题本身能独立成立,研究员就不需要主管的对话记录。用 isolated 能让它的上下文聚焦在手头的问题上。当多个研究员并行运行时,这一点尤其有用:如果每个都 fork,就会把主管的历史复制一遍,而每个研究员其实只需要自己分到的那个问题。
const researcherSubagent: SubAgent = {
  mode: 'isolated',
  name: 'researcher',
  description:
    'Use to investigate a self-contained question and return a condensed, well-sourced answer',
  tools: [search_engine],
};
主管可能会这样调用它:
确认 API 在 1.2 和 1.3 版本之间有没有变化,并附上相关发布说明的链接。
我们可以给子 Agent 配上自己的能力(比如 search_engine 工具),帮它完成任务。
记忆 Agent:保存对话中的信息
记忆 Agent 的职责,是从一次交互中挑出以后会用到的信息——比如用户的偏好、某项架构决策,或者对话过程中定下的某个约束。
在这里,对话本身就是 Agent 需要分析的材料。用 fork,记忆 Agent 能拿到完整的交互内容,自己判断哪些值得留存,不用主管在任务里再复述一遍。
const memorizerSubagent: SubAgent = {
  mode: "fork",
  name: "memorizer",
  description:
    "Use when the conversation contains durable decisions, facts, or preferences worth saving to memory",
  permissions: [
    {
      operations: ["write"],
      paths: ["/**"],
      mode: "deny",
    },
    {
      operations: ["read"],
      paths: ["/AGENTS.md", "/docs/**"],
      mode: "allow",
    },
  ],
};
主管可能会这样调用它:
把本次对话中定下的决策和偏好记下来。
我们想精确限制记忆代理(memorizer agent)能改哪些东西,所以可以给这个子代理加上文件编辑权限约束,让它只在自己负责的范围内活动。
上手试试
deepagents 是我们正在开发的一个框架,汇集了我们和上千个团队一起打磨代理产品时踩过的坑、攒下的经验。想体验子代理的上下文模式(文档见这里),以及更多功能,可以直接安装:
# Python
uv add deepagents
# Typescript
pnpm i deepagents
欢迎通过 GitHub issues、论坛,或者在 X / LinkedIn 上告诉我们你的想法!