用 OpenCode 搭建自托管的 AI 智能体环境,并让记忆跨设备共享
这篇文章是我在去米兰的火车上用手机规划好的。回到家后,我只打了一个词,它就上线了。下面讲讲背后的搭建过程,先交代一点背景。
如今,前沿模型基本都能通过 API 调用。常见用法是在自己电脑上装一个“外壳”(harness),比如 Claude Code 或 OpenCode,让 AI 智能体通过它操作本地文件、做出修改并产出结果。
单次模型调用本身是无状态的:要想延续之前的讨论,就得把相关上下文喂给它。这些上下文由外壳或模型厂商的 API 负责管理,可能包括对话历史、摘要以及筛选过的信息。很多智能体系统还会用到持久记忆,通常是一些关于重要事实和决策的笔记,能跨对话、跨项目延续。
先解决共享记忆
这个想法让我很感兴趣。我自己的环境太分散了:同时订阅了好几家服务商,网页上有对话,不同机器上各有本地会话,项目工作也散落在各处。
第一个问题就是把记忆在多台机器、多个外壳之间统一起来。我在一个共享文件夹里(我用的是 Dropbox,换成 Google Drive 也完全可以)定了几条记忆布局的基本规则。每个外壳都通过一段自定义指令来读取和更新相关笔记,这段指令写在全局的 AGENTS.md 里,Claude Code 则对应写在 CLAUDE.md 中。
布局本身很简单:
~/dropbox/memory/
├── MEMORY.md            # rules, conventions, links to notes
├── <note>.md            # detailed note on a concept
└── projects/
    └── <project>/
        ├── MEMORY.md    # same as above with short summaries for smaller models
        └── <note>.md    # detailed note on a concept
规则之一是:写入记忆的任何内容都需要手动确认。这样能减少同步冲突,也让记忆保持精简——即使现在上下文窗口很大,花在记忆上的每个 token 都是从实际工作里扣掉的。安全上也说得通,因为写进记忆的东西会同步到每一台读取它的机器和 harness。
在多台机器之间做本地工作时,光靠这一点就帮我解决了大约八成问题——这个数字的精确度嘛,你懂的。
一个常驻在线的环境接下来的问题是网页聊天和本地工作之间的切换。如果我坐火车时在某个服务商的网页聊天里开了个话题,等换到本地 harness 就得重新交代一遍背景,因为这些聊天不在我的共享记忆里。于是我开始研究自建一个 agent 环境,希望它能满足:
- 共享记忆:跨会话、跨项目都能用。
- 常驻在线:随时能接着聊工作。
- 跨机器连续:换台机器还能继续讨论、继续干活。
- 模型自由:不被某家专有服务商绑死。
- harness 自由:不依赖某家专有 UI。有了共享记忆,这一条的紧迫性其实已经降低了。
这些要求直接排除了专有的 agent 平台,但开源方案里可选的不止一个。OpenClaw、Agent Zero 和 Hermes Agent 都支持通用 agent、持久记忆和后台任务。它们中的某一个大概就能满足需求,但我还有两点额外考虑。
第一,我已经有一套可用的记忆结构,并且跨多个 harness 共用。我希望新东西能架在这套基础之上,而不是反过来把基础改造成适配新平台的样子。
第二,我想要自由,想往哪个方向扩展就往哪个方向扩展。我想自己掌控安全模型:agent 能访问什么、能在哪里执行命令、如何隔离、哪些操作需要我批准。
预置方案当然可以定制,但我想从第一天起就把边界划清楚。选好并连上这些组件,比把一套打包好的系统改造成我自己的安全模型要省事。
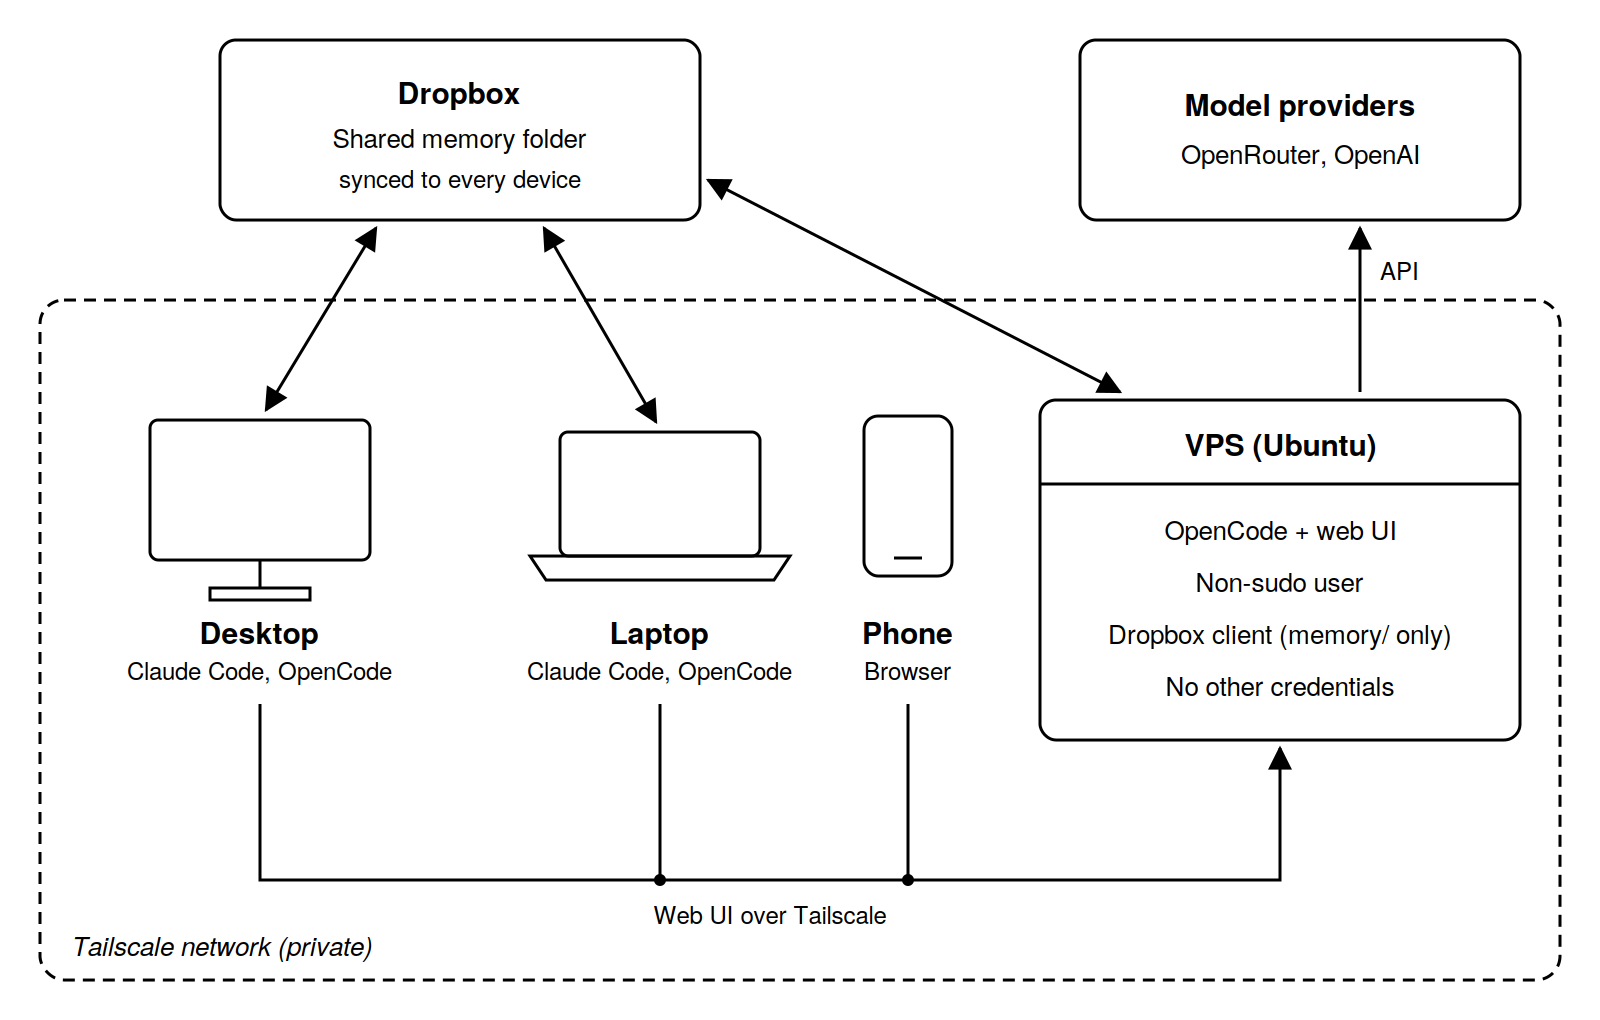
具体搭建对我来说,一个 Agent(智能体)环境需要这几样东西:一个现成的工作框架(harness)、共享记忆、远程访问,以及 Agent 能活动的边界。我的方案最后很简单:
-
OpenCode 跑在一台 VPS(虚拟专用服务器)上,模型通过 OpenRouter 和一个 OpenAI 订阅来调用。
-
我原有的共享记忆,通过无界面的 Dropbox 客户端按固定时间表同步到 VPS。
-
OpenCode 自带的网页界面,替我取代了各家的网页版对话。
-
通过 Tailscale 实现私有访问。
边界就是我的安全模型所在:
-
一台 Ubuntu VPS,OpenCode 跑在一个没有 sudo 权限的账号下。
-
不能访问 Tailscale 网络里的其他机器。
-
写入只限工作目录,其他位置只读。
-
除了模型提供商之外没有别的凭证(OpenRouter 的密钥设了用量上限),Dropbox 也是——它跑在另一个账号下,而且只同步记忆文件夹。
-
共享记忆靠 Dropbox 的文件版本历史和定期备份兜底。
这个想法我琢磨了好几天,真正动手实现只花了 90 分钟。方案的设计和实现都是 Opus 5.5 做的,其中大部分时间我都在坚持让它给我能手动执行的指令。大概做到 80% 的时候(又是这个数字),Tailscale 和 OpenCode 都已经跑通了,我放手了,让它自己 SSH 上去把活干完。是的,我知道在前面大谈安全模型之后这么做有点自相矛盾,不过那台机器上本来也没放什么凭证。
拿 Agent 来试用这篇文章的选题就是我想出来的,最初的讨论也是通过网页界面进行的。这个博客跑在一套自建的 Node.js 环境上,而我的共享记忆里早就有关于它的内容和风格的笔记,所以 Agent 能直接接手已有的上下文。
初始文本由我提供,然后和 agent 讨论研究方向和结构,再定下撰写和发布的计划,这些内容都存进了博客的 notes 里。整个过程都是在去米兰的火车上,用手机完成的。
回到家后,我在博客项目里新开了一个 Claude Code 会话,敲下 please continue。它根据共享记忆给出了一套实现和部署方案。我接着敲的下一个词是 go。五分钟后,文章就上线了。作为对照,撰写和打磨正文花了两个多小时——这更多说明的是我个人的问题,而不是这套配置的问题。
这正是我想要的连贯性:不管身在何处,都能先把活儿讨论清楚、规划好,之后换一台机器接着干。这也算从实践上验证了我对「不被工具绑架」的要求:规划在 OpenCode 里完成,实现在 Claude Code 里完成,共享记忆则是两者的共同基础。
到目前为止它一直跑得不错,我建议大家也可以试试类似的方案。拿本文里的这些组件当起点,去梳理你自己的需求,拼出一套合适的配置。任何前沿模型都能帮你做调研,并把它搭起来。
现在我已经有一个远程 agent 了,接下来打算再加几个,用来处理后台任务和其他有意思的工作。目标是打造属于我自己的 vicbot ;)