研究 / 无头代理
哪个编码代理 CLI 最适合无头工作流自动化?
Bulat· 与 AI 共同撰写 · 2026 年 10 月 21 日
编码代理 CLI 在终端里用起来感觉很快,但如果一个工作流每个任务都要在新容器里启动它,成本就会很高。我们测量了六款 CLI 的这项成本:启动、每轮耗时、内存、镜像大小和 token 消耗。
按每个任务的开销来看,pi 总体最轻。我们自己的 CLI——aictrl——没有拿下任何一项第一,但在四项上排名第二:会话时间、每轮框架耗时、内存和镜像大小。开销只是一半的答案:这个实验没有测量代理是否真的完成了任务,那是我们下一轮要做的。
Goose 的首次响应中位数最快,其次是 Codex、pi 和 aictrl。这四者彼此相差在 187 毫秒以内。pi 使用的 token 最少——无论是首次请求还是整个短任务——模型轮次之间耗时最短,镜像占用增加最少,并且最快完成脚本化会话。aictrl 在会话时间、每轮框架耗时、内存和镜像占用上排名第二。它的系统提示词现在和 pi 一样小,但工具定义还没有。
每张图表都从低到高排序,金色和银色奖牌分别代表该指标上实测的第一名和第二名。奖牌只描述这次实验;微小差距并不能确立稳定的领先地位。
披露:我开发了 aictrl。本文报告的是我们自己的测量结果,包括我们的实现落后的地方。文章和图表在 AI 辅助下完成。
我们测量了什么
2026 年 10 月 20 日,我们测试了以下已发布安装版本:aictrl 0.5.4、pi 1.3.0、Codex 0.163.0、OpenCode 2.1.0、Hermes Agent v0.22.2 源码和 Goose 1.55.0。Hermes 的源码归档报告版本为vunknown;我们在方法论中通过其固定发布的提交来识别它。
每次尝试都启动一个全新的非 root 容器,家目录为空,CPU 配额为两核,内存限制为 2 GiB。镜像已预先放在宿主机上,文件系统缓存未清除。这些是全新容器内的测量结果,不包括镜像下载和云调度。
本地脚本化模型(scripted model)固定延迟 50 毫秒后返回结果。这样一来,远程推理的波动被排除,读取多少次也由脚本说了算。这里测的是 harness(执行框架)自身的开销和原生工具调用能力;它测不出编码质量,也测不出模型自然多轮对话的效率。
这些数据背后的架构背景,可以看我们的智能体框架对比。文中讨论了在单次任务开销之外,框架和 harness 该怎么选。
每个 harness 采集了 20 次有效的单次响应尝试;50 次读取的记忆任务采集 5 次。每个场景先丢弃 2 次预热,各 harness 交叉轮换执行顺序。六个 harness 都走各自的原生工具循环:Hermes 没有转交给 Codex,Goose 也没有通过 ACP 转交。所有尝试都跑完了,runner 没有记录到失败。
各 harness 启用的工具集并不相同,这对 token 结果影响最大。pi 只带四个默认工具,没有子智能体(subagent)工具,也没装扩展或包。Goose 只启用内置的 Developer 扩展,没有加载 recipe 或子 recipe。Hermes 只启用 file 和 terminal 两个工具集;它的默认配置还会开启 web、浏览器、记忆和任务委派等能力。aictrl、OpenCode 和 Codex 用默认工具运行,三者各自都带一个子智能体工具。讲 token 的那一节里,另外加了一组测试,把 aictrl 限制成 pi 那四个工具。
每个 harness 都以非交互方式运行,并开启 JSON 输出。除脚本化模型的 provider 设置外,命令行参数如下:
- aictrl: aictrl run --format json
- pi: pi --mode json
- Codex: codex exec --json --dangerously-bypass-approvals-and-sandbox --skip-git-repo-check
- OpenCode: opencode run --standalone --auto --format json
- Goose: goose run --no-profile --with-builtin developer --output-format stream-json
- Hermes: hermes chat --oneshot --toolsets file,terminal --ignore-user-config --ignore-rules --format stream-json
runner 里保留了完整的适配器、环境和配置文件。
统计 token 数量时,我们另做了一轮采集,镜像和配置与前面相同。每个 harness 跑五次单响应会话、五次「50 次读取」会话,并保留全部请求体。所有 harness 的结果都用同一个参考分词器计数,即 OpenAI 的 o200k_base。这些数字是各 harness 实际发出内容的估算,不等于服务商计费口径的用量。
测量结果摘录、token 估算、CSV 和方法说明随图表一并提供。内存与占用以 MiB 为单位;请求体按实际 UTF-8 字节计算。点击任意图表可打开全分辨率图片。
Goose 的首响应中位数最快
计时从 docker run 之前立即开始,到 harness 的 JSON 输出中出现第一个匹配的助手响应事件为止。容器启动时间和我们的初始化封装都算在内。所以这不是模型的「首 token 时间」。
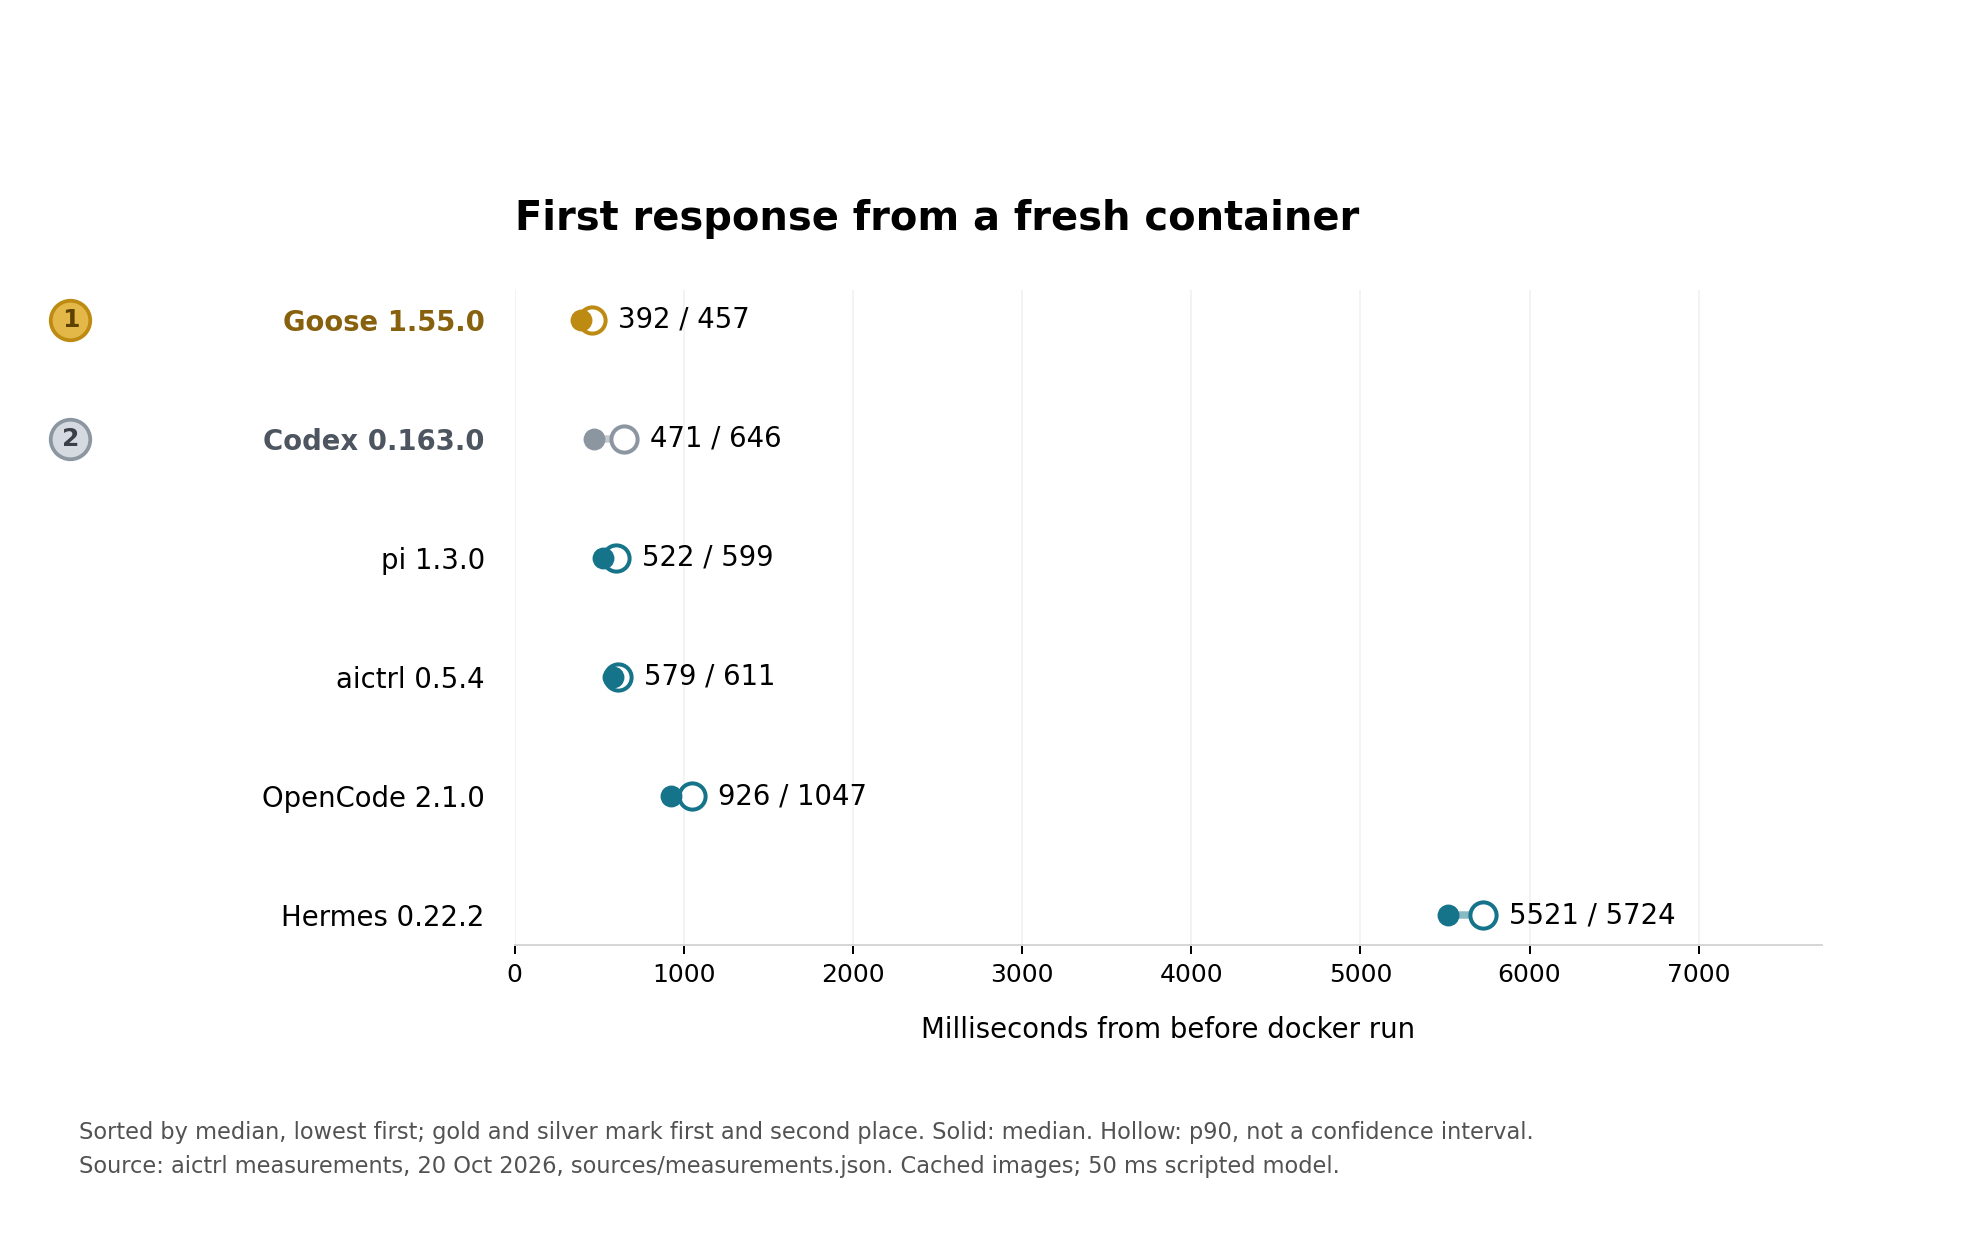
图 1。来源:我们对六款 harness 的全新容器测量,2026 年 10 月 20 日;每款 20 次尝试。图中连线不是置信区间。
Goose 的首响应中位数为 392 ms,其后是 Codex 471 ms、pi 522 ms、aictrl 579 ms。在共享主机上只跑 20 个样本,我不会断言这四者之间存在可复现的排序。绝对启动时间在不同轮次之间也会漂移:同一批 Goose、Codex、pi 和 Hermes 镜像,10 月 20 日测得的结果比前一天快 140 到 230 ms。另一次 aictrl 与 pi 的配对运行分别测得 503 ms 和 460 ms。启动时间只能在同一轮采集内比较。OpenCode 2.1.0 用了 926 ms,Hermes 5.5 s,这两个差距值得在同一套配置下做性能剖析。
这些都是受支持的安装方案,运行时、依赖和启动行为各不相同。pi 使用 Node 22,Hermes 核心使用 Python 3.14.8。其余三个 npm 安装基于 Node 20,而打包好的原生可执行文件可以自带运行时。正因如此,不能把结果归因于某一种编程语言。
内存占用取决于多少内容真正进入了下一次模型请求
这个长任务会读取 50 个不同文件,内容都是同一份 48,000 字节、800 行的测试数据,读完后再作答。文件路径不同这一点很关键:Hermes 通常会对没有变化的重复读取去重。我们保留了这个行为,同时要求每个 harness 都对同样大小的文件做真实的读取。
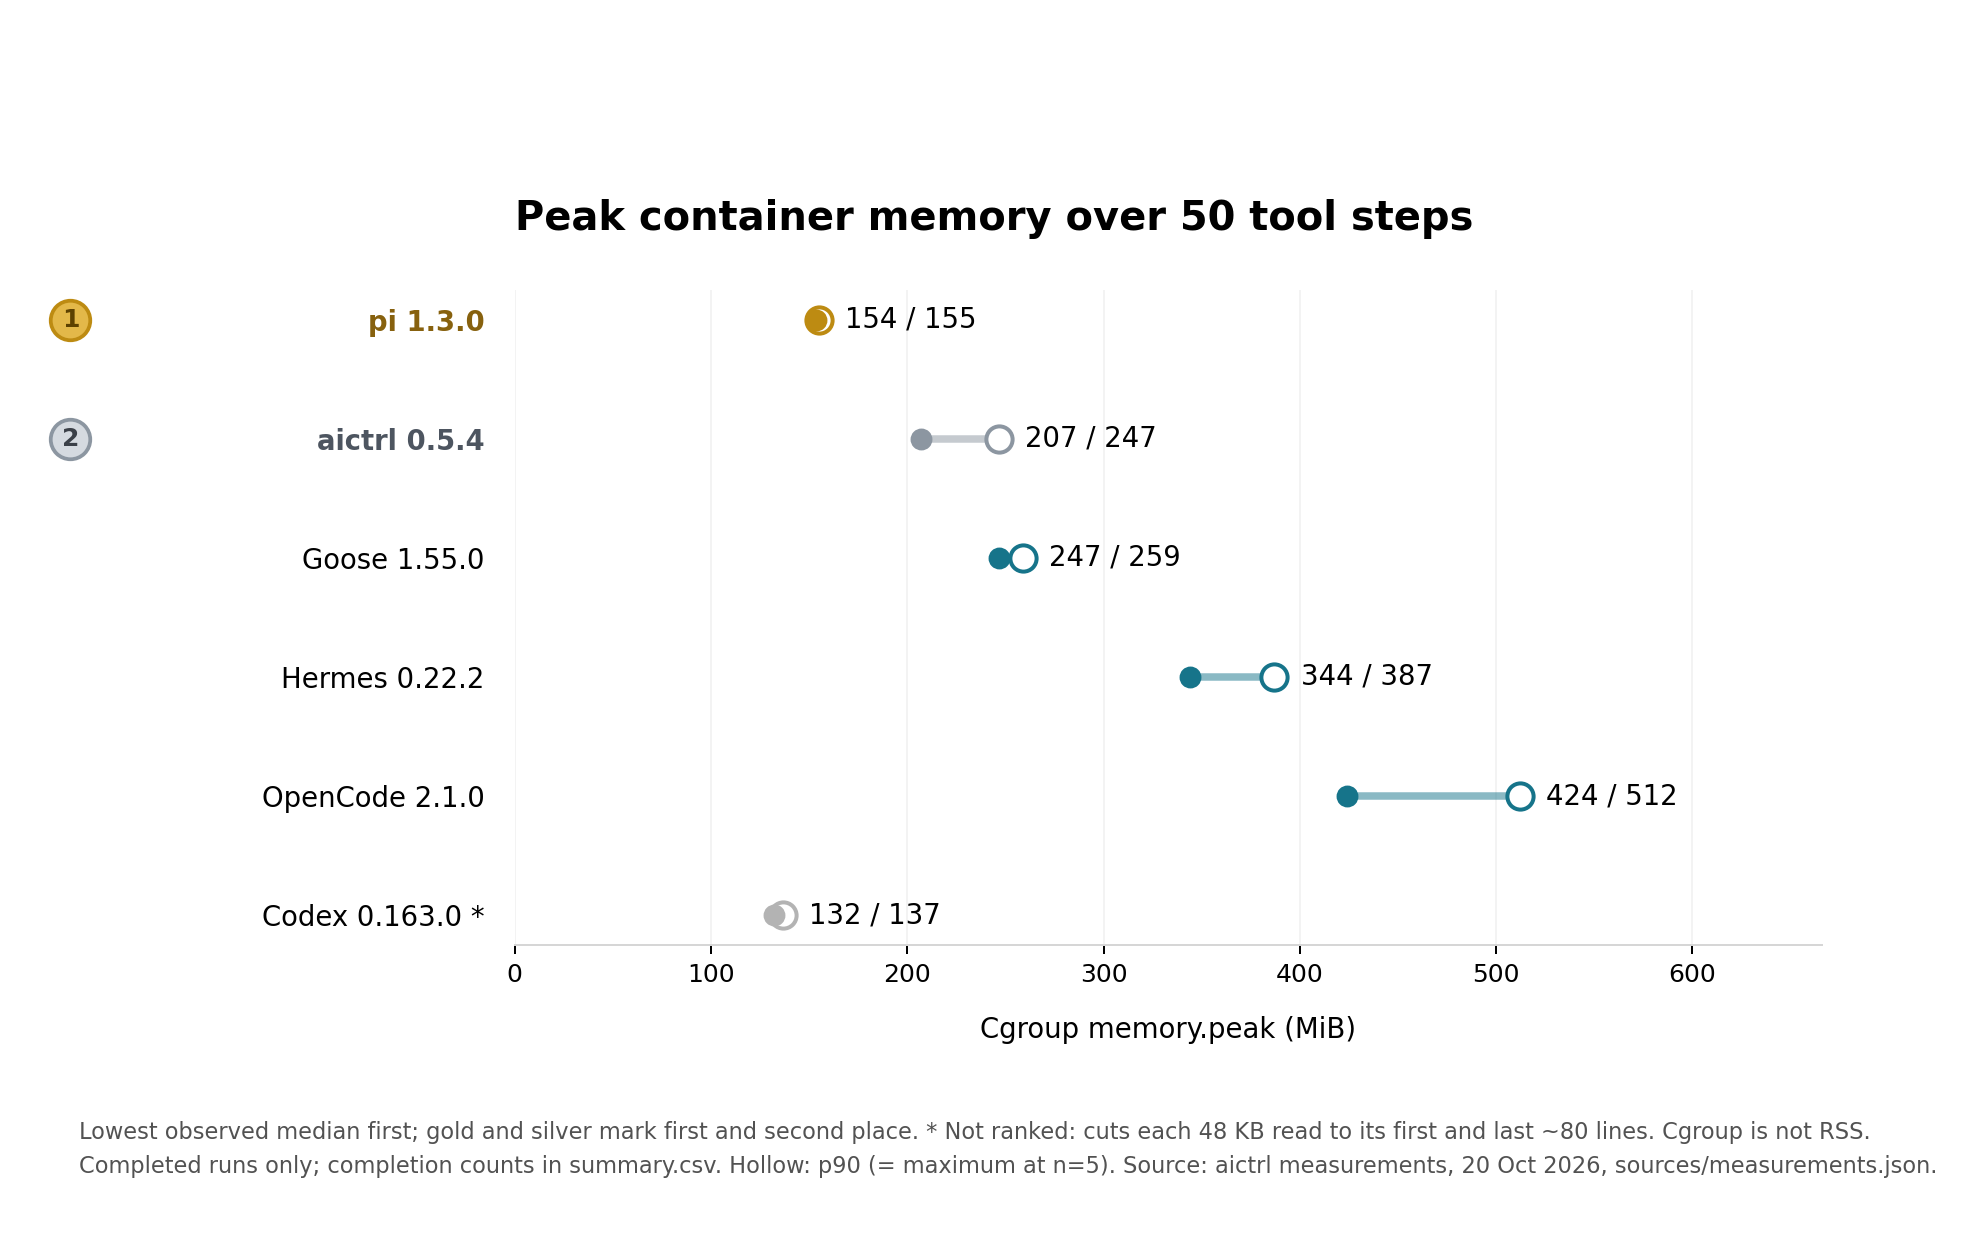
图 2。数据来源:我们六个 harness 的实测结果,2026 年 10 月 20 日。每个 harness 跑五次;完成次数和 RSS 记录在 CSV 中。只有五次全部完成时,最近秩 p90(即第 90 百分位)就等于最大值。Codex 列在最后、未参与排名:它只保留每个文件开头和结尾各约 80 行,因此它持有的上下文与别人不同。
六个 harness 都完成了全部五次尝试。pi 的 cgroup 峰值中位数最低,为 154 MiB,aictrl 以 207 MiB 排在第二。Codex 测出来是 132 MiB,但它持有的数据并不一样。它的 shell 工具会截断长输出:每个 800 行的文件,模型只看到第 1–84 行和第 718–800 行,并附有一条「已移除 38,000 个字符」的提示。这大约只相当于全文的五分之一。
最后一次请求,Codex 是 572,750 字节,其余几个是 246 万到 267 万字节。校验程序把 Codex 的五次运行都判定为「上下文被截短」;其他每个 harness 在五次尝试中都完整投递并保留了测试数据的全部内容。上下文小当然更省资源,但一个在审阅长文件的 agent 永远看不到文件的中间部分。
cgroup 内存里包含计入的缓存。宿主机页面缓存由谁承担,会改变哪个容器背上这笔开销。数据里也记录了最大进程 RSS 和采样求和后的 RSS,它们衡量的是不同的东西。单看 cgroup 读数偏低,并不代表进程常驻内存也同样小。
我们在下一次模型请求中核对源行覆盖情况,并在最终请求中再次检查所有结果。Codex 自带的输出上限让最终请求小得多。因此,它的内存结果无法证明它能更高效地存储等量对话。这个桩程序还会上报人为的用量数据,所以常规的、由 token 驱动的上下文压缩并未被真正触发。
耗时:会话时间花在哪里
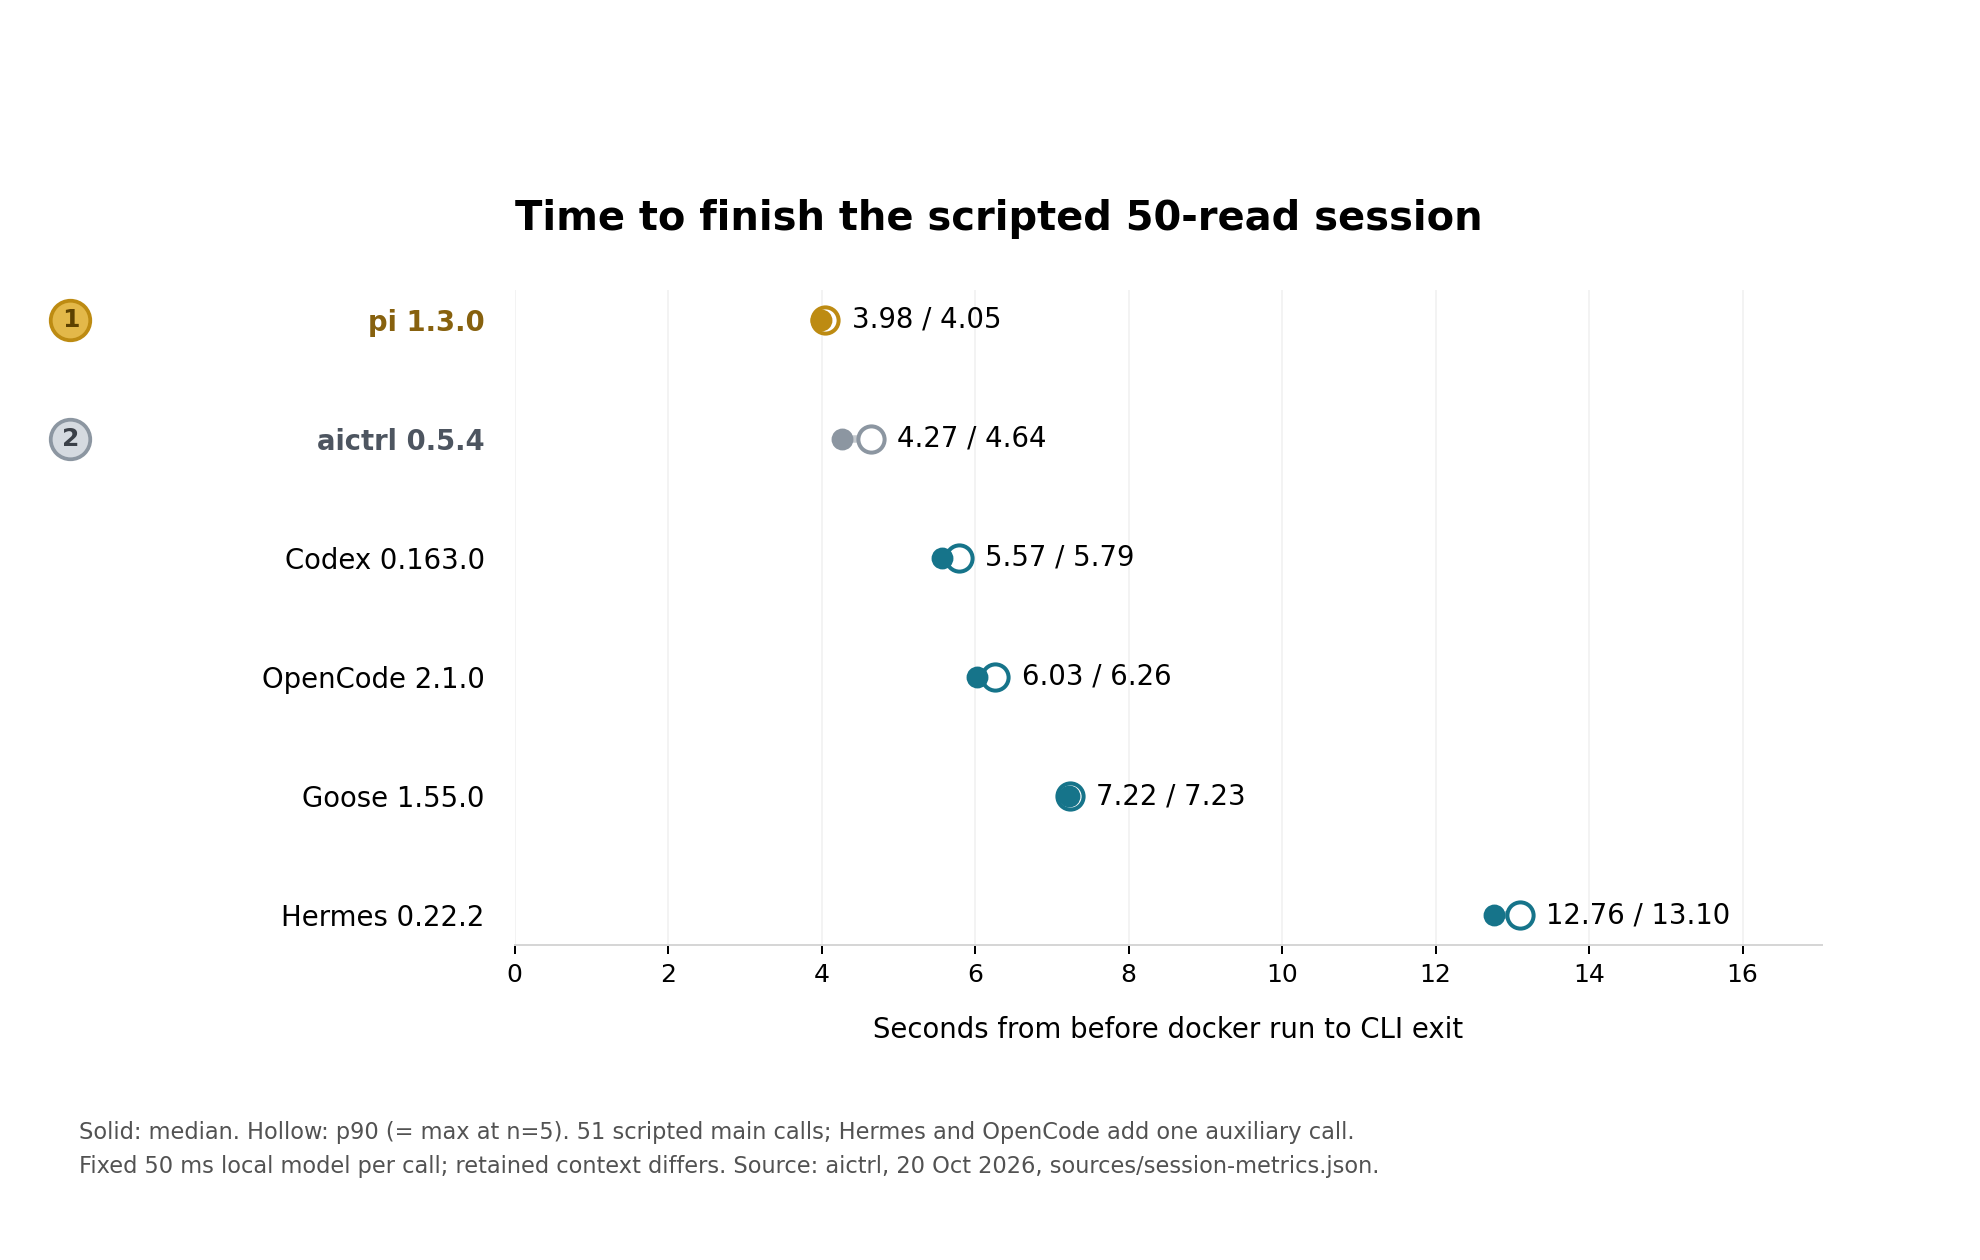
图 3。来源:会话测量,来自同一轮实验;每个框架完成五次会话。计时从容器启动前开始,到 CLI 退出为止,不包括之后证据的持久化。实心:中位数;空心:p90。
每个会话发起 51 次主模型调用:五十次工具调用响应,加一次最终回答。OpenCode 和 Hermes 各自额外做了一次辅助模型调用。调用次数由脚本强制设定,所以这个实验无法反映框架在真实任务上会跑多少轮。
但它能反映每个框架在每一轮里额外增加了什么。桩程序给每次请求和响应都打了时间戳,于是我们把会话拆成启动、等待模型、轮次之间的框架工作和关闭四部分。
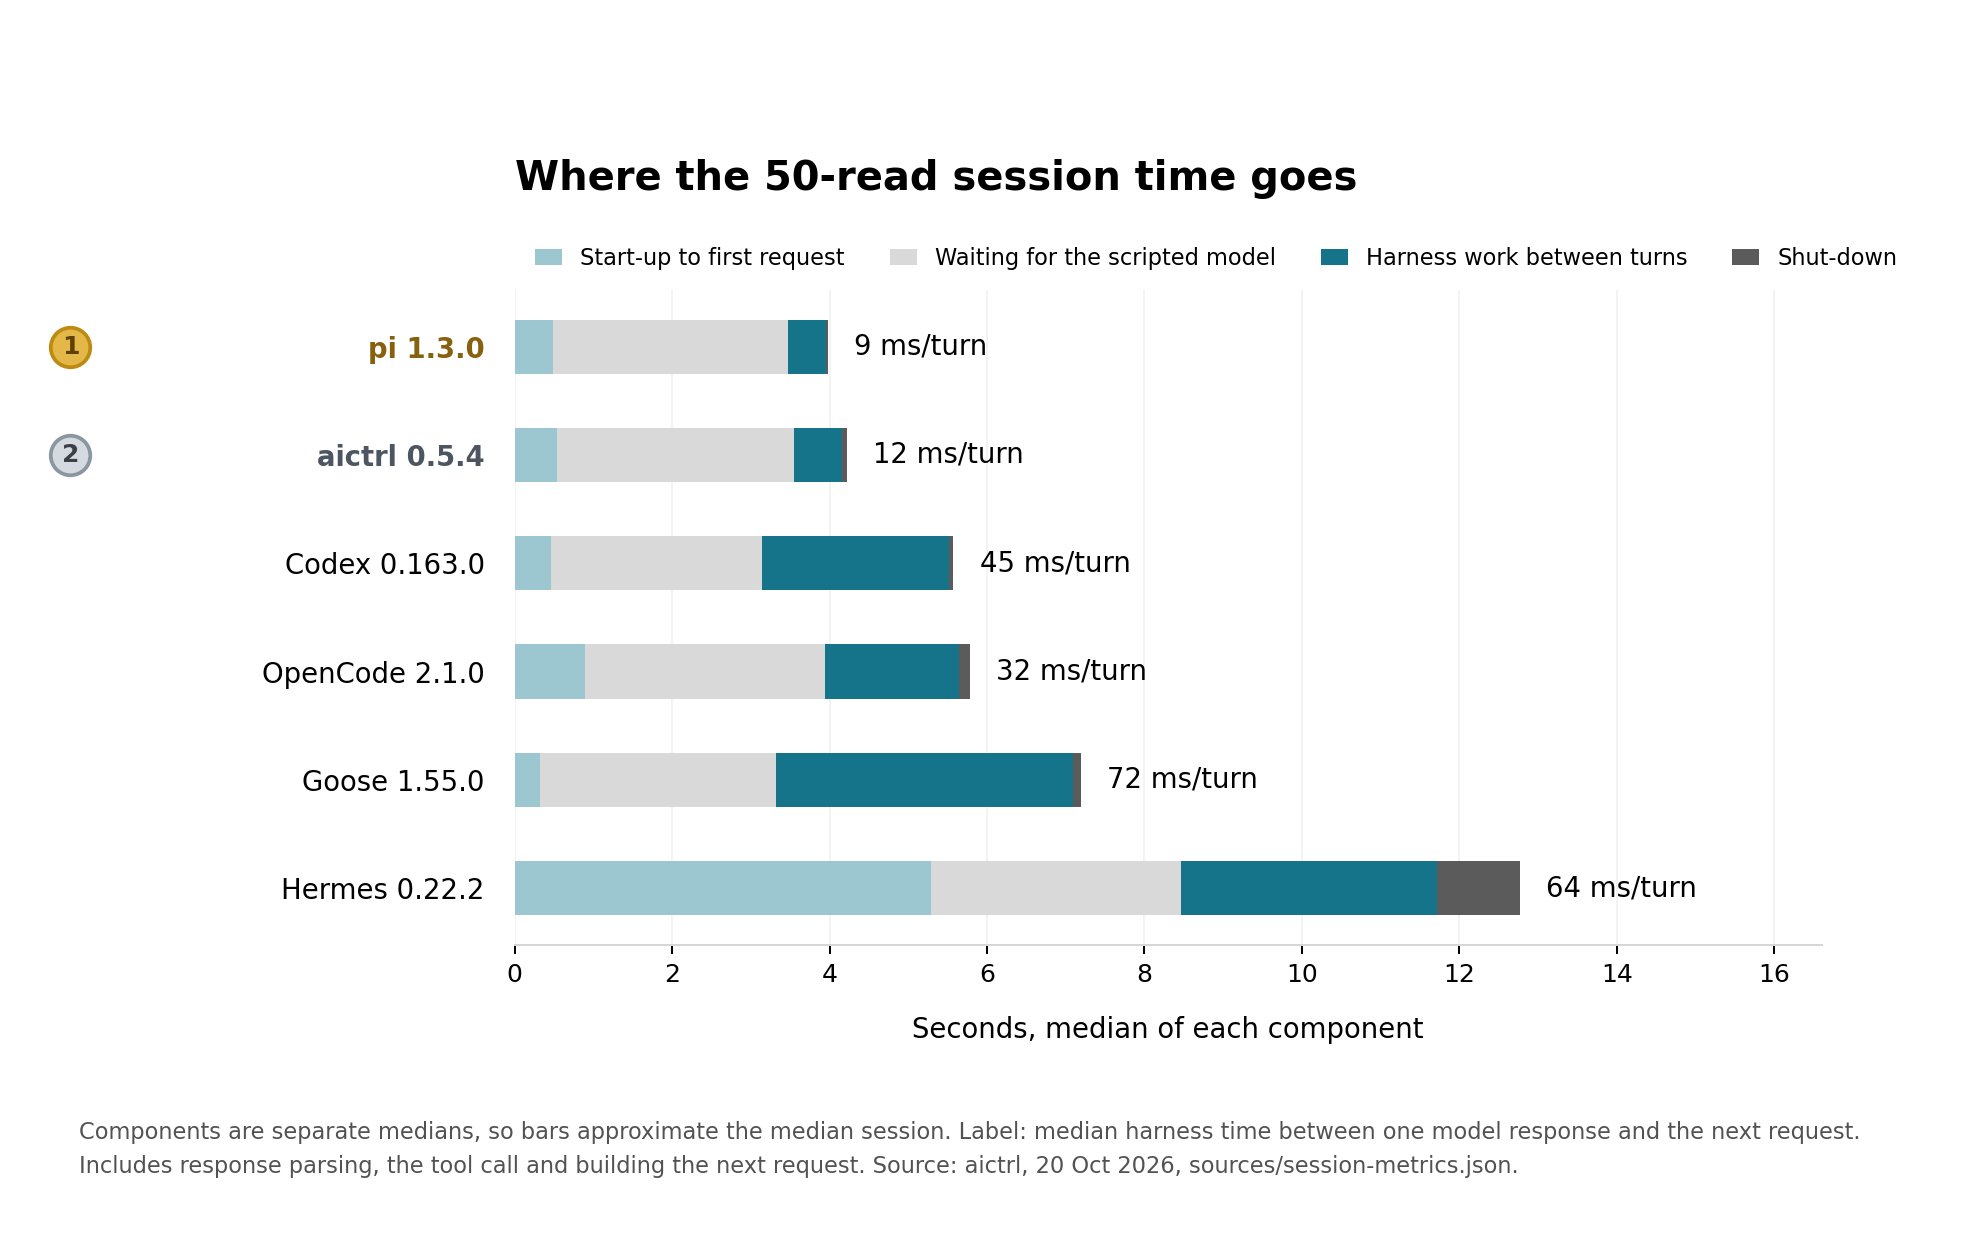
图 4。来源:会话测量,同一轮实验。每个部分取五次会话的中位数。轮次之间的框架工作,指从桩程序发出一次模型响应,到下一次请求抵达之间的时间:解析、执行工具、构建下一次请求。
各家的模型等待时间都在 3 秒左右:51 次调用,每次 50 毫秒,再加上序列化开销。差别出在框架工作上。轮次之间,pi 的中位数是 9 毫秒,aictrl 是 12 毫秒。OpenCode 为 32 毫秒,Codex 45 毫秒,Hermes 64 毫秒,Goose 72 毫秒。Codex 和 Goose 每次读取都通过 shellcat 执行,会启动一个进程。其余四个用原生文件读取器。
把整段会话的等待时间加总,中位数分别是:pi 0.5 秒、aictrl 0.6 秒、Goose 3.8 秒。Goose 每轮响应本来就更慢,波动也更大。不过换成真实模型后,每轮都要花上几秒,这点开销只占很小一部分。真正的关键在于轮数,而轮数由真实模型自己决定。Hermes 在发出第一个请求前还额外花了 5.3 秒,关闭时又用了 1 秒。
OpenCode 的 npm 安装体积最大
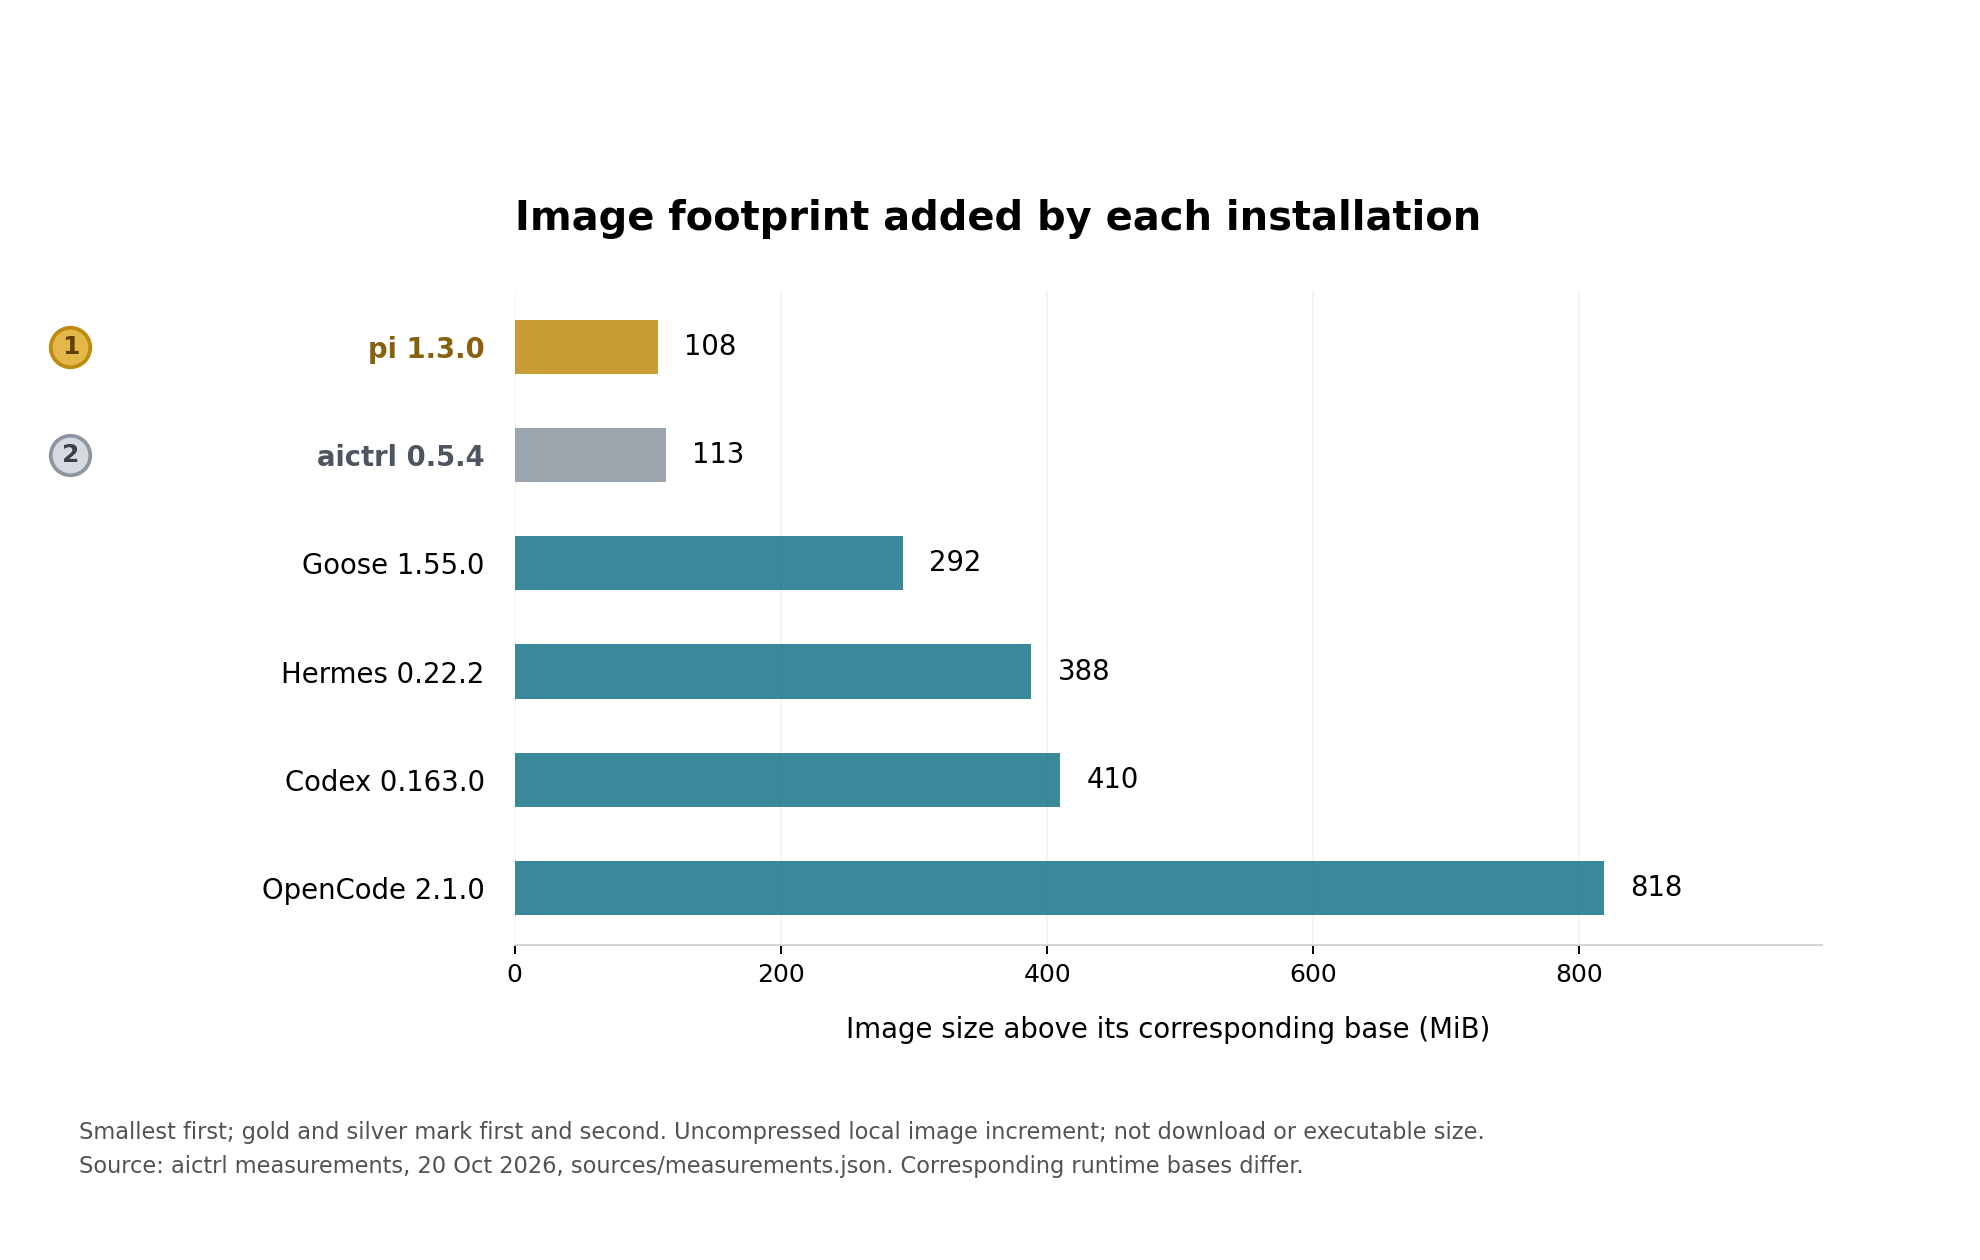
图 5。数据来源:我们自己的安装测量。数值是各运行时基础镜像之上的未压缩增量。它们不是从 registry 下载的体积、可执行文件大小或构建耗时;各运行时的基础镜像并不相同。
npm 给 OpenCode 2.1.0 装了四个 Linux x64 二进制文件:glibc 和 musl 各一套,每套又分普通版和 baseline 版。每个大约 204 MiB,而启动器只会用到其中一个。它的平台包只声明了操作系统和 CPU,没声明 C 库,所以 npm 没法跳过这台机器用不上的那些变体。
aictrl 的平台包声明了 C 库,因此 npm 只安装当前主机需要的那一个二进制,增量 113 MiB,比 pi 多出约 6 MiB。安装的包记录在build metadata里。
我们没有测量镜像拉取的耗时,所以这个实验只能说明存在重复打包,并没有量化它在部署阶段付出的代价。
Token:每次调用的固定开销,加上读取工具返回的内容
每次调用都会重发系统提示词和工具定义,所以这部分体积是每一轮的固定成本。我们把第一个请求拆成系统提示词、工具定义和其余部分,其余部分包括任务消息、harness 注入的上下文以及 JSON 结构包装。
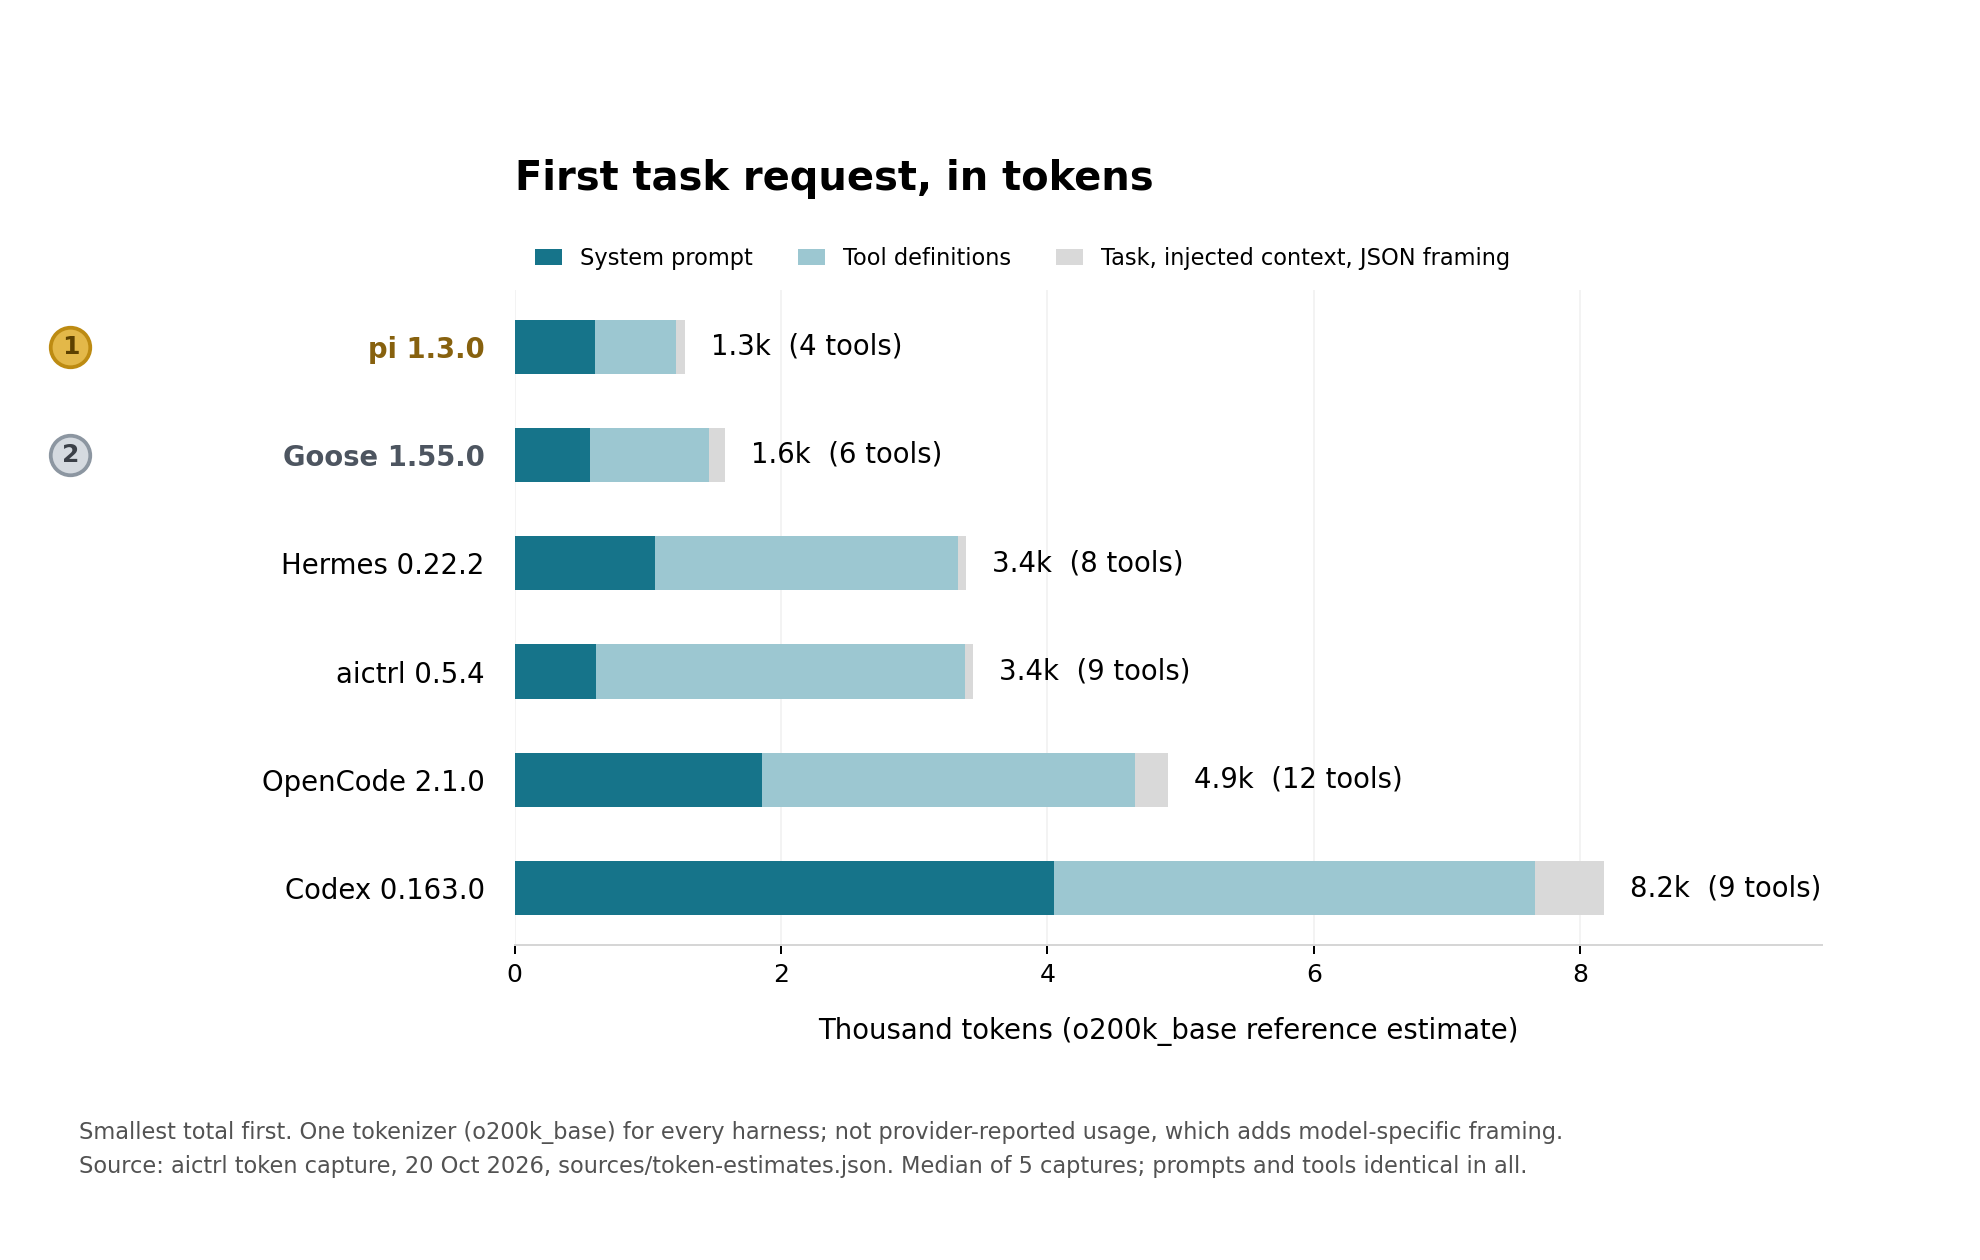
图 6。数据来源:采集阶段得到的token 估算,所有 harness 统一用o200k_base。工具定义按规范化 JSON 计数。模型厂商自己报告的数字还会包含各家特有的包装开销,与这里的数值会有差异。
| Harness | 系统提示 | 工具定义(工具数) | 首次请求总量 |
|---|---|---|---|
| pi | 2601 | 1609(4 个) | 11,276 |
| Goose | 1563 | 2897(6 个) | 21,577 |
| Hermes | 1,053 | 2,279(8 个) | 3,391 |
| aictrl | 608 | 2,772(9 个) | 3,442 |
| OpenCode | 1,857 | 2,799(12 个) | 4,903 |
| Codex | 4,047 | 3,614(9 个) | 8,178 |
| aictrl(仅保留 pi 的四个工具) | 608 | 1,421(4 个) | 2,091 |
aictrl 的系统提示为 608 个 token,与 pi 的 601、Goose 的 563 基本持平。它和 pi 之间的剩余差距,来自工具定义:aictrl 声明了 9 个工具,共 2,772 个 token;pi 只有 4 个,共 609 个。仅我们的 read 工具描述一项就占 394 个 token,而 pi 的只有 159 个。
这个差距主要源于设计上的取舍:声明哪些工具。pi 默认只声明 4 个工具,故意不包含子代理。它的 README 里写着,pi“跳过了子代理、计划模式这类功能”,并把子代理做成可选扩展,每个子代理单独跑一个进程。搜索则通过 bash 完成。aictrl 还额外声明了 glob、grep、webfetch、一个技能加载器,以及一个用来启动子代理的 task 工具。这五个工具会让每次调用多出约 1,350 个 token。OpenCode 的 12 个工具里同样包含子代理工具。
对于工作流自动化来说,这些往往超出了单步所需。工作流本身已经拆好了任务,每一步都是对 CLI 的一次范围明确的运行。某一步如果不做委派、或者不能委派,那么精简的工具集不会损失什么,反而每次调用都能省下这些 token。而一个宽泛、开放式的任务,仍然可以从子代理在独立上下文中探索中获益。
为了做对等比较,我们还测试了只保留 pi 那四个工具的 aictrl,通过权限配置禁用了另外五个工具。结果首次请求从 3,442 个 token 降到 2,091 个:系统提示 608 个,工具 1,421 个。这仍比 pi 高出 815 个 token,其中 812 个出在同样四个工具的描述更长上。这次运行还暴露出一个问题:即使工具已被移除,我们的系统提示和工具描述里仍然提到了 Task、Glob 和 Grep,我们正在修复。
要让 aictrl 只使用同样的四个工具,可以在 aictrl.json 或 AICTRL_CONFIG_CONTENT 环境变量的权限设置里加上这些禁用项。被禁用的工具会直接从请求中剔除:
{
  "permission": {
    "glob": "deny", "grep": "deny", "task": "deny",
    "webfetch": "deny", "skill": "deny"
  }
大多数工作流步骤都很短,此时每次调用的固定开销占了大头。在第二个场景里,每个 CLI 读取三个 340 字节的文件并作答,总共四次模型调用。每次调用都会重新发送系统提示、工具定义和此前的对话历史。
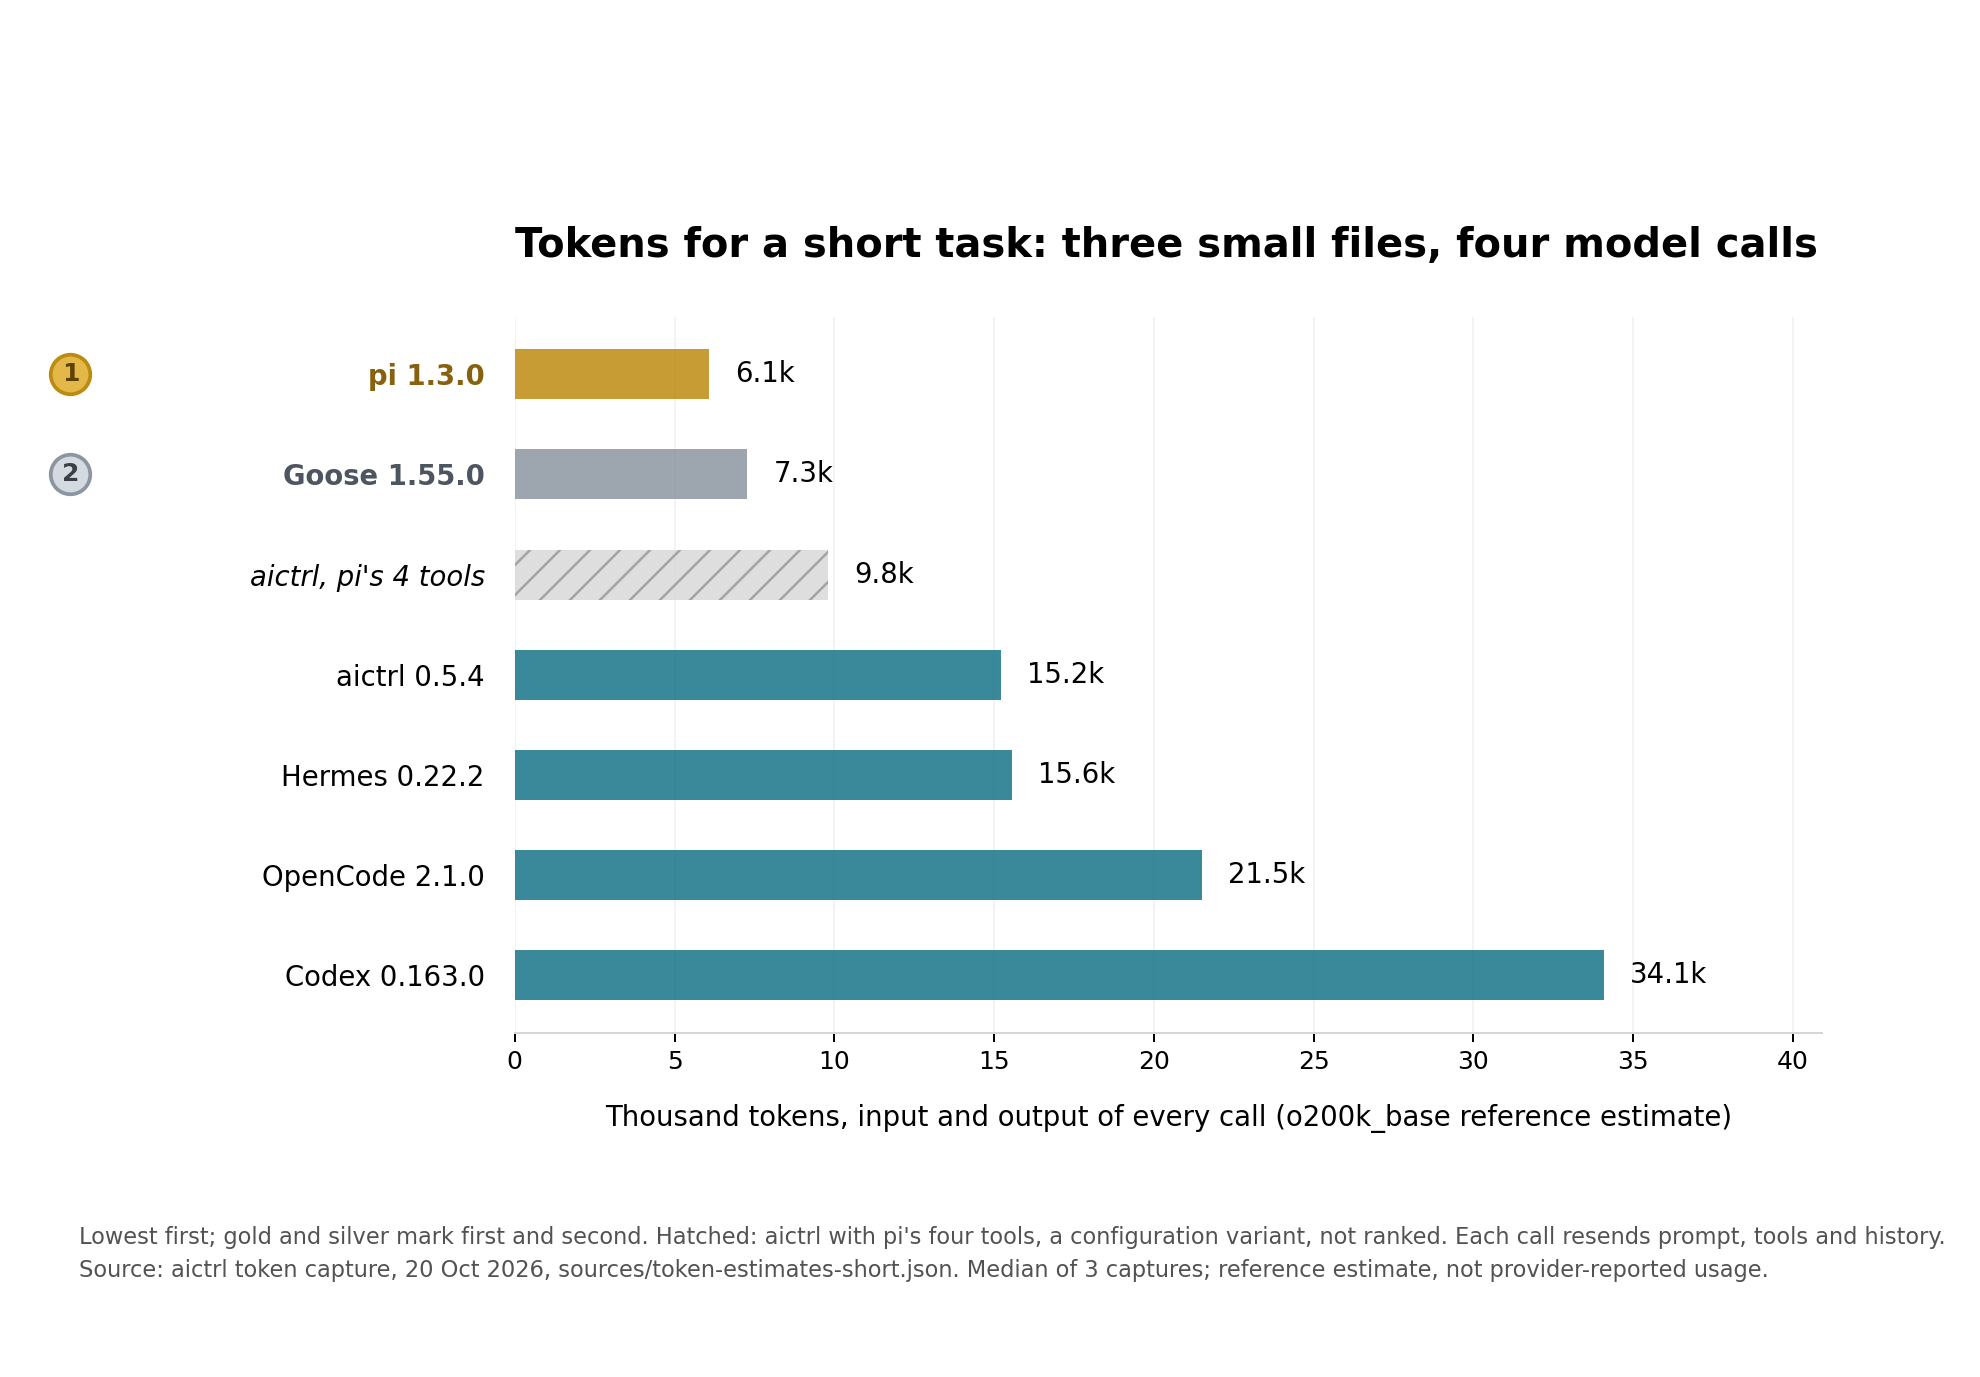
图 7。来源:短任务的 token 估算,统计每次调用的输入与输出,所有框架均使用 o200k_base。每个各采样三次;只有 Codex 有波动,最多相差 51 个 token 的注入环境上下文。未计入提示缓存折扣。
pi 完成整个任务用了 6,074 个 token,Goose 用了 7,281。aictrl 用了 15,209,是 pi 的两倍半。换成 pi 的四个工具后,它用了 9,805,也就是说它多出来的五个工具在每次短任务中约耗费 5,400 个 token。Codex 用得最多,34,078 个:仅第一次请求就有 8,178 个 token,其中一半是系统提示,而每次调用都会把它重复一遍。
长任务则不同:读工具返回的内容比提示词更占分量。读取我们测试文件的 800 行,在 aictrl 里要花 11,299 个 token,OpenCode 为 11,276,Hermes 为 12,111——它们会给返回的每一行编号;相比之下,pi 和 Goose 返回原始文本,只花 9,661。在 50 次读取的会话中,每次调用都会重发此前所有文件,差距因此不断累积:aictrl 总共发送了 1,460 万个输入 token,pi 为 1,240 万。
底层机制
为什么有些框架会给读到的每一行编号
代理读取文件时,由框架决定模型最终收到什么文本。pi 和 Goose 原样返回文件内容;aictrl、OpenCode 和 Hermes 则在每行前面加上行号:
pi、Goose:原始文件
aictrl、OpenCode、Hermes:带行号
为什么要标行号?纯文本里数行号,模型很容易出错。把行号摆在它眼前,它就能精确引用 cart.py:42,代码审查者想在正确行上留评论、想编辑或重读某个精确区间,都靠这个。没有行号,智能体只能跑 grep -n 或者瞎猜。
代价是什么。 每行大约两个 token,只要文件还留在历史里,之后每次调用都要再付一遍。我们的测试文件行都很短,所以这个开销显得最高,约 17%;放到普通源码上占比会小一些。这份精度到底值不值这个价,要看我们跑真实模型的结果。
Codex 在长读取上没法直接比。它把每个 48 KB 的文件砍到约 10 KB,所以它那个 50 次读取的会话一共只发了 320 万输入 token,是其他几个的四分之一。
有了提示缓存(prompt caching),服务商对大部分重复发送的历史按折扣计费。但 token 仍然占着上下文窗口,也仍然增加预填充时间。真实模型那一轮会报告计费用量,包含缓存命中。
我们还在意一个任务要花多少个模型回合。aictrl 的工具说明要求模型把互相独立的工具调用批量合并。一个回合里读三个不相干的文件,就能省掉多余的模型往返。
这是个值得评估的设计选择。它并不能说明 pi 不会批量,也不能说明 aictrl 需要的回合更少。抓到的请求显示,Goose 和 Hermes 也带了类似的指引,要么高效读取,要么批量合并独立调用。在这里,是脚本化的模型决定了执行顺序,跟这些指令无关。
我们另外做的工具文本实验,并不是 aictrl 对 pi 的直接回合数比较。两个初始对比组都保留了批量指引,所以没法单独看出去掉它的效果。要下这个结论,我们需要同一个真实模型、同一批任务、经过验证的结果、模型回合数、每回合调用数、服务商报告的 token 用量和耗时。提示词和工具描述里的每一个 token,都该靠实测行为来证明自己配得上这个位置。
事件流:流水线能读到什么
工作流不会去盯着终端屏幕。它读的是 harness 写入标准输出(stdout)的内容,因此这个流的形态,决定了你能记录什么、计费什么、调试什么。六个 harness 都能输出按行分隔的 JSON(newline-delimited JSON),我们让每一个都在开启该模式下跑了一遍。但各自流里携带的内容并不相同:
-
流是否干净。 Goose 在第一个 JSON 事件之前,会先往 stdout 打一段四行的文字横幅,所以 jq 这类按行解析的工具必须先跳过非 JSON 行。其余五个只写 JSON。
-
每次模型调用的 token 数。 aictrl 和 pi 每次调用都会报告输入与输出 token,OpenCode 除最后一次外都报告。Goose、Codex 和 Hermes 只在结束时报告一次会话总计。
-
工具耗时与权限决策。 aictrl、pi、OpenCode 和 Hermes 会记录每次工具调用的耗时。但只有 aictrl 记录了是哪条权限规则放行了每次调用。
我们以脚本模型自己对那个短任务的记录为基准,给每个流打分:每次运行 25 条事实,参照 OpenTelemetry GenAI 的属性设计,只有当流中明确写出、且数值一致时才计入。aictrl 和 pi 覆盖了全部 25 条,OpenCode 80%,Hermes 72%,Goose 68%,Codex 40%。aictrl 的流是我们自己设计的,看这个成绩时请把这一点考虑进去;打分脚本已经公开。
有些团队更希望把 span 送进自己的追踪系统。Codex 和 Goose 会导出带 token 用量的 OpenTelemetry span,Codex 还把大部分细节放在 span 里,而不是 JSON 流里。OpenCode 会为内部操作导出 span。aictrl、pi 和 Hermes 按默认安装则什么都不导出;对 aictrl 来说,这是目前的一个缺口。
我们接下来要改什么
对 aictrl 来说,npm 安装体积、系统提示词和每轮测试框架耗时现在都接近我们测到的最小值。还剩两项 token 成本:工具定义体积是 pi 的四倍多,导致短任务成本高出两倍半;带行号的读取输出——我们为了精确引用和编辑而保留,但会实际测量它的开销。我们计划把子代理、网页和技能工具改为按需启用(不需要的步骤不加载),并缩短剩余描述。启动时间和跨步骤保留的内存也还要继续调查。下一轮对比会用真实模型,同时测量任务成功率、每个任务的轮数和服务商上报的 token 数。
对容器自动化来说,这次实验给出了新进程开销、安装体积,以及在特定输出保留策略下的内存占用。这些是选型的有用输入,但还要结合真实任务质量和流程所需工具一起看。奖牌对应的是各自独立的指标。pi 在八项中拿了七个第一或第二;aictrl 在四项中排第二:会话时间、每轮时间、内存和镜像体积。
如果想在开销之外评估编码任务质量,可以看 SWE-EVO 基准测什么,以及在你自己的任务上做提示词对比。这些是独立的评估;我们的脚本化实验不会给任何 CLI 打出 SWE-EVO 分数。
总结
每项指标都是数值越低越好。¹ 和 ² 标出每行实测最低和次低的结果。aictrl(我们自己的 CLI)列在最前,其他列按奖牌数排序。pi、Goose 和 Hermes 运行时精简了工具集,且不加载子代理工具,这在 token 相关行上对它们有利;aictrl 的结果用的是默认的九个工具。
| 指标 | aictrl | pi | Goose | Codex | OpenCode | Hermes |
|---|---|---|---|---|---|---|
| 首次响应,中位数(毫秒) | 579 | 522 | 1392 | 2471 | 926 | 5,521 |
| 会话时长,中位数(秒) | 24.27 | 13.98 | 7.22 | 5.57 | 6.03 | 12.76 |
| 每轮 harness 时间,中位数(毫秒) | 212 | 19 | 72 | 45 | 32 | 64 |
| 峰值 cgroup 内存,中位数(MiB) | 2207 | 1154 | 247 | 132* | 424 | 344 |
| 镜像增量(MiB) | 2113 | 1108 | 292 | 410 | 818 | 388 |
| 系统提示词(token) | 608 | 2601 | 1563 | 4,047 | 1,857 | 1,053 |
| 首次请求(token) | 3,442 | 11,276 | 21,577 | 8,178 | 4,903 | 3,391 |
| 短任务,全部调用(token) | 15,209 | 16,074 | 27,281 | 34,078 | 21,489 | 15,562 |
| 一次读取 800 行(token) | 11,299 | 9,661 | 9,661 | 2,159* | 11,276 | 12,111 |
| 每会话模型调用次数(脚本化) | 51 | 51 | 51 | 51 | 52 | 52 |
| 能力(按测试时的配置) | ||||||
| 子代理工具 | 有 | 无† | 无† | 有 | 有 | 无† |
| 带行号读取 | 有 | 无 | 无 | 无 | 有 | 有 |
| 长读取时保留整个文件 | 有 | 有 | 有 | 无* | 有 | 有 |
| 搜索工具(glob、grep) | 有 | 无 | 无 | 无 | 有 | 有 |
| 网页工具 | 有 | 无 | 无 | 有 | 有 | 无† |
| 事件流(按测试时的配置) | ||||||
| 事件覆盖(25 项事实) | 100% | 100% | 68% | 40% | 80% | 72% |
| stdout 上的 JSON 事件 | 有 | 有 | 有‡ | 有 | 有 | 有 |
| 每次模型调用的 token | 有 | 有 | 无 | 无 | 有 | 无 |
| 每个事件都带时间戳 | 有 | 无 | 无 | 无 | 有 | 有 |
| 工具开始与结束时间 | 有 | 有 | 无 | 无 | 有 | 有 |
| 权限决策信息 | 有 | 无 | 无 | 无 | 无 | 无 |
| OpenTelemetry 导出 | 无 | 无 | 有 | 有 | 有§ | 无† |
*Codex 在长读取时只保留首尾各约 80 行,因此它的内存和读取大小不能直接拿来比较,不参与排名。
†功能可用,但在我们测试的配置里处于关闭状态。
‡Goose 在输出 JSON 事件之前,还会先往 stdout 写一段文本横幅(banner)。
§只有内部 span,不含 token 或模型属性。
数据来源。 保存的测量结果,以及据此计算出的 CSV 文件。启动测试:每个测试框架各跑 20 次,20/20 全部完成;内存测试:六款工具各完成 5/5。版本和运行时配置见上文。会话时长、每轮耗时和模型调用次数:见会话测量。Token:token 估算值、短任务和每次读取的 o200k_base 参考计数,来自另一轮独立采集,并非服务商实际计费的使用量。
奖牌。 奖牌反映的是实际观测结果;前四名的启动中位数非常接近,本次实验不足以确立一个稳定的总冠军。对于人为设定的调用次数、读取大小(用 token 换行号)、事件覆盖范围,都不颁发奖牌。cgroup 内存包含计入的缓存。
能力。 各测试框架在本次运行中向模型声明的工具;pi 和 Goose 通过各自的 shell 工具完成搜索和读取。pi 在软件包里附带一个 subagent 扩展,Goose 和 Hermes 的默认工具集都加了 subagent(Hermes 还包含网页工具)。
事件流。 每个测试框架开启 JSON 输出标志后写出的、以换行分隔的 JSON 数据,六款工具全都打开了该标志。Goose、Codex 和 Hermes 只在结束时把 token 作为会话总量报告一次;pi 给消息打了时间戳,但轮次和工具事件没有。Goose 会输出文本横幅,解析器必须跳过非 JSON 行。
OpenTelemetry。 测试方法是把每个 CLI 指向本地 OTLP 接收端,使用标准的 OTEL_EXPORTER_OTLP_* 设置,再加上 Codex 的 [otel] 配置段,以及 aictrl 和 OpenCode 里的 experimental.openTelemetry 开关。Goose 和 Codex 发送的 span 在 GenAI 属性里带有 token 计数;OpenCode 的 span 覆盖其内部操作;Hermes 需要可选的 otlp 扩展,而我们的安装没有包含。aictrl 有这个开关但还没有 exporter,所以什么都没发出去。
事件覆盖
每条 JSON 流都与脚本模型自身记录的任务过程比对评分:每次运行包含 25 项事实,参照 OpenTelemetry GenAI 属性设计(会话与模型;四次模型调用的 token 和时间戳;三次工具调用各自的名称、文件、调用 ID、完整结果与耗时;运行结束、token 总计和最终答案)。只有流中明确写出且值匹配,才计为一项事实;三次运行得分相同。aictrl 的流由我们自己设计,因此该行不计入排名;评分清单和评分器已连同分数一并公布。Codex 在 OpenTelemetry 导出中保留的细节比其 JSON 流更多。
来源与复现
-
各次运行的测量数据、完成计数和源码哈希。
-
计算表格与测量定义。
-
运行器、数据和复现说明,代码采用 MIT 许可,数据采用 CC BY 4.0 许可。
-
镜像、运行时和安装元数据,含 aictrl 0.5.4 和 OpenCode 2.1.0 构建版本。
-
主机规格与基础镜像摘要。
-
Token 采集活动及其逐请求 token 计数;短任务自身的采集与 token 计数,以及 aictrl 启用四个工具时的 token 计数。
-
活动溯源信息。
所有数字均来自我们自己的测量。链接的源码说明仅用于解释批处理建议,不提供基准测试结果。
我们 CLI 的设计原则与功能详见 aictrl headless agent harness 页面。要在终端或 GitHub Actions 任务中运行,请参阅 CLI 快速上手。