为什么我们还在只为人类开发应用?
设想一下:你让 AI 费用管理应用修改上周提交的一笔报销金额,它真的改了。
问题在于,这笔报销已经审批通过,本该锁定,不能再改。从 UI 操作绝不会出现这种情况:界面调用的接口会检查审批状态。但智能体走了另一条路,没有经过这项检查。
当我们开始开发同时供人类和 AI 智能体(AI agent)使用的应用时,这个问题必须认真考虑。除了把界面做得直观好用,还要保证这些新用户——AI 智能体——遵守同样的规则。
UI 优先的应用
以一个应用为例。UI 是最直观的入口:用户操作前端,前端把请求发给后端,后端处理业务逻辑和数据。
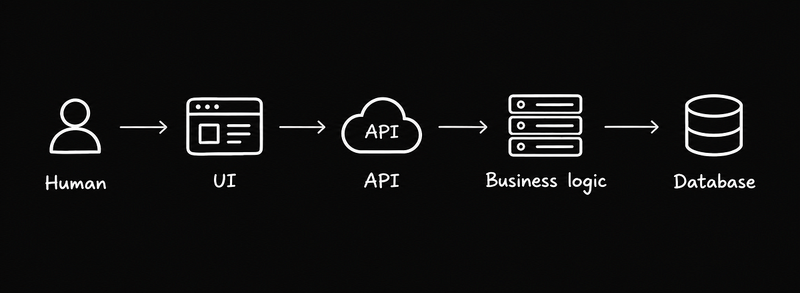
典型应用里,这些操作背后的逻辑放在 API 路由、控制器、服务或前端调用的函数中。UI 是主要调用方时,这没问题;但智能体可能需要完全绕过 UI 执行同样的操作。
于是问题来了,传统 UI 优先架构对此回答得并不好:怎样保证每个调用方都走同一套应用逻辑、遵守同一套规则?
一个能力,多个调用方
还是以这个费用管理应用为例。用户可以通过 UI 修改报销,智能体也能在收到“把我上周的酒店报销改成 300 美元”这样的请求后完成同样的修改。以后,外部集成系统可能也需要修改报销。
动作是同一个,但每个调用方抵达它的路径可能不同:
- UI 调用 HTTP 接口
- 智能体调用工具
- 命令行(CLI)执行命令
- 外部集成使用另一套 API 契约
每条路径都可以有自己的校验规则、权限和错误处理。时间一长,这些实现就会各自跑偏——同一个操作,有的调用方能执行,有的却被拦住。
Agent-Native 的思路
Agent-Native 的出发点不同。它不把 UI 当作主要入口,而是把应用能力放在中心位置。
在 Agent-Native 里,这种能力用「动作」(action)来表示。动作定义了这项能力的输入、校验规则和行为。
同一个动作,可以按需暴露给不同的入口:UI、智能体、HTTP、MCP、A2A 和 CLI。
以我们的费用管理应用为例:只需定义一次 update-expense 动作,UI、智能体或其他入口都可以调用它。
各入口的表现形式仍然可以不同。UI 弹出一个表单,智能体调用一个工具,HTTP 客户端发一个请求。界面在变,但应用逻辑始终集中在一处。
为什么不直接把 API 交给智能体?
直觉上可能会觉得,给智能体暴露一个 API 就解决了。但 API 只告诉调用方怎么发起操作,并不能保证每个调用方都遵守同样的校验、权限、数据范围和业务规则。
还是拿费用管理来说。给智能体一个更新费用的接口并不难。但应用仍然要检查:用户有没有权限修改这笔费用、这笔费用是否已经审批通过、请求的修改是否被允许。
这些规则不该关心调用者是人还是智能体。
智能体需要应用上下文,而不只是工具
让智能体访问动作很有用,但这只是一部分。如果智能体只拿到一串可调用的动作列表,它可能缺少 UI 早已掌握的上下文。
比如你正在看一份费用报告,对智能体说「更新这份报告里的酒店费用」。哪份报告?哪笔酒店费用?UI 知道你正在看哪份报告、选中了哪笔费用。但如果不把上下文传给智能体,它就只能自己去猜。
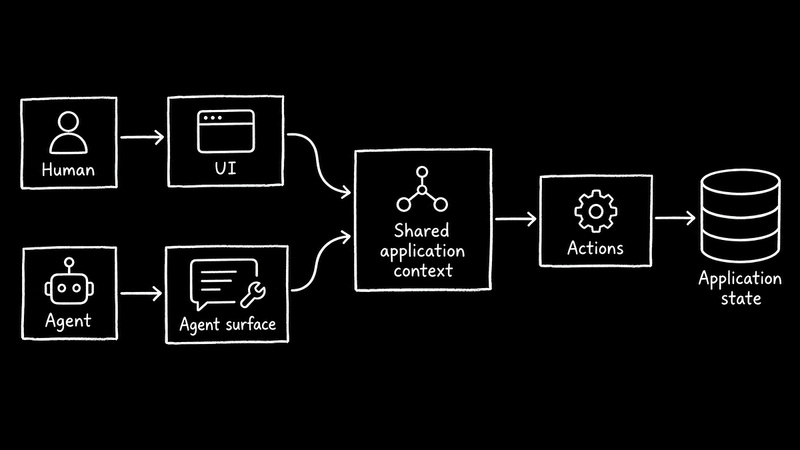
智能体需要知道用户正在处理什么,以及用户有权对它做什么。
在 Agent-Native 中,UI 会以应用状态的形式共享这些上下文,比如当前视图和选中的记录。这样智能体就能知道你说的到底是哪一笔酒店费用。
那还需要 UI 做什么?
Agent-Native 并不等于只有智能体。
有些事情人直接做更擅长,UI 仍然有用:比较选项、编辑内容、处理视觉信息、与他人协作等等。
智能体可能准备好一组改动,但用户可能仍想在表格里检查一遍、修改其中一项,然后批准最终结果。
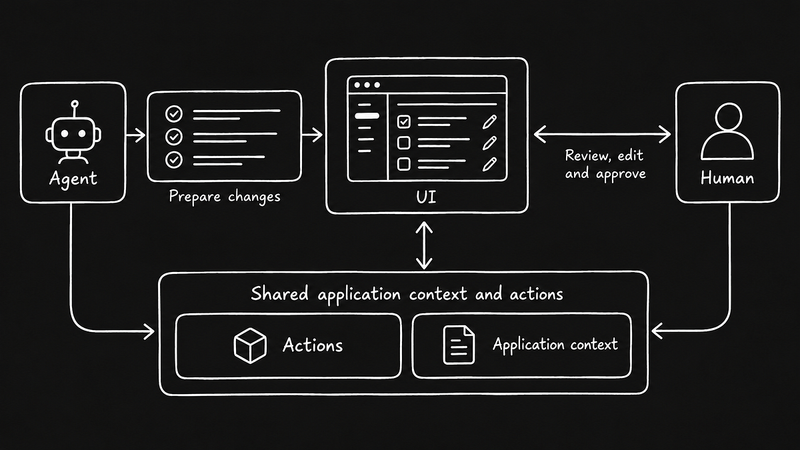
所以,在 Agent-Native 应用中,UI 仍然扮演重要角色。它不再是进入应用的唯一方式,而是建立在同一套底层能力之上的界面之一。
从 action 开始
不必第一天就把每个 action 都通过 UI、HTTP、MCP、A2A 和 CLI 暴露出来。
先定义 action:它做什么、接受哪些输入、谁能调用、能访问哪些数据。然后让这个 action 通过真正需要的界面提供服务。
默认情况下,这个 action 对 UI 和智能体可用,也能通过 HTTP、MCP、A2A 和 CLI 使用。需要做的是决定在不需要访问时关掉哪些界面。
这样就能支持多种与应用交互的方式,同时把底层逻辑集中在一处。
那代码里长什么样?
下面是我们如何定义前面例子中的 update-expense action,文件放在 actions/update-expense.ts:
export default defineAction({
  description: "Change the amount of an expense that hasn't been approved.",
  schema: z.object({
    expenseId: z.string(),
    amount: z.number().positive(),
  }),

  run: async ({ expenseId, amount }) => {
    const db = getDb();
    const expense = await db.query.expenses.findFirst({
      where: eq(expenses.id, expenseId),
    });

    if (!expense) {
      throw new Error("Expense not found");
    }

    if (expense.ownerEmail !== getRequestUserEmail()) {
      throw new Error("Not allowed to edit this expense");
    }

    if (expense.status === "approved") {
      throw new Error("Approved expenses cannot be edited");
    }

    await db
      .update(expenses)
      .set({ amount })
      .where(eq(expenses.id, expenseId));

    return { id: expenseId, amount };
  },
});
description 告诉智能体这个 action 是做什么的,schema 定义输入,run 负责执行更新并做权限检查。UI 和智能体都可以调用这个 action,所以无论从哪边来,修改已审批费用的请求都会被拒绝。
Agent-Native 在这里派上用场
这套架构你可以自己搭。用 TanStack Start、Rails 或 Next.js 这类常规技术栈,先把业务逻辑集中起来,再分别加上智能体工具、HTTP 路由、MCP 服务器、CLI 命令等等。架构本身能跑通,但这些接口之间的一致性得由你自己维护。
Agent-Native 则从共享的 action 本身出发。这个 action 承载应用行为、校验、权限和数据访问,框架可以从同一个来源把它开放给 UI、智能体、HTTP、MCP、A2A 或 CLI。
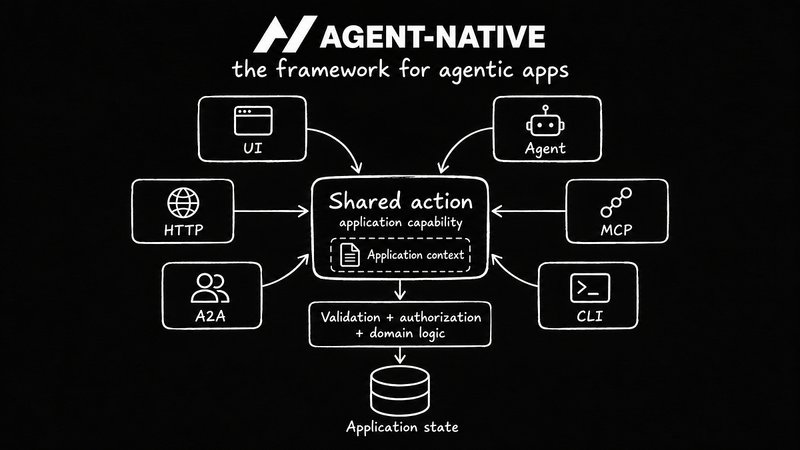
Agent-Native 把 action 当作应用边界,团队可以复用或扩展现有的 action,不必为同样的行为再建一个路由或工具。
入门很简单,也可以直接到 GitHub 上浏览源码。